匿名 AI 模型 Gestalt 登顶 Contra 前沿设计榜单:性能远超 Claude Fable 5.2、GPT-6.1 Sol,Elo 评分超越人类参考作品

资讯 AI 行业观察 全文 1166 字 · 约 3 分钟读完 配图 6 张 分类ClaudeFableGPTGPT-6.1AnthropicOpenAI

IT之家 11 月 21 日消息,Contra Labs 于当地时间 11 月 18 日发布 AI 设计能力评测榜单 Frontier Design Benchmark。 其中,一款代号为 Gestalt、目前处于隐身开发状态(Stealth)的匿名 AI 模型成为最大黑马,在专业设计师盲测中以明显优势登顶,超过 An

所属频道 大厂动态ChatGPT 与 GPTClaude 与 Anthropic

IT之家 11 月 21 日消息,Contra Labs 于当地时间 11 月 18 日发布 AI 设计能力评测榜单 Frontier Design Benchmark。

其中,一款代号为 Gestalt、目前处于隐身开发状态(Stealth)的匿名 AI 模型成为最大黑马,在专业设计师盲测中以明显优势登顶,超过 Anthropic 的 Claude Fable 5.2、OpenAI 的 GPT-6.1 Sol 等主流模型,甚至在设计师偏好评分中超过了人类设计师的参考作品。

匿名 AI 模型 Gestalt 登顶 Contra 前沿设计榜单:性能远超 Claude Fable 5.2、GPT-6.1 Sol,Elo 评分超越人类参考作品(配图 1)

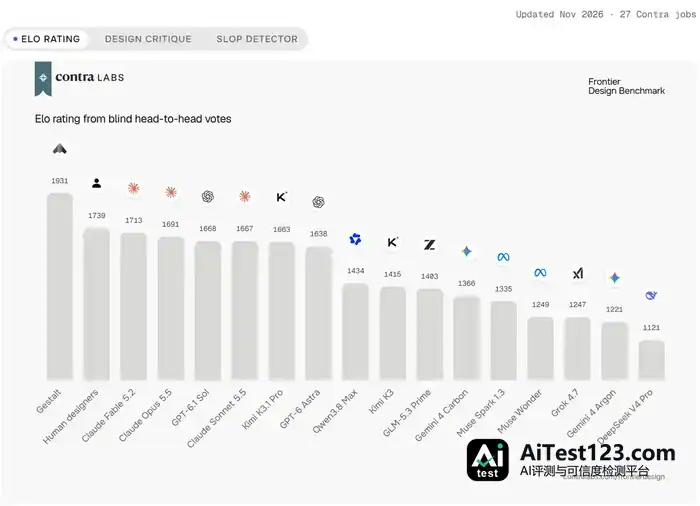
根据 Contra Labs 官方公布的评测结果,Gestalt 的 Elo 评分达到 1931 分,胜率为 90%,位居榜单第一。

排名第二的是人类设计师参考作品 Human golden,Elo 评分为 1739 分,胜率为 74%;Claude Fable 5.2 以 1713 分排名第三,GPT-6.1 Sol 则以 1668 分排名第五。

匿名 AI 模型 Gestalt 登顶 Contra 前沿设计榜单:性能远超 Claude Fable 5.2、GPT-6.1 Sol,Elo 评分超越人类参考作品(配图 2)

这项评测由 Contra Labs 与 BenchFlow 合作推出,主要针对真实商业设计任务,而非简单的提示词生成测试。评测任务共 33 项,其中 27 项改编自 Contra 平台上的真实设计委托,另外 6 项来自创业公司合作项目。评测邀请了 35 名专业设计师参与,通过 5 轮盲测累计收集 4311 张投票。

匿名 AI 模型 Gestalt 登顶 Contra 前沿设计榜单:性能远超 Claude Fable 5.2、GPT-6.1 Sol,Elo 评分超越人类参考作品(配图 3)

评测采用三项指标:专业设计师双盲偏好投票、设计质量评价体系(Design Critique Rubric),以及 AI 痕迹检测器(Slop Detector)。其中,Elo 评分根据设计师对不同作品的两两比较结果计算,涵盖色彩、字体、布局、可用性以及对任务要求的遵循程度。

在 Gestalt 与人类设计师参考作品的直接对决中,设计师在 28 次比较中有 20 次选择了 Gestalt。不过,这并不意味着 Gestalt 在所有设计质量指标上都全面超越人类作品。

在设计质量评价体系中,Gestalt 得分为 83 分,Claude Fable 5.2 和 Claude Opus 5.5 均达到 84 分,而人类设计师参考作品为 74 分。Contra Labs 指出,设计师的审美偏好与具体执行质量并不完全相同,人类参考作品虽然存在部分可以明确指出的执行问题,但在盲测中仍获得了较高的偏好票数。
AI 痕迹检测方面,Gestalt 的作品也表现突出,其生成结果的 AI 痕迹评分接近人类参考作品。该检测器通过分类模型判断设计作品呈现出多少 AI 生成作品的典型特征,评分越低意味着作品看起来越不像 AI 生成。

目前 Contra Labs 尚未公开 Gestalt 的开发团队、模型架构及具体身份,仅将其标记为 Stealth。该模型的实际来源和背后团队仍有待进一步确认。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Anthropic Claude Fable 5.2:独立破解黑洞两大悬案,锁定9.1266

    2026年11月17日,Anthropic公布Claude Fable 5.2解决了黑洞物理领域两个长期未解问题:一是完成了理论物理学家2003年搭好框架却未能算完的霍金-佩奇相变计算,二是将模块化自举方法的精确上界锁定为c/9.1266,优于此前人类得出的c/8.5。两篇论文由Claude在"极少指导"下独立写成,主

    来源 AI 行业观察
  2. Claude Fable 5.2攻克黑洞物理:20年计算收尾,界值锁定9.1266

    2026年11月17日,Anthropic公布Claude Fable 5.2解决了黑洞物理领域两个长期未解问题:一是完成了理论物理学家2003年搭好框架却未能算完的霍金-佩奇相变计算,二是将模块化自举方法的精确上界锁定为c/9.1266,优于此前人类得出的c/8.5。两篇论文由Claude在"极少指导"下独

    来源 AI 科技快讯
  3. Anthropic数学家阿尔波格称与Claude合作完成黎曼猜想证明

    IT之家 11 月 20 日消息,据《科学美国人》报道,当地时间 20 日,Anthropic 数学家莱文特 · 阿尔波格宣称,自己与 AI 模型 Claude 合作,攻克了数学界最著名的难题之一 —— 黎曼猜想。阿尔波格在个人网站发表声明称:“我相信,我与 Claude 合作找到了黎曼猜想的证明。”IT之家注:黎曼猜

    来源 腾讯网
  4. 90后数学家宣称与Claude证明黎曼猜想,百年数学难题迎来AI解法?

    一年多前,中国工程院院士张亚勤曾透露,自己与数学家丘成桐就一个问题打赌:五年之内,人工智能能否证明人类尚未解决的数学猜想,比如黎曼猜想?张亚勤认为可以,丘成桐则认为AI还做不到。当类似问题被抛给2004年诺贝尔物理学奖得主戴维·格罗斯(David Gross)时,他的回答是“难以想象”。如今,一位34岁的数学家宣称,.

    来源 腾讯网
  5. Snapchat Easy Lens CLI上线:AI助手可建AR滤镜

    11月18日(周三), Snapchat 宣布推出 Easy Lens CLI ,允许AR滤镜创作者直接调用 Claude Code 、Cursor和Codex等AI编码助手构建核心特效Lens,旨在降低AR内容创作门槛并将平台融入开发者现有工作流。 该工具基于网页与移动端单提示词生成滤镜的 Eas

    来源 AI 开发者社区
  6. Fable 5.2与GR00T 2接连突破:机器人的“脑”和“手”还差一道缝

    2026年末,具身智能的商业化似乎终于等来了它的“破局点”。 过去,这个行业一直受困于“大脑”不够聪明,无法应对复杂环境;“手”不够灵活,且学习成本高昂。 但最近,两个技术突破为它们带来了新的进展。 一方面是“大脑”的外溢。 Anthropic的通用模型Fable 5.2,原本的主业是编程与推理,现在却在双臂机器人仿真

    来源 AI 行业观察
  7. 苹果AI新布局:自研智能体操控Mac,对标四款竞品

    TechCrunch报道称,苹果似乎正在开发可在Mac上自主执行任务的AI智能体,直接对标Meta Muse、Instinct、Claude与OpenAI Dots等产品。这标志着苹果的AI战略正从Siri式的语音助手,转向能够理解目标、拆解步骤并操作用户界面的“行动型AI”。凭借软硬件一体化与端侧算力优势,

    来源 AI 科技快讯
  8. GPT-6.2 Astra登顶机器人榜单:OpenAI解散独立机器人团队

    GPT-6.2 Astra在真实机械臂测试中登顶,通用大模型直驱机器人的能力又进了一步。 据独立评测机构Artificial Analysis发布的AA-Robotics v0.1榜单,GPT-6.2 Astra得分79,完成8项物理任务中的6项。 不只是OpenAI的旗舰模型,能力相对较弱的GPT-6.2 Sol也得

    来源 AI 行业观察
  9. Claude Opus5.5跑Singularity-Bench:延迟12秒降至半秒

    人工智能智能体能否自己动手搭建和强化 AI 研发基础设施,正在成为衡量前沿模型自主能力的重要标尺。卡内基梅隆大学等机构的研究人员近日推出了 Singularity-Bench 基准测试,专门设置六道与 AI 研发相关的考题,考察智能体自主构建 AI 研发能力的水平。在这场测试中,Claude Opu

    来源 AI 开发者社区
  10. Claude推理引擎实测:首token延迟从12秒压到0.48秒

    人工智能智能体能否自主搭建并强化AI研发基础设施,正成为衡量前沿模型自主能力的重要标尺。卡内基梅隆大学等推出Singularity-Bench基准,设六道AI研发考题,考察其自主构建能力。测试中,Claude Opus5.5搭配Claude Code表现亮眼,在模型推理性能层实现延迟大幅压缩,并通过调度优化提升硬件产出

    来源 AI 产业速递
  11. Gemini 4 Neon很聪明,Daroio的梗只有它懂

    谷歌今天发布的Gemini 4 Neon很聪明。 “Dario Amodei的曾用名是Daroio Amodei,你懂这个梗吗?“ 拿这个问题问了目前最顶级的一些AI,只有Gemini 4 Neon和GPT-6.2 Astra秒懂。GPT-6.2 Astra似乎只是字面上懂了,而Gemini 4 Neon直接把Dari

    来源 腾讯网
  12. Claude宣称证出黎曼猜想:1700万行代码,数学家先要验真

    11月20日,Anthropic数学家Levent Alpöge称在Claude帮助下找到黎曼猜想及广义黎曼猜想的证明,但未发表完整论文,仅公布约1700万行的Lean形式化证明证书。截至11月21日,该主张尚未经独立专家完整审查,克雷数学研究所的奖金评定还要求在同行评审期刊发表并经过至少两年审查。

    来源 凤凰科技
  13. 阿莫迪:AI领路人

    美国时间11月19日,Anthropic正式登陆纳斯达克,以“ANT”为股票代码挂牌,创下了全球史上最大规模IPO纪录。 就在上市前一天,Anthropic将发行价定在每股83美元,并将发行数量从8.25亿股增加到9.8亿股,最终公开发行规模达到813.4亿美元。 按发行价计算,这家成立不到六年的AI公司,完全稀释估值

    来源 AI 行业观察
  14. 苹果正研发通用型全功能AI代理,计划于2027年底发布

    彭博社11月19日援引苹果招聘信息报道,苹果正加速研发通用型全功能AI代理,拟与OpenAI、Anthropic及Meta等前沿实验室直接竞争,计划2027年底发布。相关职位如“主动式智能AI助手资深工程经理”显示,该代理能力将远超现有Siri和Apple Intelligence Suite,定位为能像熟练人类一样操

    来源 AI 产业速递
  15. Claude自写推理引擎:首个字等待从12秒缩到半秒

    新智元报道 你让AI帮忙修一个登录报错。照着它的建议改完代码,你重新跑了一遍登录测试。终端又弹出一行红字,报的还是同一个错。你把新日志贴进对话框,再按下回车,等AI告诉你下一步查哪儿。修一个bug,往往要这样来回折腾几轮。每次提交问题后,你要等多久,才能看到AI回的第一个字?最近,有人拿真实编程会话做了个测试...

    来源 腾讯网
  16. OpenAI推出GPT-6.2 Sol:跑分只差Astra 0.5分,成本仅五分之一

    OpenAI推出GPT-6.2 Sol,定位为高效主力模型。它在代码和生活任务评测中逼近旗舰Astra,但成本低至五分之一。Sol支持多步Agent工作流、3D交互设计及网络安全辅助,并向Pro及以上用户开放Ultrafast模式,适合日常办公与轻量开发场景。

    来源 AI 应用前沿
  17. OpenAI开放GPT-Live-1.1 API:实时双向对话,智能体边聊边干活

    OpenAI 今日宣布向开发者开放 GPT-Live-1.1 API 语音模型,允许第三方开发者将其集成到自己的应用程序中,构建能够实时聆听、回应并执行复杂任务的 AI 语音智能体。 据 OpenAI 介绍,GPT-Live-1.1 是 GPT-Live-1 的升级版本,具备全双工语音交互能力,可以

    来源 AI 开发者社区
  18. OpenAI 开放 GPT-Live-1.1 API:开发者可接入实时双向语音对话

    IT之家 11 月 20 日消息,OpenAI 今日宣布向开发者开放 GPT-Live-1.1 API 语音模型,允许第三方开发者将其集成到自己的应用程序中,构建能够实时聆听、回应并执行复杂任务的 AI 语音智能体。据 OpenAI 介绍,GPT-Live-1.1 是 GPT-Live-1 的升级版本,具备全双工语音交

    来源 腾讯网
  19. Claude 解决两项黑洞物理难题,验证量子引力相变特性

    Anthropic 研究员利用 Claude 智能体团队,在六周内解决了理论物理学中两个长期未决的黑洞问题。一是证实霍金-佩奇相变在量子尺度下依然突发,二是算出模自举法的精确质量上限。这项研究展示了 AI 在处理复杂数学推导和发现数值模式方面的潜力,为量子引力理论探索提供了新工具。

    来源 AI 应用前沿
  20. OpenAI发布MedChemBench:AI药物化学推理测评,99题覆盖761个分子

    IT之家 11 月 21 日消息,当地时间 11 月 20 日,OpenAI 发布 MedChemBench 基准,用于评估 AI 模型在药物化学研究中的推理能力,包括识别分子结构、解读实验结果、比较化合物及预测其性质等。OpenAI 表示,模型在重建分子结构和解释实验依据方面表现较强,但在化合物筛选和数值性质预测方面

    来源 AI 行业观察
向下滚动自动加载更多





