Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计

资讯 AI 开发者社区 作者:编程导航 全文 4115 字 · 约 11 分钟读完 配图 13 张 分类Nano BananaGoogle产品更新模型发布DeepMind

机器之心编辑部 Nano Banana 2 推出几个月之后,谷歌终于更新了这条产品线。 就在今天凌晨,Google DeepMind 正式发布 Nano Banana 2.1。 从命名看,这只是一次「0.1」级别的升级,但谷歌给出的评价相当直接:新版在此前 Nano Banana 系列基础上进一步提升,重点变化集中在视

所属频道 大厂动态产品更新模型发布视频图像生成
Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 1) 机器之心编辑部

距离 Nano Banana 2 面世才过去几个月,谷歌就把这条产品线又往前推了一步。今天凌晨,Google DeepMind 正式放出 Nano Banana 2.1。


名字上只是「0.1」级别的小幅改动,可谷歌对它的说法挺直白:新版本是在此前 Nano Banana 系列之上继续做提升,改动主要落在视觉设计、蒙版编辑、主体一致性以及图像自然度这几块。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 2)


但 Nano Banana 2.1 并没有掉头去走另一条路。Flash 级别的速度与成本效率,它照样要;专业图像生成和编辑,它也在继续靠拢。谷歌给它的定位是最新的高效率图像生成与对话式编辑模型。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 3)


Nano Banana 2.1 眼下已经是 Gemini API 里的稳定模型,模型 ID 是 gemini-nano-banana-2.1。谷歌公布的信息显示,它已被分发到 Gemini App、Google AI Studio、Gemini API、Google Search AI Mode、Google Ads、Flow 和 Stitch 这些产品与开发平台。


翻看谷歌公布的模型卡和评测成绩,这次的提升并不只是几个展示案例上的好看。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 4)


模型卡地址:https://storage.googleapis.com/deepmind-media/Model-Cards/Nano-Banana-2-1-Model-Card.pdf


底座这次换成了 Gemini 3.6 Flash,Nano Banana 2.1 也因此归入 Gemini 3 系列。


换句话说,Gemini 原生多模态的那套本事它都继承了下来——文本和图像都能读进去,吐出来的是图像加文本。谷歌给它的定位并不含糊:走的是高效率图像生成和对话式编辑这条路,速度和成本仍然贴着 Flash 那一档,但最终出图的质量往上提了一截。


开发者这边,新模型能出 1K、2K、4K 三种规格。1:4、4:1、1:8、8:1 这些宽幅、超宽幅画面常见的平铺伪影,谷歌也做了针对性处理。多图融合这块,最多可以喂进 14 张参考图,多角色、多物体的一致性也能兼顾。


这些改动指向的方向并不难猜。谷歌想让 Nano Banana 不再停留在「画一张好看的图」,而是变成能反复改、素材能对得上、复杂版式也扛得住的视觉生产工具。


最明显的进步,

先落在「设计感」上。


会画图,和能干设计的活,终究是两码事。


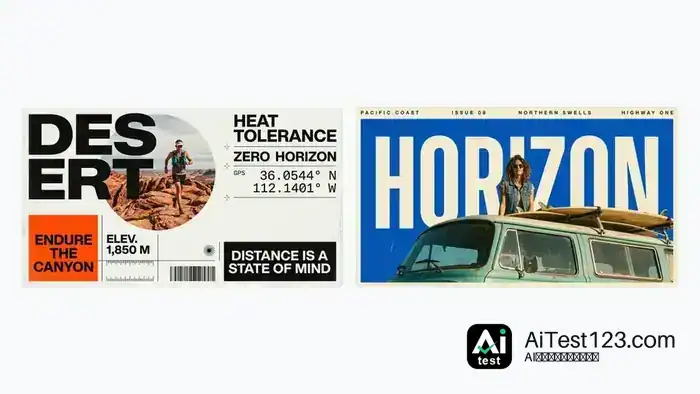
一张宣传海报、一版网页视觉,或者一张复杂信息图,牵扯的东西往往不止一个:排版、字体、留白、层级、颜色,还有多个视觉元素彼此的关系。以前的生成模型,画单个物体没问题,可真让它做完整的平面设计,就容易出岔子——信息层级乱掉、文字位置管不住,或者乍一看元素塞得满满当当,细看却不像一份设计稿。


针对这个痛点,Nano Banana 2.1 的强化相当明显。


谷歌在官方展示里放了瑞士平面设计、复古海报、网页 UI 这几类案例。模型得把整套设计要求吃透,让字体、图片、色块和版式在同一张画面里各就各位,而不是随便生成一个主体交差。

Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 5)


评测数据也印证了这个转向。开启 Thinking 之后,Nano Banana 2.1 的 Infographic Design 得分冲到 1048;对比之下,Nano Banana 2 拿到 961,Nano Banana Pro 是 912。整体偏好这一项,新版拿下 1050,前两款分别是 990 和 935。Google 在这部分用侧对侧人类评价来做,整体偏好和设计质量都通过 Elo 形式来衡量。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 6)


也就是说,这里提升的更像是「成品完成度」。模型不再只盯着某一个生成元素去优化,而是能把一整张视觉作品的结构处理得更稳。放到广告物料、社交媒体配图、海报、电商视觉和 UI Mockup 这些场景里,这种本事比单纯堆画面细节管用得多。


说到 AI 改图,最让人头疼的就是局部编辑。这一环恰好也是本次升级的重头戏。


当初 Nano Banana 能吸引这么多目光,很大一个原因是它把生成和编辑塞进了同一套自然语言交互里。


到了 Nano Banana 2.1,谷歌把最容易翻车的那一环又加固了一遍:基于蒙版的局部编辑,也就是 Mask-based Editing。


局部编辑听着不难,其实对模型的约束相当紧。打个比方,用户把图里某个物体圈出来,想换掉它周围的环境,同时要求主体的位置、尺寸和外观原封不动。模型得同时干两件事:一是准确读懂蒙版划定的范围,二是别去碰画面里本来不该动的地方。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 7)


在 Mask/Ink-Based Editing 这项评测里,Nano Banana 2.1 Thinking 拿到 1049,Nano Banana 2 是 965,Nano Banana Pro 为 927。范围更宽的 General Editing 同样往上走,从此前两款模型的 938、939 提到了 1026。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 8)


生成式图像工具能不能真正融进工作流,跟这项能力直接挂钩。真实的设计场景里,几乎没有「给一句提示词就出终稿」这种事。多数情况是反复做局部改动:背景换掉、产品留住;衣服改掉、人物不动;某一处排版重做,其余部分尽量维持原样。修改范围管得越准,生成模型就越接近 Photoshop 这类传统编辑软件给人的那种确定性。


多个人物摆在一起时,换脸的问题也变小了。另一点进步落在主体一致性上。


就单张图的生成来说,把一个人画得像模像样,如今已经算不上什么稀奇事。难的是连着生成好几张之后,这个人还是同一个人;或者一次塞进多个人物、多件产品,每个主体的特征都别跑偏。角色故事、广告摄影、电商素材、连续视觉内容里,这类麻烦经常出现。


Nano Banana 2.1 在多人场景下的提升格外明显。谷歌的评测数据显示,单角色一致性从 Nano Banana 2 的 981 涨到 1028;多角色一致性则从 978 升到 1106。后一项在整个编辑评测表里都属于差距相当扎眼的一档。即便拿去和 Nano Banana Pro 的 1011 比,Nano Banana 2.1 依然领先。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 9)


谷歌官方给出的示例,是把多名不同模特的参考图拼进同一张时尚大片。这种场景要求模型同时兼顾人物身份、服装、距离、姿态,还有整体的场景关系。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 10)


这套本事其实是在往「素材复用」上走。拍一次、做一组产品图,之后可以搬进别的场景里;已经有的角色,能接着出现在后面的画面中;几个人物也能凑成一件新的视觉作品。放到商业设计里看,主体一致性值钱的地方就落在这儿——生成出来的东西不再是一张张互不相干的图。顺带,那种一眼就能认出的「AI 味」,它还在继续往下压。


Nano Banana 2.1 官方另一个强调的点是 more natural-looking imagery。Google API 文档写得很清楚:新模型在 1K、2K、4K 分辨率下,视觉质量和真实感都有提升。官方给出的样例里有微距昆虫、人物摄影、自然景观、静物,还有绘画作品,落点集中在材质、光线、空间关系和细节够不够自然。


这个方向不太像蒙版编辑那样好量化,可它恰恰决定了生成图第一眼看着像不像回事。以前生成图片常犯的毛病是:局部细节堆得挺满,整体却透着一股过度平滑、过度戏剧化,或者材质全都长一个样的味道。模型一步步走进广告、摄影、电商和内容生产之后,光把画面做「精致」已经不够用了,结果得往真实世界里摄影、材质和光线那种复杂程度上靠。


Nano Banana 2.1 在这方面的加强,跟它的产品定位也对得上:Flash 的速度留着,实际交付的质量往上提。


信息图这条线,谷歌也还在继续下注。


Nano Banana 系列身上还有个很「谷歌」的本事:它能调用 Gemini 的世界知识,还能靠 Google Web Search 和 Image Search 来做 grounding。图像生成这件事,就这么跟 Gemini 的知识和搜索能力接上了。


举个例子,让模型画地球结构示意图、云层分类、面粉种类比较,或者某座历史建筑,它会先把相关知识弄明白,再去组织视觉结构。谷歌把这项能力用在了信息图、教育图示,以及具体真实对象的生成上。


这次模型卡里的数据,同样很值得看两眼。


Infographic Factuality 这一项上,Nano Banana 2.1 Thinking 拿到 0.521,Nano Banana Pro 是 0.265,Nano Banana 2 只有 0.179。该指标的评估工作由谷歌交给 AutoRater 完成。


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 11)


文字渲染方面同样做了进一步打磨。按照谷歌的说法,Nano Banana 2.1 在文字生成和信息图布局这两件事上把准确度提了上来。做海报、做营销物料、做复杂图示,这一改进的作用格外明显。


生成模型眼下正一步步把「查资料 — 理解内容 — 组织版式 — 生成图片」这几步串到一起。放到信息图上,这已经不只是把字画清楚那么简单了。


但图像生成的所有难题,2.1 显然还谈不上全部拿下。


谷歌自己公布的模型卡也列出了 2.1 相当明确的短板。小字号文字依然会糊,1K 输出时尤其如此;长段落和整页文本的渲染效果依旧受限。还有输入图片与生成图片之间的角色一致性,也不是每次都能稳住。


蒙版和涂鸦编辑确实比之前强了,可指令执行不到位、编辑痕迹没清干净的情况还是会出现。有些时候,模型会过分沿用原图里主体的姿态和结构;左右这类空间位置关系,偶尔也会判断错。谷歌同时承认,世界知识、高级 3D 推理和事实准确性这几块都还有上升余地。


这么看,Nano Banana 2.1 更像是一次冲着实际生产体验去的集中升级。版本号只动了 0.1,可谷歌下手调的地方,恰好是生成式图像真正进了工作流之后最容易出问题的环节:设计完成度、局部控制、连续编辑中的一致性,以及最终成图看着自不自然。


谷歌正试图把「会生成图片」这件事再往前推一步,推到「能够持续完成视觉工作」。Nano Banana 2.1 的意义,或许就落在这里。


参考链接:

https://x.com/NanoBanana/status/2107521202466046453

https://x.com/Google/status/2107501209154204148


Nano Banana 2.1发布:谷歌升级图像模型,瞄准专业设计(配图 12)


本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 谷歌Genie 4亮相:实时改写世界,原生音频同步生成

    IT之家 10 月 28 日消息,谷歌 DeepMind 团队昨日(10 月 27 日)发布博文,宣布推出 Genie 4 世界模型,定位为“重大研究里程碑”,在原生音频、实时自然语言改写、更真实的物理与人物等方面实现核心突破,把世界模型从一次性生成画面升级为可实时操控、可听、可推理的动态模拟世界。 对于用户而言,谷歌

    来源 AI 行业观察
  2. 谷歌Genie 4世界模型:加音频、支持实时操控,研究预览开放

    Google DeepMind发布Genie 4世界模型研究预览,面向可信测试者。新版本加入实时音频、更逼真的模拟,并支持在模拟过程中通过文本提示实时操控。相比前代,Genie 4从生成可交互世界进一步走向多感官、可导演的实时世界模型。本文梳理其核心升级、应用想象与仍需关注的挑战。

    来源 AI 行业观察
  3. 谷歌Genie 4发布:实时生成世界,还能语音对话

    梦瑶 发自 凹非寺 量子位 | 公众号 QbitAI 实时、改环境、语音指令、Gemini…全来了??? 刚刚,Google DeepMind正式发布新一代「世界模型」——Genie 4。 这也是,谷歌迄今为止最逼真且最具交互性的世界模型。 一句话实时修改场景、模拟真实物理效果,连人物动作、环境音效和互动对话都能同步生

    来源 AI 开发者社区
  4. 谷歌Genie 4世界模型:音视频同步生成,最长两分钟

    当地时间10月27日,谷歌DeepMind推出世界模型Genie 4研究预览版。该模型可生成高拟真度可交互虚拟世界,首次实现音视频同步生成,支持自由编辑,最长维持两分钟连贯画面。‌‌谷歌DeepMind官方账号称,“Genie 4是我们迄今为止最逼真、最具交互性的世界模型。”

    来源 TechWeb
  5. 谷歌DeepMind推出Genie 4:音视频同步生成,可实时编辑虚拟世界

    当地时间10月27日,谷歌DeepMind推出世界模型Genie 4研究预览版。该模型可生成高拟真度可交互虚拟世界,首次实现音视频同步生成,支持自由编辑,最长维持两分钟连贯画面。‌‌谷歌DeepMind官方账号称,“Genie 4是我们迄今为止最逼真、最具交互性的世界模型。”

    来源 TechWeb
  6. 谷歌发布Genie 4世界模型:实时生成场景,角色能开口对话

    文章转载于量子位作者:梦瑶实时、改环境、语音指令、Gemini…全来了???刚刚,Google DeepMind正式发布新一代「世界模型」——Genie 4。这也是,谷歌迄今为止最逼真且最具交互性的世界模型。一句话实时修改场景、模拟真实物理效果,连人物动作、环境音效和互动对话都能同步生成全安排上了。比如,直接在对话框里

    来源 腾讯网
  7. DeepMind Genie 4发布:物理与人类模拟双提升,开放生态待解

    DeepMind发布Genie 4世界模型,宣称在物理真实感和人类行为模拟上进一步提升,将向开发者及Google AI Ultra订阅用户开放。本文梳理世界模型从生成可交互环境到逼近真实物理的演进,分析其对游戏、机器人与AI训练的意义,并指出开放生态、算力成本与评测标准仍是关键挑战。

    来源 AI 科技快讯
  8. Nano Banana 国内哪里能用?5类入口逐条辨清

    先说结论:国内想直接用上 Nano Banana,省事的路子主要是这一条——接入它的多模型工作台。剩下几类入口,要么是原厂自己的通道,要么是换成别家模型的替代方案。这两件事混在一起讲

    来源 快科技
  9. DeepMind发布Genie 4:物理真实感与人类行为模拟升级

    DeepMind发布Genie 4世界模型,宣称在物理真实感和人类行为模拟上进一步提升,将向开发者及Google AI Ultra订阅用户开放。本文梳理世界模型从生成可交互环境到逼近真实物理的演进,分析其对游戏、机器人与AI训练的意义,并指出开放生态、算力成本与评测标准仍是关键挑战。

    来源 AI 行业观察
  10. 谷歌Genie 4:120秒虚拟世界,AI未来已来

    这个世界只能维持 120 秒,然后一切开始崩塌。然而在这两分钟里,你可以随时改变天气、召唤巨龙,甚至让一座城市为你拔地而起。 刚刚,Google DeepMind 正式发布新一代世界模型 ....

    来源 腾讯网
  11. Genie 4:实时交互加原生音频,世界模型能“进”了?

    Google DeepMind推出新一代世界模型Genie 4,主打高保真视觉与原生音频同步生成。该模型允许用户通过自然语言实时修改场景中的天气、物体或人物行为,并引入Gemini系列模型进行逻辑推理以维持模拟连贯性。目前仅面向受信任测试者开放预览,旨在探索其在机器人训练、游戏原型设计及影视预演等领域的应用潜力,同时承

    来源 AI 应用前沿
  12. 谷歌Android Bench 2.0:长周期任务与连续评分怎么评?

    谷歌发布了 Android Bench 2.0——谷歌用于评估 Android 开发任务中 AI 模型和智能代理的基准测试框架。此次重大更新引入了长周期任务(LHT)、基于智能体的评估以及连续评分机制,可以更好地评估在复杂的多步骤开发任务中的性能。 Android Bench 于数月前推出,用于通过一系列常见的开发任务

    来源 AI 行业观察
  13. 谷歌DeepMind高层换血后,Argon能打回前沿吗?

    文 | 影子备忘录 2026年的AI赛道,用“瞬息万变”来形容已经远远不够。如果你每隔两周没有关注前沿模型的动态,打开排行榜时大概率会怀疑自己是不是错过了整整一个季度。 就在这样近乎疯狂的产品迭代节奏中,谷歌DeepMind于9月30日正式发布了Gemini 4系列的首款旗舰模型Argon。距离上一代旗舰Gemini

    来源 AI 开发者社区
  14. 谷歌云开放 Claude 托管部署:企业可在自家基础设施上首发日即用最新模型

    谷歌云在10月23日把一道新的后门向企业客户敞开——Anthropic 托管的 Claude 模型部署选项正式上线使用。这意味着,企业不必再把数据搬来搬去,就能直接在谷歌云自己的基础设施上把 Claude 跑起来,而且能在模型发布当天就摸到最新版本,不用等新接口、等排期、等第三方转售。 这套方案的巧思在于"分工"。An

    来源 AI 开发者社区
  15. 谷歌Gemini 4 Argon上线:API限时五折,100万token上下文

    跳票已久的 Google Gemini 4 系列模型这次是真的来了…… 就在刚刚,谷歌 DeepMind 正式面向全球上线了 Gemini 4 系列的首发前沿模型 ——Gemini 4 Argon。 官方称,Gemini 4 Argon 的目标是解决现实世界中的复杂任务,聚焦软件工程、企业知识工作,以及网络防御,目前主

    来源 AI 行业观察
  16. Meta Muse上线:能点燃国内个人AI智能体吗?

    全球AI仍在加速演进。 头部玩家产品持续更新。10月13日,谷歌正式发布专为处理复杂、长程任务而设计的大模型Gemini 4 Argon,将之定义为前沿智能新阶段。在这之前的10月12日,Meta发布同样为长任务、深度推理而设计的大模型Muse Wonder系列,后者指向的是个人和专业Agent即智能体。 自9月8日官

    来源 AI 行业观察
  17. 谷歌SynthID官网上线:上传图片音频即可查AI水印

    谷歌正式推出SynthID官方网站,用户可直接上传图片、视频或音频,验证其是否由AI生成。这标志着这项由DeepMind研发的数字水印技术,首次从幕后走向大众。在深度伪造泛滥、内容真伪难辨的当下,科技巨头正试图用“标注源头”替代“事后鉴伪”,但水印技术能否成为行业通用标准,仍取决于生态各方的共同参与。

    来源 AI 科技快讯
  18. Google发布Gemini 4 Argon:重构600万行代码,回滚降三分之一

    刚刚, Google 发布了 Gemini 4 家族首个模型 Gemini 4 Argon。从官方给出的案例和测试结果看,这次升级的重点并不是单纯把模型“做得更聪明”,而是把 Gemini 的能力进一步推向长时间、多步骤、自主执行的真实工作流。也就是需要长时间推理、调用工具、跨多个步骤持续推进的复杂任务。比如,重构数百

    来源 腾讯网
  19. 谷歌Gemini 4“Argon”将发:内部已在测Carbon

    IT之家 10 月 10 日消息,据《商业内幕》报道,谷歌即将向公众正式发布新一代 Gemini 4“Argon”模型。与此同时,其内部员工已在测试性能更强的后续迭代版本,有望进一步缩小与竞品之间的技术差距。 据该媒体获取的内部文档与截图显示,谷歌员工近期一直在测试代号为“Carbon”的全新 Gemini 4 版本。

    来源 AI 行业观察
  20. Ndoc上线:前Meta总监打造AI办公平台,对标Office与Workspace

    前Meta AI总监Rohit Patel近日正式推出人工智能生产力创业公司 Ndoc ,并发布旨在挑战 微软 Office与 谷歌 Workspace的同名一体化办公平台。 该平台跳出了在传统电子表格中简单嵌入聊天机器人的既有模式,从零构建了包含“阶段”、“叙事”和“模型”三个独立标签页的工作空间。用户可通过“模型”

    来源 AI 开发者社区
向下滚动自动加载更多