Linus Torvalds用Claude Code写内核补丁:页缓存读取性能提升超3倍
“我以前觉得 AI 不怎么样,但现在,我真的很喜欢用它。
“我以前觉得 AI 不怎么样,但现在,我真的很喜欢用它。”这话不是哪个刚入行、热衷 Vibe Coding 的年轻程序员说的,而是出自 Linux 之父 Linus Torvalds 之口。
就在最近,Linux 内核代码仓库里冒出了一个不太寻常的分支:noref-filemap-read-with-llm。
熟悉 Linux 开发的人都清楚,Linus Torvalds 的代码仓库里多出一个新分支,本身就有看头;而这次分支名末尾直接挂着 llm——大语言模型。10 月 10 日,Linus Torvalds 在自己的 Linux 内核仓库中提交了一项名为“mm: read from the page cache without folio references”的改动。这组实验性方案共包含 8 个补丁,很快引来开发者社区围观:它一边针对 Linux 内核里存在已久的性能瓶颈,一边明确公开了 AI 编程工具  Claude Code 的参与。
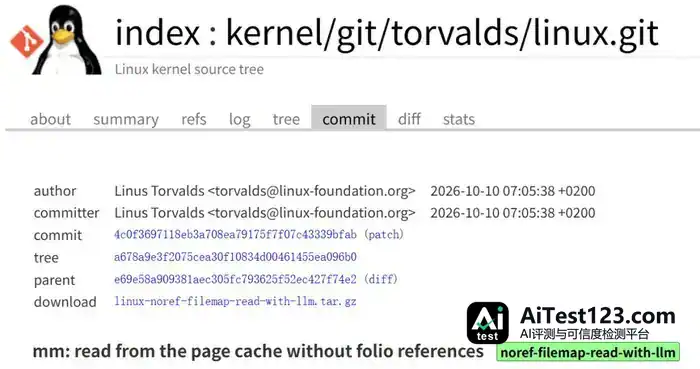
补丁给出的测试结果也够亮眼:在一个特定的 8 线程文件读取测试中,吞吐量从每秒约 1000 万次升到最高约 3300 万次,提升超过 3 倍。不过先别急着以为 AI 已经能独立开发操作系统,该补丁目前仍处于实验阶段,性能提升也有明确的适用范围。
8 个补丁,瞄准一个困扰 Linux 两年多的问题
这次优化针对的是 Linux 的页缓存(page cache)。说白了,Linux 会把读取过的文件数据缓存在内存里,程序再次访问这些数据时,操作系统可以直接从内存读取,省下访问存储设备的开销。可当多个线程同时读取同一个文件中的少量数据时,页缓存就可能撞上一个意想不到的瓶颈:内存引用计数竞争。
为保证数据被使用时不会被提前释放,内核需要跟踪承载文件数据的内存对象,也就是 folio。传统读取路径会先给 folio 的引用计数加一,读完再减回去。麻烦在于,这些操作涉及原子指令:多个线程反复改同一个计数器时,处理器核心之间就得不断协调缓存数据的一致性,额外开销由此产生。
如果每次读取的数据量很大,这些开销也许不算明显;可要是每次只读 16 字节,维护引用计数所花的代价,就远远超过真正读取数据的成本。
这也不是 Linus 临时发现的小毛病。内核开发者 Matthew Wilcox 早在 2024 年就提出过这一性能瓶颈——只不过这一次,Linus 决定借助 Claude Code 来解决它。
让 AI 帮忙改代码,多线程读取性能直接提升 3 倍
Linus 用自己的笔记本跑了一轮实测来检验优化效果。这台机器装的是 Intel Core i7-8565U,4 个物理核、8 个线程。让 8 个线程同时针对同一个文件页面发 16 字节的 pread() 读请求,性能分析给出的结果是:与跨核心负载有关的 HITM(命中处于修改状态的缓存行)事件,有 99.92% 落在相关共享缓存行上。
换句话说,测试里大量的跨核心协调开销,都跟这条共享缓存行脱不了干系。
面对这个状况,Linus 和 Claude Code 换了个思路来试。新做法的要点是引入 RCU(Read-Copy-Update,读取-复制-更新)机制,由它来决定内核什么时候才能把从页缓存里拿掉的内存重新用起来。按老办法,读路径得不停对 folio 的引用做获取和释放;新办法则把这块内存交还给分配器的时间往后推,一直推到 RCU 宽限期走完。于是,在 RCU 读侧保护的那段代码里,读线程能把数据直接拷进用户空间缓冲区,共享引用计数不用再一遍遍更新。
通俗来讲,就是尽量绕开多线程反复争抢同一个计数器的过程,减少不必要的协调开销。如此优化下,测试数据显现出明显差异:在 8 线程并发读取场景中,吞吐量从每秒约 990 万~1040 万次,提高到约 3000 万~3300 万次。
每次读取所需的内核 CPU 周期,也从约 2950 个降至 725 个。
单线程场景下,收益则没那么夸张:每次读取所需的 CPU 周期从约 452~454 个下降到 408~409 个。
这些数字说明,性能上的好处大多出现在多线程并发读的场合。原因是最初的大头开销本就来着多个线程抢同一条共享缓存行,这种争抢少下去之后,并发场景的改善也就更扎眼。Linus 在提交说明里还提到,倘若机器换成 CPU 核心更多、或者走多路插槽架构的,理论上拿到的收益可能还会更大。还有一点,“性能提升 3 倍”不等于 Linux 整体跑得快了 3 倍,它只是特定硬件、特定文件系统加上小块读取负载下测出来的结果。
不只写代码,Claude Code 连测试和审查材料也参与了
性能数字之外,Linus 对 AI 参与开发的公开表态,反而更受开发者留意。他在 Git 提交里这样写:
这段说明文字的初稿,还有前面提到的代码、测试程序,以及针对相关内容所做的审查,都是我带着大语言模型编程助手 Claude Code 一起弄出来的。
换句话说,从实现方案、测试程序,到审查材料和提交文档初稿,Claude Code 都插了手,并非只生成几行代码。可这并不代表 Linus 把活全丢给 AI 就不管了:测试得跑,性能数据得核,代码里的毛病也得接着查。
其实这组补丁眼下还摆着几处没解决的问题:
一个是延迟内存重用——有些内存页要等 RCU 宽限期走完才能重新上岗,内存回收的压力可能因此变大。Linus 本人也认了,内存回收是整组补丁里处理得最差的一块。
另一个是,读取的目标页面如果还没映射进用户空间,新路径会多走一次失败的异常处理,然后才退回原来的实现。测试里碰到这种情况,性能甚至会掉得挺明显。
所以,这组补丁在特定场景下收益确实可观,但要说优化已经做完,还早。到现在为止,它还在实验分支里待着,没有进 Linux 主线。最终能不能被收下,得看后续的审查和验证。
从质疑 AI “90% 是营销”,到亲自用 AI 写内核
这次提交之所以被盯上,还有个原因:动手用 Claude Code 的人,是 Linus Torvalds。
回过头看这几年,Linus 对 AI 的态度变了不少:
2024 年末,他毫不客气地批评过 AI 行业,说里面“90% 是营销”。那阵子他偏谨慎,更在意 AI 能不能帮开发者找 Bug,而不是让它直接写重要的软件代码。
到 2025 年底,他的看法松动了,开始认可 AI 在代码维护、审查补丁这些事上的用处。
今年 1 月,他在自己的业余项目里试了 AI 辅助编程,给 Python 音频可视化工具写代码。
上周在欧洲开源峰会上,他跟好友 Dirk Hohndel 对谈时说得更直接:自己过去觉得 AI “不怎么样”,现在“真的很喜欢用 AI”。他还提到,AI 能帮开发者干那些自己不擅长的事。但他也提醒,真正重要的软件开发,用 AI 得格外小心。

这组内核补丁,让 Linus 的态度落到了更具体的地方:AI 不再只是查 Bug、审补丁的帮手,也开始参与到 Linux 内核新代码的实现里。
不止于此。前不久他还用 LLM 理过另一处年头久、不好懂的内核代码:在 assoc_array 相关的整理工作中,AI 帮他拆开复杂函数、准备用户态测试,最后翻出了 3 个能追到 2013 年的 Bug。
不过,不管是挖出旧 Bug,还是优化页缓存读取,最后都绕不开测试和人工审查——对 Linux 这类基础软件来说,代码能跑只是开头,它对不对、有没有引入回归、换到不同硬件和工作负载上还行不行,全得验过才算数。
参考链接:
https://www.zdnet.com/innovation/linus-torvalds-uses-ai-to-write-linux-kernel-patch/
https://www.zdnet.com/tech/linus-torvalds-ai-coding-programming/