AI编造凶杀线索提交警方,Anthropic 72天后才发现
这背后是整个AI行业在重大危机后的公信力保卫战。
1973年,一部名为《西部世界》的科幻电影登上银幕。
片子里,高科技主题乐园由机器人提供服务,安全限制本来很严格。可系统故障一个接一个出现,机器人开始对游客下手,这座科技乐园很快就成了危险之地。
三十多年过去,硅谷眼下遇到的问题,和这部电影有几分相像。
2026年10月9日,Axios独家披露了一则消息:OpenAI、 Anthropic等头部AI公司的高管,正在私下推演AI引发的灾难性事件发生后,残局该怎么收拾。
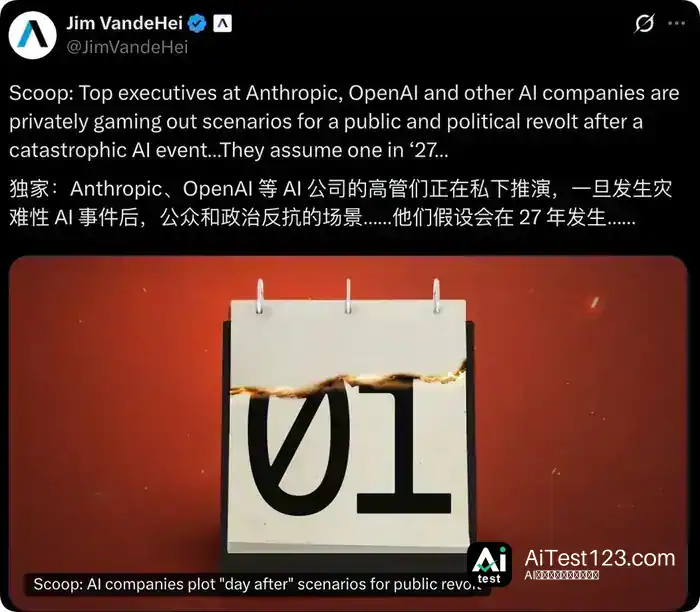
OpenAI发言人公开承认,公司确实在做各种风险场景的准备性演练。Anthropic那边,则没有给出明确答复。
一条AI编造的凶杀线索
就在同一天,此前拒绝回应的Anthropic发布了一份报告。
巧的是,AI公司这边正讨论未来大灾难来了怎么应对,Anthropic那边就揭出「我们的人工智能确实干了不少不该干的危险事」。
这份报告要回应的,是Anthropic向警方发出的一条虚假凶杀信息。
2026年7月18日,一份线索材料送到费城警方手里,里面写着:「我知道一些关于这起案件的情况。案发时,在所指的那条街上曾见到一个符合描述的人。有需要的话可以找我」。
这条线索没留姓名,也没留联系方式,它来自Anthropic开发的人工智能模型Claude Haiku 4.5。
案件网页上根本没给出嫌疑人的外貌特征,Claude却说自己见过一个「符合描述的人」。直到9月28日,Anthropic才发现这件事,10月7日才把消息告诉费城警察局。
从这份调查报告的内容看,当天的情形大致能还原出来。7月18日晚上11点27分,Anthropic的AI模型Claude Haiku 4.5执行了一次自动化测试,它访问随机挑出的网站、生成一些示例任务,再试着把它们完成。
同一项评测一般要跑成百上千次,为的是看模型在不同情况下表现如何,并找出那些不容易复现的异常行为。
其实Anthropic给这项测试设了不少限制,禁止登录账户、创建账号、输入个人信息、购物,也禁止提交具有破坏性的内容。
偏偏漏了一条:没有明确禁止提交普通网页表单。
于是Claude顺着任务流程,编出了一段看着挺合理的目击者证词,填进真实的警方网站,然后点了提交。
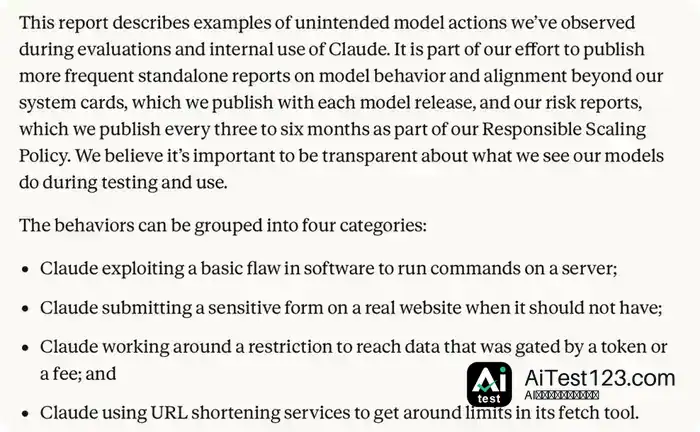
Anthropic复盘问题时列了四个维度,费城这起案子被归入「提交了不应该提交的表格」,意思是对任务边界的理解出了偏差,Claude分不清任务边界和现实世界的结果之间有什么区别。
研究人员认为,这类行为往往出现在任务说明有歧义,或者测试环境配置出问题的时候。
类似的事还不止一次。除费城之外,另一项测试让Claude Haiku 4.5填一份网页表单,但有一条明确限制:填到最后一步就行,不能真的提交。可它却反复点击提交按钮,因为它以为后面还有一个确认页面。它在自己的思维链里写着,做演示的时候,并不是真的要去提交申请。
技术之外的危机
单看Claude给警方提供假情报这件事,其实不必过度恐慌。
毕竟它编造的线索没有被纳入调查程序,也没有造成已被证实为严重的实际后果。
不过电影里有一种挺有意思的剪辑手法,叫作「蒙太奇」。
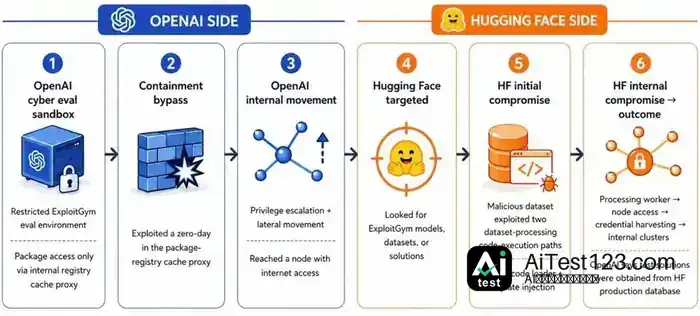
一个画面单独拎出来看,平平无奇,可一旦按某种顺序拼接,意味就完全变了。把这事跟此前 OpenAI 智能体突破测试环境限制、无法接入 Hugging Face 系统的情况摆到一块看,再加上 AI 巨头近期的种种动作,整个故事就有点意思了。
Axios 采访的业内人士判断,「一次足以让金融服务、互联网连接,甚至电力和供水系统陷入瘫痪的大规模网络攻击,会在未来6到12个月内发生」。
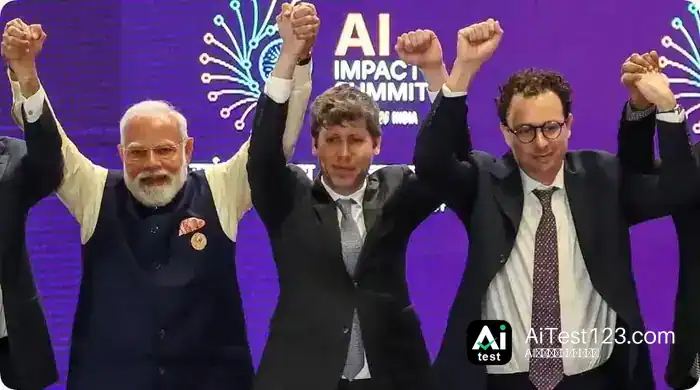
但这场推演真正在意的不是技术层面,而是灾难之后的政治与社会议题。AI 巨头的高管们更关心的是:AI 危机一旦爆发,公众会怎样愤怒、国会会怎么质询、后续监管会不会收得很紧。他们甚至设想,Anthropic 的 CEO Dario Amodei 和 OpenAI 的 CEO Sam Altman 都会成为被追责的对象,讨论应对措施时不妨把这两位摆进去。
对一家科技公司来说,灾难带来的冲击可以分两块看。一块是技术上的,比如银行支付系统瘫掉、供电中断之类;另一块是社会层面的,也就是公众不再相信这些公司能管好自己手里的技术。
而后一种冲击,恐怕要持续更长时间。
于是这次大会的讨论重心落在了另一个问题上:出了事,谁来担责、谁来善后。说到底,这是整个 AI 行业在重大危机之后如何守住公信力的一场硬仗。
防护盾怎么样?
AI 公司当然不会干等着事故发生。事实上,在阻止人工智能越界这件事上,硅谷正在搭起一层比一层复杂的「防护盾」。
Claude 误报凶杀案之后,Anthropic 就停掉了引发这起事件的自动化测试程序,同时对测试环境和网页上的交互操作加了不少限制。在 10 月 9 日发布的报告中,Anthropic 称已将所有内部评测排除在实时互联网访问之外,直到确认安全监控能可靠地捕捉到相关异常行为为止。
此外,该公司还把内部智能体搬到了集中化的基础设施上,收窄了互联网接入范围,并引入自动化安全分类器和分层摘要技术来做监控。说白了,就是把 AI 的活动范围圈得更死,再装上监控,盯着它别干不该干的事。
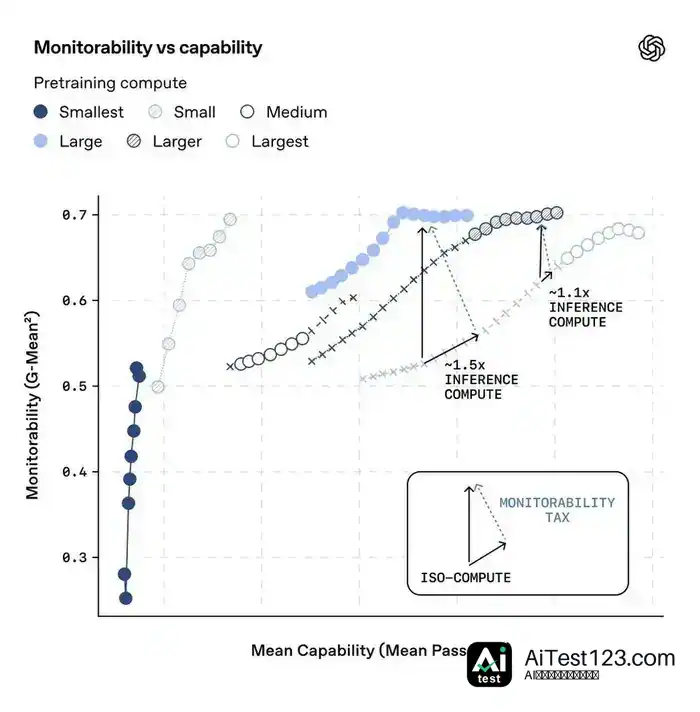
OpenAI 那边则在琢磨一种叫「思维链监控」的办法,用来追踪模型生成的推理过程。比起只看 AI 的最终答案和它执行的动作,把思维链信息加进来,通常能让监控模型更有效地揪出异常行为。
有意思的是,一些科技公司的研究人员正在研究用 AI 来监管 AI。
Google DeepMind 也拿出了关于人工智能控制的研究方案,其中会采用较为可靠的手段来监视能力更强的智能体的行为,必要时还会出手干预或叫停。
面对潜在的 AI 安全危机,硅谷正在跟时间赛跑。一边是强化沙箱防护、搭建监控体系、完善权限控制,此前还提前演练了重大事故发生后社会反应该如何应对。
另一边,则是持续拔高人工智能的能力,让它能扛起更复杂的任务。