RadixArk发布DaisyRose-27B:18天强化学习,终端任务通过率翻倍
RadixArk团队基于Qwen3.8-27B推出了DaisyRose-27B模型。通过自研的Miles框架和高质量数据筛选,团队仅用144张H200 GPU在18天内完成了训练。该模型在Terminal-Bench 4.1上的通过率从5.6%提升至12.0%,且训练成本比开源方案降低57%。文章详细介绍了其数据构建逻
小步快跑:18天让27B模型学会“深思熟虑”
大模型圈子里,大家都在拼参数规模,但RadixArk团队这次走了另一条路。他们发布了DaisyRose-27B,这是他们的第一款模型,底座是阿里通义千问团队的 Qwen3.8-27B。
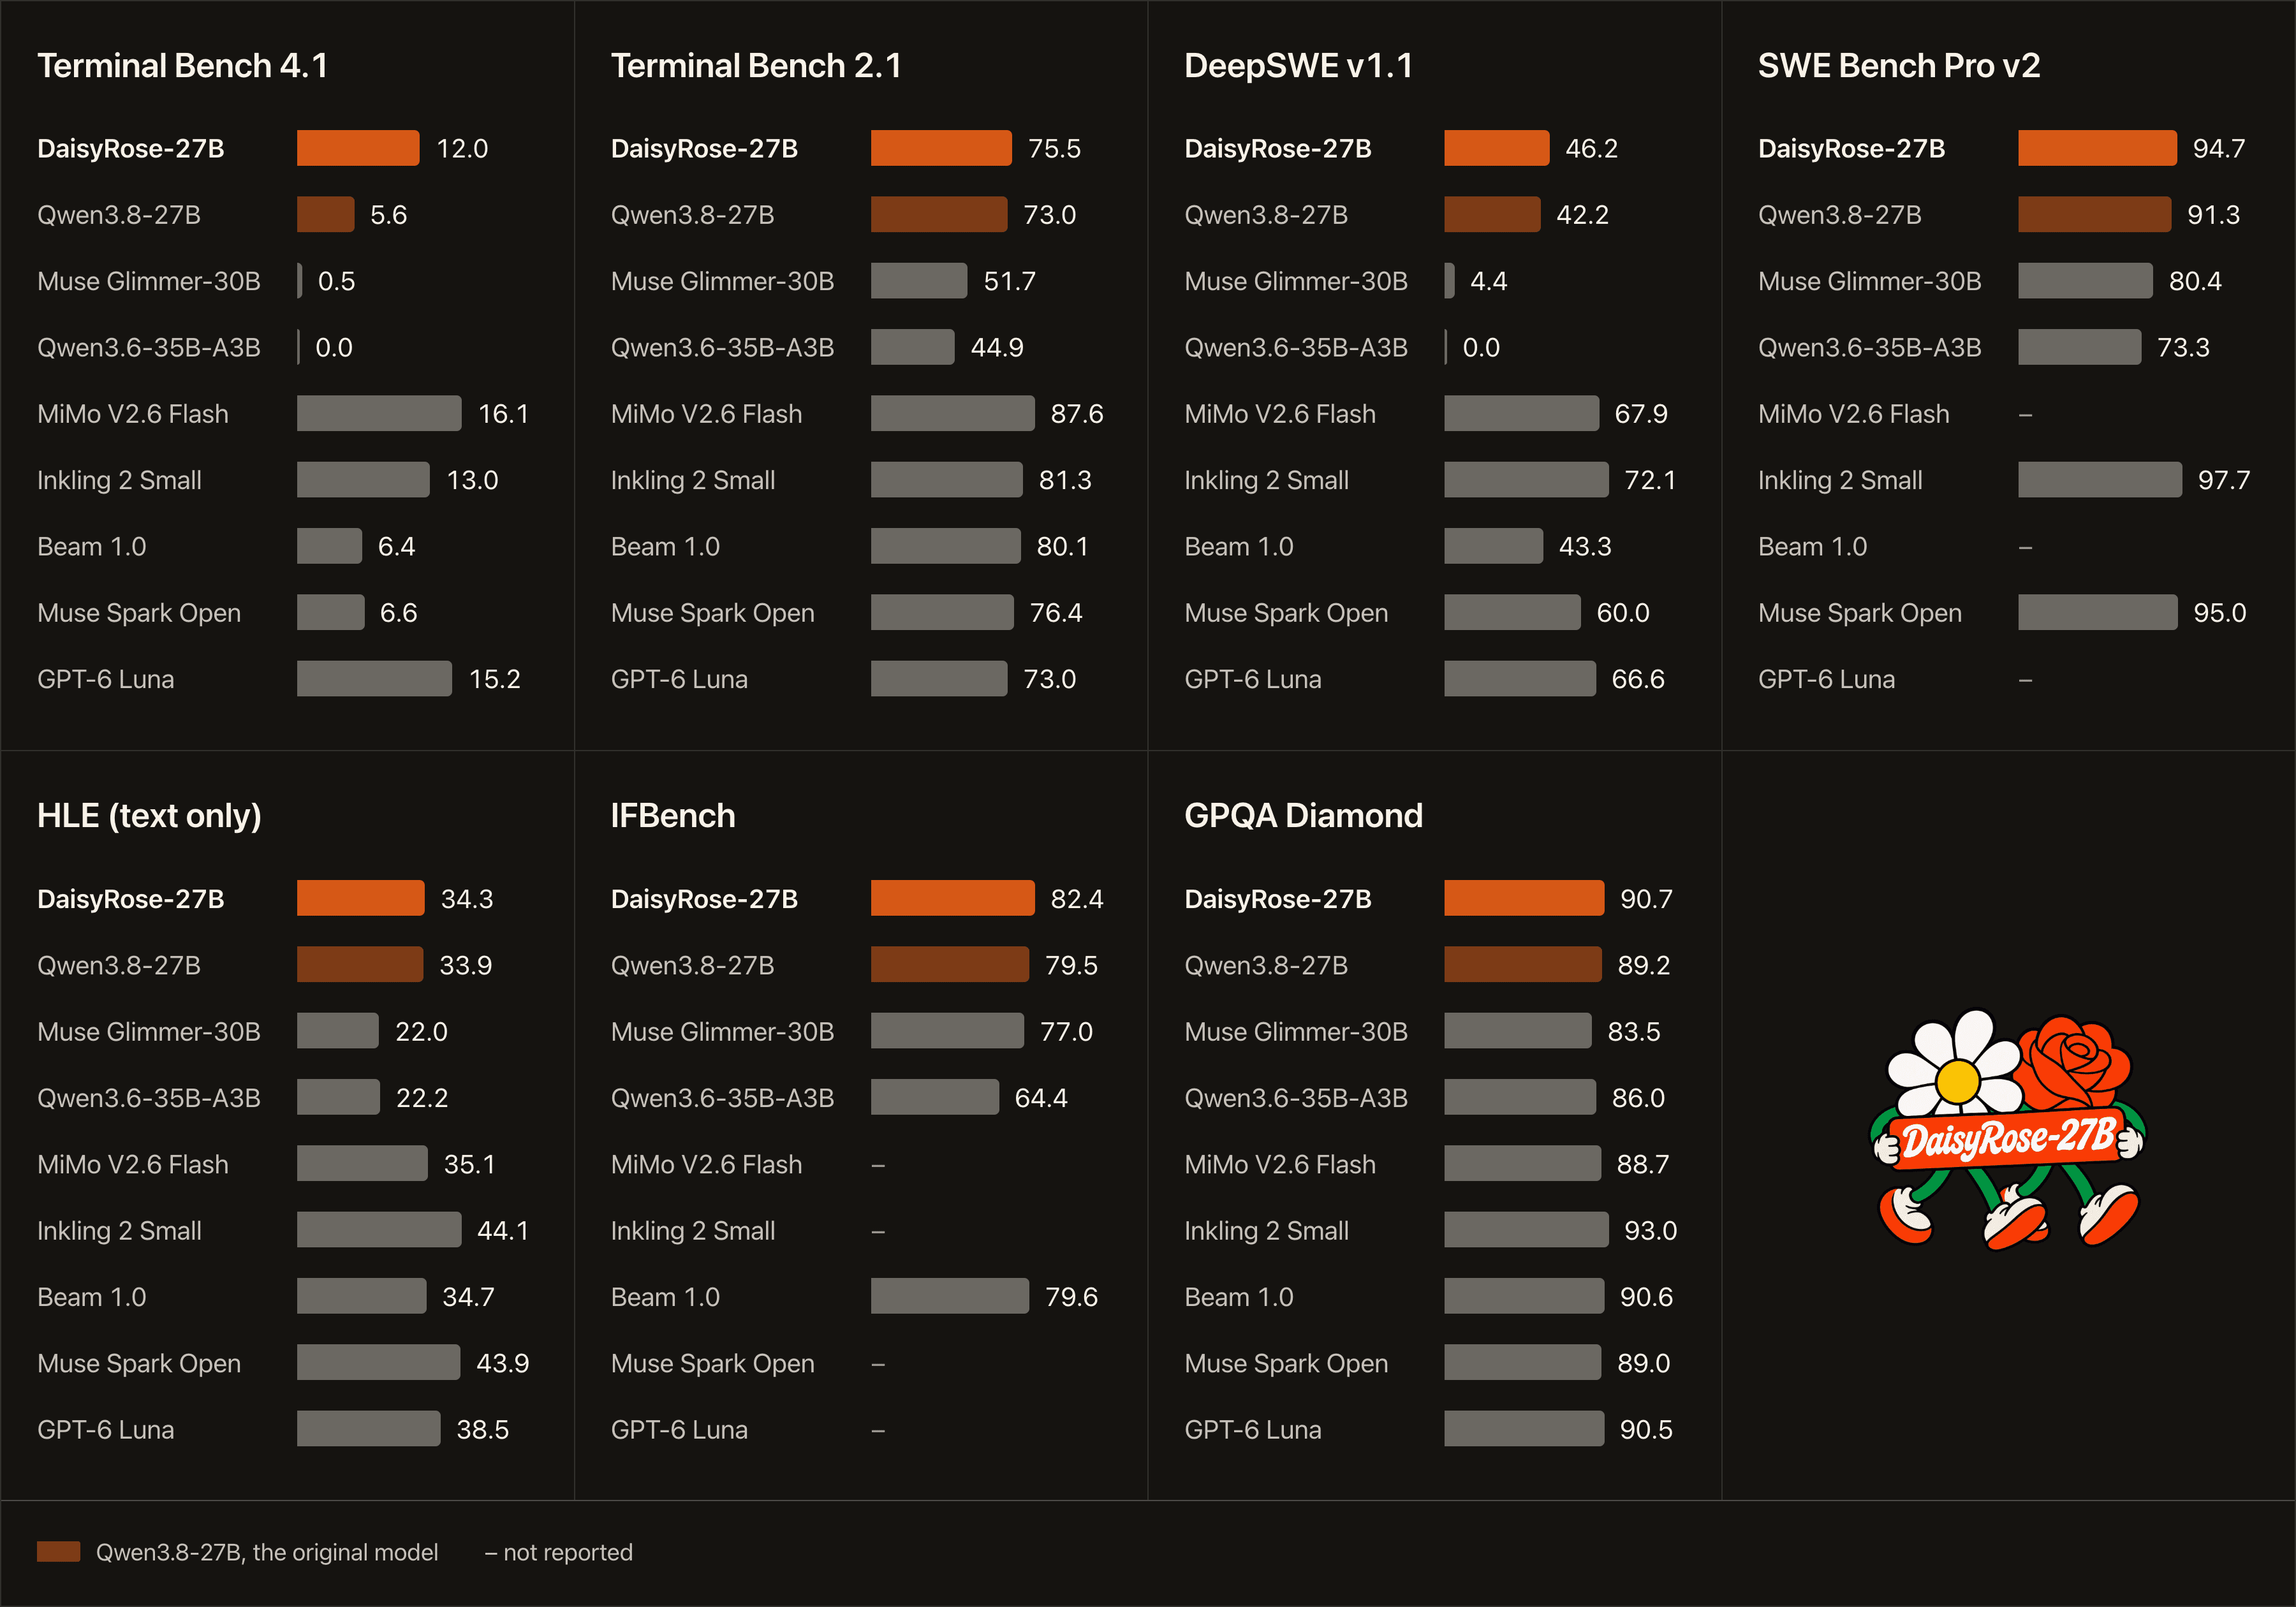
这不是简单的微调,而是一次针对“长程代理任务”的强化学习特训。结果有点出人意料:只用了144张H200 GPU,耗时18天,处理了1200个精心挑选的任务,就把Terminal-Bench 4.1的pass@1指标从5.6%拉到了12.0%。翻倍的增长,对于已经相当成熟的27B参数模型来说,是个不小的突破。
更值得关注的是效率。RadixArk没有堆砌算力,而是靠一套名为Miles的异步训练框架和一套高可用的沙箱服务,把训练成本打了下来。相比传统的开源训练方案,他们的后端能让同样的训练任务少花57%的GPU时间。
目前,DaisyRose-27B的权重已经以Apache 2.0协议开源,包括BF16、FP8和NVFP4三种精度格式。它保留了Qwen3.8-27B原有的256K上下文窗口、图像理解能力和对话模板,但在解决复杂推理、代码生成和指令遵循问题上,表现更加稳健。
为什么是这1200个任务?
很多强化学习训练失败,不是因为算法不行,而是因为数据太“水”。RadixArk这次和数据合作伙伴Eigent AI一起,从机器学习、软件工程、科学计算等领域的数千个候选任务中,筛出了最终的1200个。
筛选标准很务实,甚至有点“苛刻”:
第一,必须针对原模型的弱点。团队先让Qwen3.8-27B跑了一遍所有候选任务,专门挑出那些模型容易犯错的地方。然后围绕这些错误重新设计任务,调整难度,确保模型处于“跳一跳够得着”的学习区间。如果模型要么全对,要么全错,这个任务就被弃用。
第二,必须足够复杂。每个任务都要求智能体进行多步推理、规划和执行。在一次尝试中,智能体需要在沙箱里运行长达1.5小时,发起超过100次工具调用,输出超过256K token的内容。这种长程依赖是检验模型逻辑连贯性的试金石。
第三,必须真解决问题。团队人工审查了每一个任务和模型的尝试过程。如果一个任务存在设计缺陷,或者模型可以通过“作弊”(比如猜答案)而不真正解决问题就得分,这个任务就会被修复或直接删除。他们不要虚假的高分,只要真实的解决能力。
Miles框架:让训练和推理不再互相等待
传统的强化学习训练,往往是“串行”的:智能体去跑任务,跑完了把数据存下来,训练器再拿去更新模型,更新完了再发给智能体。这中间大量的等待时间,都是算力的浪费。
RadixArk自研的Miles框架采用了完全异步的模式。简单来说,就是“边跑边学”。
在DaisyRose-27B的训练中,128张H200 GPU专门负责运行智能体,执行那些耗时的长程任务;另外16张GPU则负责训练器的工作,实时从智能体产生的轨迹中学习。每当训练器完成一步更新,新模型就会立刻同步给那128张推理卡。智能体不需要停下来等模型更新,训练器也不需要等所有任务跑完。
这种架构带来了两个直接的好处:
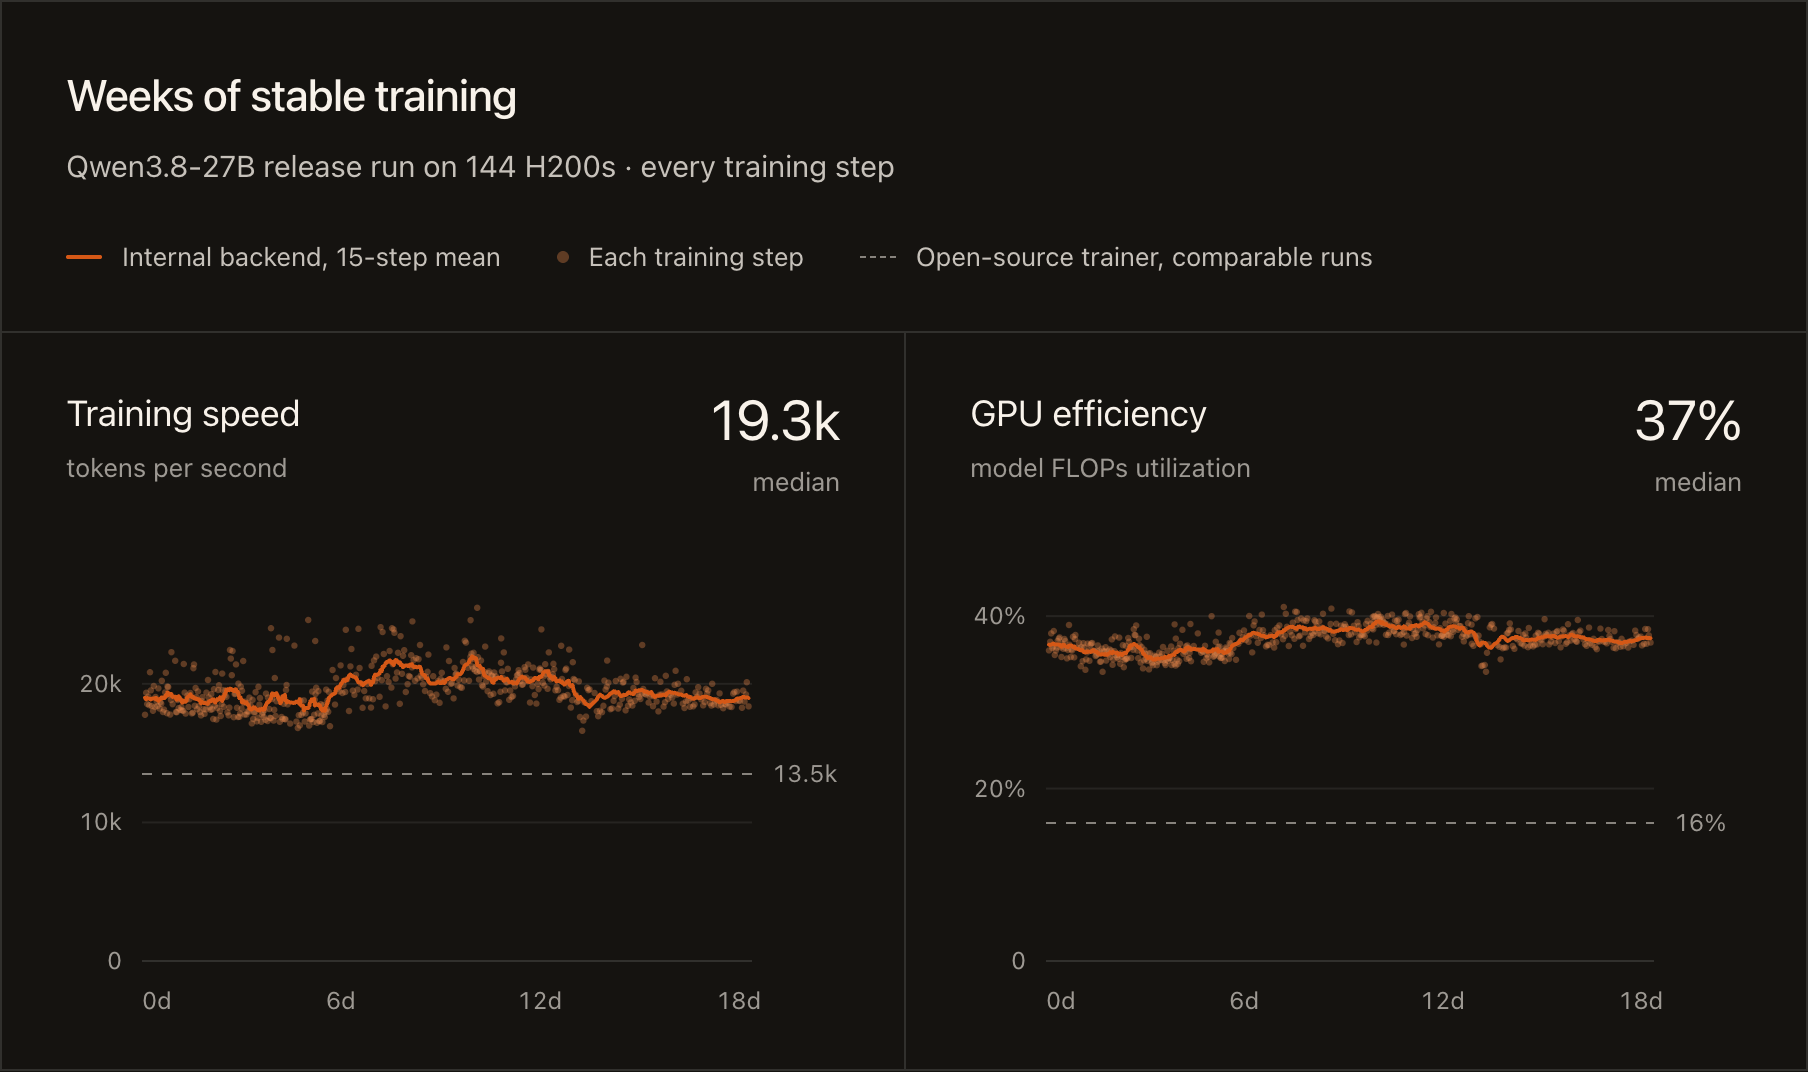
首先是模型FLOPs利用率(MFU)的提升。在DaisyRose-27B的训练中,MFU达到了37%,而基于Megatron的开源训练器在类似任务上只能做到16%。这意味着,完成同样的训练量,RadixArk的方案能节省57%的GPU时间。如果是混合专家(MoE)模型,这种优势会更明显,比如在Qwen3.6-35B-A3B上能提速6.2倍,在300B参数的GLM-5.3-Flash上甚至能提速10倍以上。
其次是端到端的速度。算上智能体执行任务的时间,整个集群每秒能处理约16,800个token,而开源方案只有8,300个左右。整整快了一倍。
从9月中旬到11月中旬,这套系统在144张H200上稳定运行了9周,累计消耗63,000 GPU小时。从第一步到最后一步,训练速度和效率几乎没有波动,这对于长期训练任务来说至关重要。
沙箱服务:99.95%的成功率是怎么做到的
强化学习训练智能体,离不开沙箱。智能体要在里面敲命令、改代码、跑测试,然后由环境给出反馈。如果沙箱不稳定,训练就会频繁中断,数据也会污染。
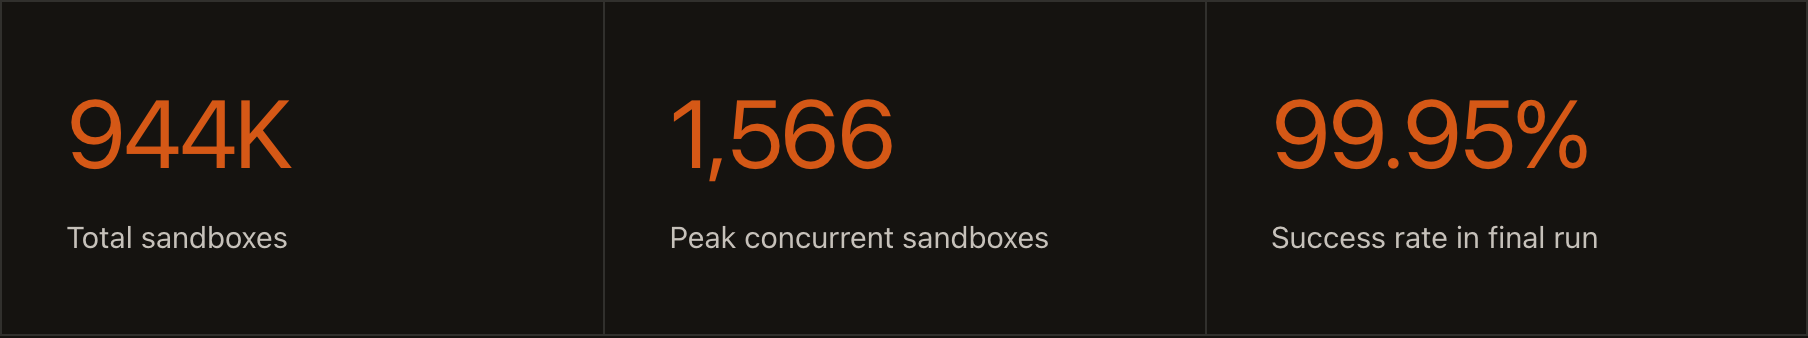
RadixArk的沙箱服务基于开源项目AgentENV构建,但他们做了大量的工程化优化。在为期九周的训练中,这个服务创建了约94.4万个沙箱实例,最高并发数达到1,566个。
为了支撑这么大的并发,他们将基础设施从最初的一台机器扩展到了12台。更重要的是,他们在训练期间进行了十次服务升级,几乎都是在不停服的情况下完成的。
稳定性方面,整体沙箱创建成功率保持在99%以上。从10月下旬开始,这一数字更是提升到了99.95%。对于需要数十万次交互的训练任务来说,这种可靠性是底线。
成本也是个大头。相比于直接使用云服务商提供的现成沙箱服务,RadixArk自建服务的成本降低了约80%。秘诀在于动态内存分配:每个沙箱的内存占用会根据实际使用情况自动伸缩,而不是预先分配固定大小。这样,一台物理机上就能挤下更多的沙箱实例,资源利用率大幅提高。
如何上手DaisyRose-27B
如果你也想试试这个模型,或者基于它构建自己的智能体,目前有几种方式。
最直接的是下载权重。你可以在Hugging Face上找到BF16、FP8和NVFP4三个版本。考虑到推理效率,FP8版本在保持精度的同时能显著降低显存占用,适合大多数部署场景。
部署方面,官方推荐使用SGLang配合DSpark speculative decoding(投机解码)。SGLang社区已经提供了详细的Cookbook,针对不同GPU型号和 checkpoint 格式都有对应的启动配置。
下面是一个简单的Python调用示例,展示了如何获取模型的“思考过程”:
from openai import OpenAI
client = OpenAI(
base_url="http://localhost:30000/v1",
api_key="none",
)
response = client.chat.completions.create(
model="DaisyRose-27B",
messages=[
{
"role": "user",
"content": "360有多少个正因数?",
}
],
temperature=1.0,
top_p=0.95,
extra_body={"top_k": 20, "min_p": 0.0},
)
# reasoning_content 包含模型的推理链条
print(response.choices[0].message.reasoning_content)
# content 包含最终答案
print(response.choices[0].message.content)
默认情况下,DaisyRose-27B会在给出最终答案前进行内部推理。reasoning_content字段会返回这段思考过程,而content字段则是最终结论。这种“先想后答”的模式,正是它在复杂逻辑题上表现更好的原因之一。
写在最后
DaisyRose-27B的发布,某种程度上证明了“后训练”(Post-training)阶段的潜力。在底座模型越来越同质化的今天,如何通过高质量的数据筛选、高效的训练架构和稳定的工程设施,挖掘出模型在特定领域(如Agent任务)的深度能力,可能比单纯追求参数量更有现实意义。
RadixArk团队并没有止步于此。他们开放了Miles框架,也鼓励社区反馈DaisyRose-27B在实际应用中的表现,尤其是那些它搞不定的案例。这种开放的态度,或许比模型本身更能推动技术的迭代。
对于开发者而言,如果你正在构建需要长程规划、代码执行或复杂推理的智能体应用,DaisyRose-27B值得放入你的评测列表。它不一定在所有基准上都拿第一,但在那些需要“动脑子”且“有耐心”的任务上,它确实展示出了不一样的韧性。