RTX Spark实测:120B本地大模型与Day 0适配怎么落地
NVIDIA上海实验室RTX Spark体验分享:首发评测没讲透的这里告诉你
搭载RTX Spark的笔记本上市已有一个月,当初我们和国内同行同步放出了评测体验。各家媒体都是头一回接触这种新形态产品,时间又赶,不少测试文章其实没把RTX Spark的真实能力讲清楚。
11月11日,NVIDIA在上海办了一场RTX Spark媒体分享会。现场摆出了全新的RTX Spark笔记本电脑和紧凑型桌面主机小盒子,对这款产品究竟是什么、在实际场景里能干什么做了深入拆解。
一、RTX到底是什么,与此前产品有何不同
按照NVIDIA的定位,RTX Spark是一台面向本地智能体的Windows PC:本地最高能跑1200亿参数(120B)大模型,支持100万token上下文,素材、代码和对话数据都留在本机,不用订阅云端服务,也不按token计费。以前得传到云端、或者靠多张显卡堆工作站才能干完的活,现在一台迷你PC就能接住。

这套能力由RTX Spark超级芯片撑起来:一颗Blackwell架构RTX GPU加一颗20核Grace CPU(Arm架构,与联发科合作定制),两者通过NVLink-C2C片内互联,互连带宽600GB/s,支持双向缓存一致性。整机AI算力1 PFLOP(FP4/NVFP4精度),配128GB统一内存。
Windows ARM阵营里,微软和高通早有对应方案;迷你工作站这条线上,AMD锐龙 AI Max+ 395平台的定位又和它很像。那RTX Spark跟它们比,差别到底在哪?
先看高通的Windows ARM笔记本,它和RTX Spark最大的不同就在显卡。
高通Windows ARM设备用的是Adreno GPU,跑主流3A游戏基本没戏;绝大多数靠GPU加速的Windows专业软件——Adobe创意全家桶、DaVinci Resolve、Blender、工程仿真与科学计算工具等——要么开不了GPU加速,要么加速效果大打折扣;大量基于CUDA开发的插件和行业工具更是完全跑不起来。
换句话说,高通Windows ARM笔记本眼下只能当一台长续航办公本用。
再看表面上高度相似的AMD锐龙 AI Max+ 395平台,RTX Spark有这些优势:

· 日常AI应用:开箱即用的全场景覆盖
RTX Spark的AI加速属于Windows平台的通用标准:办公软件的AI助手、创意软件的AI功能、本地大模型运行、AI生图/视频、AI代码辅助,主流Windows AI应用都在CUDA生态里,原生支持RTX加速,开箱即用,不用另装驱动或配环境。
反观绝大多数第三方AI应用,ComfyUI生成式绘画、DaVinci Resolve AI剪辑、本地大模型前端、各类AI创作插件,基本都没适配Windows下的ROCm,GPU加速效果比RTX Spark差得远。
· 大模型训练与开发:生态标准级的兼容性与效率
PyTorch、TensorFlow等主流AI训练框架和工具链,首要优化目标都是CUDA。RTX Spark建在完整的NVIDIA CUDA生态上,有1 PFLOP FP4 AI算力和TensorRT深度优化,是全球AI开发的标准平台。
Windows平台下ROCm的支持极不完善,大量训练插件、自定义算子没法直接跑。
· AI推理性能:重负载场景的量级领先
Blackwell架构的专用AI计算单元加上TensorRT推理引擎,让RTX Spark在INT4/FP4等低精度推理下优化得很彻底:大语言模型的预处理、生成速度全面领先,AI生图、AI视频、多模态推理等场景也有肉眼可见的性能优势。
第三方实测数据能说明问题。跑GPT-OSS 20B大语言模型时,锐龙 AI Max+ 395平台生成速度约1589 tokens/s,RTX Spark是5616 tokens/s,领先3.5倍;FLUX.2生图任务里,相同参数下单张图AMD要66.3秒,RTX Spark只需25.8秒,差距2.6倍。
NVIDIA亲自主导这个平台,RTX Spark拿到的不是某一点的支持,而是全栈资源的倾斜。
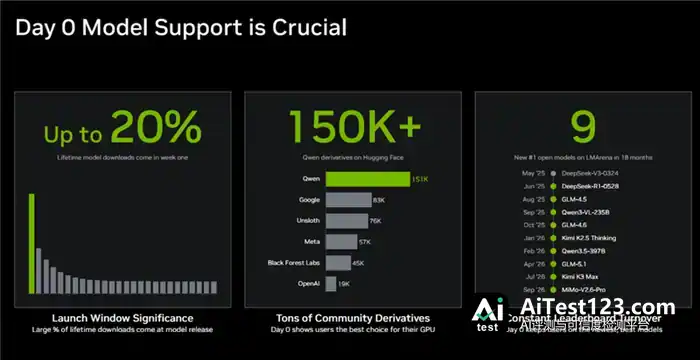
拿Day 0模型支持来说,新模型发布当天,桌面端RTX能用到的TensorRT优化、驱动级加速、官方适配方案,RTX Spark同步就能用;不会出现“ARM端/移动端延后适配”的情况,和桌面级显卡同节奏的Day 0体验是实打实的。
用户需求偏偏就集中在产品发布初期。数据显示,一款模型全生命周期里,高达20%的下载量发生在发布首周。用户对新模型有很强的“尝鲜刚需”,适配晚1~2周,最核心的使用窗口就错过了,本地AI体验已经打了折扣。
Day 0不可替代的价值,就在这里。
下面是我们此前在NVIDIA上海实验室完成的实机体验和现场演示内容。
2、超大规模3D场景:小主机扛住UE5重负载
128GB超大统一内存撑着,RTX Spark能实时渲染超过90GB的3D场景。

现场,NVIDIA工程师用UE 5渲染了一幅超大的城市整体图。
有了超大统一内存,用RTX Spark做UE5开发时,超大规模场景加载很顺畅,编辑时即用即现,没有明显卡顿或迟滞。这个场景里还能同时打开光追,以及DLSS 5的超分辨率、插帧、降噪等全部功能。
以前这类大场景,往往得靠专业图形卡加笨重工作站才加载得动;这回演示却是在巴掌大的迷你主机上完成的。也就是说,UE5开发不必再绑在又大又重的专业工作站上。
3、视频创作:靠本地AI做视频切片、抓帧、重绘与超分辨率
现场最典型的演示之一,是NVIDIA工程师对一段30年前的古早视频做AI二创再生成,整条链路主要靠本机GPU以及CUDA、Tensor Core的加速能力。
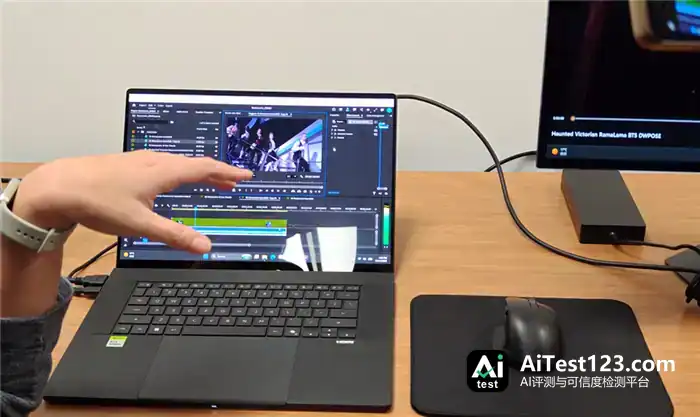
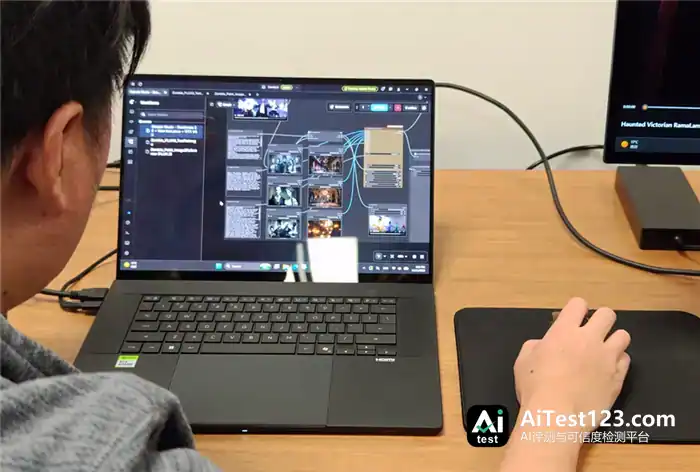

具体实现步骤如下:
切片与抓帧:先用视频剪辑软件把原素材按约每10秒一段切开,再为每个片段截取一帧关键画面。
角色与场景重绘:关键帧送进ComfyUI,借助提示词完成文生图,生成二创所需的新角色与场景;过程中调用Seedance、FLUX 3等多种模型完成文生图、文生视频与动作轨迹识别渲染。
动作迁移:切片保留原视频中人物的舞蹈或表演动作,再由大模型把动作赋予新生成的角色。
本地超分辨率收尾:借助RTX超分辨率把生成的1080p视频提升到4K。
整个过程大约需要30分钟;若一开始就在云端直出4K,时间与成本都要翻数倍。
4、NVIDIA ACE本地智能伙伴:定制专属人设的智能交互NPC
除了生产力应用,游戏内的AI智能伙伴也是RTX Spark的核心场景之一。
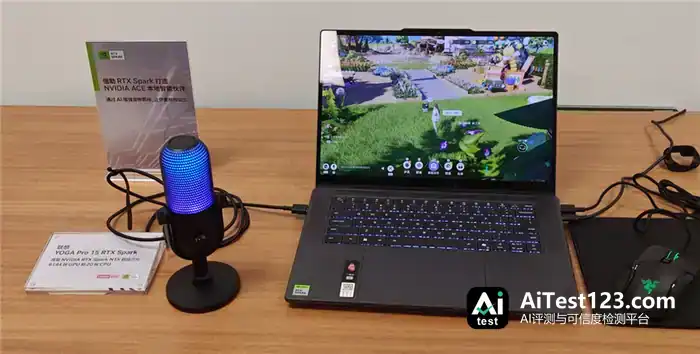
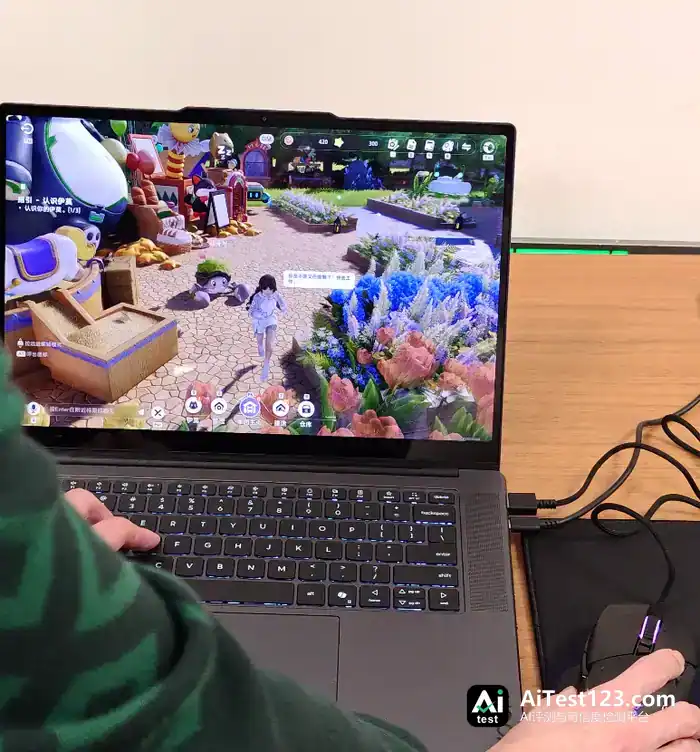
玩家在游戏里装上NVIDIA ACE本地智能伙伴之后,张嘴说话就能跟NPC打交道:下指令让它干活、让它做指定动作都行;喊一声NPC的名字,它还会跑过来,围在主角身边。
语音识别、意图理解、角色应答,这些环节全在设备本地跑完,NVIDIA ACE本地智能伙伴让NPC重新回到机器端,能对话、听命令、反应也跟得上。靠RTX Spark的算力撑着,这个内置智能伙伴不联网也能用,而且不会大量占用系统资源,游戏不至于因此卡顿。
另外在游戏支持方面,RTX Spark也远胜于以往的Windows ARM设备。
ARM笔记本打游戏,这几年真正的难处不是性能不够,而是很多游戏得走转译层才能跑,反作弊、插件、Mod、老引擎的兼容毛病接连冒出来。

RTX Spark完整继承了NVIDIA RTX游戏技术栈、首发当日就支持数百款主流游戏、覆盖3A单机、MMO、体育、竞技全品类。
《魔兽世界:永恒》《战争机器:E-Day》《AION 2》《控制:共振》《伊莫》《NBA 2K27》这些作品,还都属于同期首发的行列。适配节奏跟桌面端RTX 50系显卡一致,没有新游戏先照顾独显、ARM版往后排这回事。
还有一点,反作弊支持一直是道坎,以前ARM Windows平台跑不了大多数网络竞技游戏。如今NVIDIA拉上头部厂商,把竞技网游的反作弊兼容问题直接解决掉了,主流电竞网游大多已把RTX Spark设备放进白名单。
5、WorkBuddy与千问办公:RTX Spark专属本地办公模型
2026年11月最新版本WorkBuddy对RTX Spark进行深度适配,内置官方提供的一键本地模型功能。
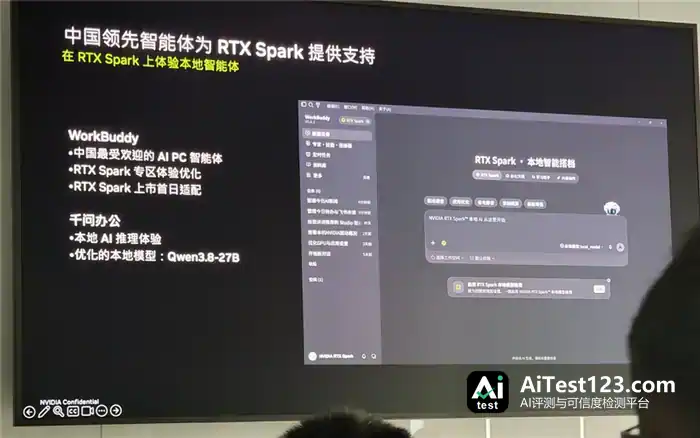
进设置菜单点开“模型”一栏,本地大模型就能下载了,推理引擎用的是CUDA-13。模型下载部署全自动,之后一直挂在后台,切回任务界面选中这个本地模型就能干活,用起来和云端版没有差别。
数据分析、数据可视化、报告总结这类偏琐碎的日常办公活,本地模型跑起来挺稳。
内置模型之外还能自己加。走LM Studio的本地模型API,把已经下好的本地模型当自定义模型接进WorkBuddy就行;同样的路子,也能把本地模型接到别的智能体工具上。
性能上,内置的是50B MoE本地模型,日常对话、办公任务生成都流畅稳定。换成Qwen3.8 27B级别的开源模型,生成速度能到55–60 tok/s,十万token级的长文档处理下来也没有明显衰减。
WorkBuddy本地化之后,原先靠云端积分撑着的智能体,变成了完全在本地跑、不消耗Token额度、数据不出本机的常驻办公工具。

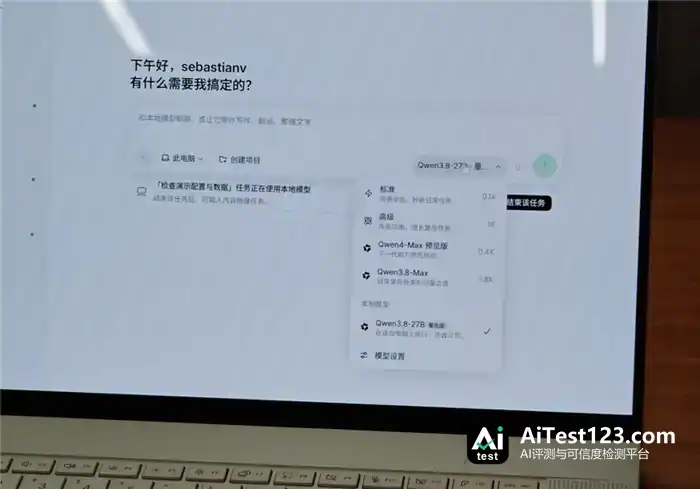
现场工程师还演示了RTX Spark本地部署千问跑大模型。一键部署本地模型,Ollama、llama.cpp都不用手动装,开发环境也不用配。
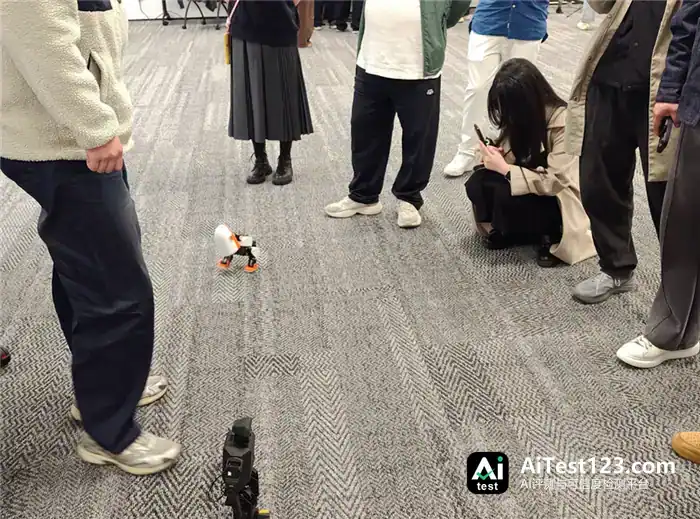

篇幅有限,很多实用的落地场景就不一个个说了。拿RTX Spark给机器人、机械手臂做本地仿真训练加实机推理控制就是其中一例,不需要多深的算法开发底子,普通学生、爱好者、产品经理都能上手,门槛很低。
以NVIDIA的技术实力和行业号召力,RTX Spark超过以往的Windows Arm设备应该不成问题。
快科技也拿到了RTX Spark迷你主机,完整深度评测近期放出,敬请期待。