达瓦科技控制层模型:AI视频何时能告别“抽卡”?
达瓦科技不走通用大模型路线,而是基于12年片场积累的180TB结构化数据,研发“重控制、轻渲染”的基座模型。通过分离导演逻辑与画面渲染,将影视制作中的反复试错成本降低50%以上,并让实时世界模型能在单张消费级显卡上运行,为直播、游戏及Physical AI提供低成本落地方案。
为什么AI视频进不了片场?
如今市面上的AI视频生成工具,普通用户玩得挺起劲。敲一段提示词进去,几秒钟就吐出一段视频,乍看还挺唬人。可真要把它塞进专业的影视制作流程,毛病就全冒出来了。
最要命的是“不可控”。导演要一个镜头,AI能给出十个版本,个个带点小瑕疵:人物动作穿帮、光影逻辑不对,或者前一秒还在笑、后一秒脸就僵了。为了挑出一个能用的镜头,团队只能一遍遍“抽卡”,算力烧得厉害,时间更烧。片场按分钟计费,这种不确定性根本扛不住。
业内主要有两条路子。一条是信大力出奇迹,接着堆参数、扩算力,赌通用大模型哪天突然开窍,迈过工业门槛。另一条是从片场的实际痛点出发,自下而上把技术栈重新搭一遍。达瓦科技走的是后一条。
这家公司总部在重庆永川,前身是运营了十二年的科技影视片场,2023年正式转做AI模型,今年接连完成Pre-A轮和A轮融资,累计拿到约5亿元人民币。他们的核心思路说起来不复杂:把“怎么拍”和“拍出来什么样”拆开,也就是他们讲的“重控制、轻渲染”。
控制层像导演,渲染层像相机
要弄懂达瓦的技术路线,得先把视频生成的两个层面拆开看。
传统视频大模型,比如基于DiT架构的那些,更像一台超级相机。你下指令,它直接吐像素。这台“相机”越做越高级,画质越来越好,可它不懂物理规律,也不懂导演想干什么。一盏灯移过去,它不知道房间里所有物体的阴影都该跟着变;人物一转身,它也不知道背后的背景得保持连贯。
达瓦自研的基座模型Latent Stage,做的正是“控制层”。渲染层好比相机,控制层就是导演。场景里有哪些物体、演员怎么走位、灯光怎么打、镜头怎么推,都由导演定。控制层把这些要素在虚拟空间里安排妥当,确保符合物理逻辑和创作意图,再交给渲染层生成最终画面。
达瓦科技CTO朱子威打了个比方:Agent(智能体)解决的是信息差,帮那些不懂专业术语的用户写出好提示词;控制层解决的是认知差,让模型真正理解一个完整的物理片场。
举个例子,画面里一盏灯突然灭了,普通视频模型可能把整段视频重新生成一遍,碰运气撞出一个黑暗场景。有控制层的模型不一样,它会先算出灯光熄灭后周围人脸的明暗对比、环境色的变化,连反射光减弱也算进去,然后只针对这些变化部分渲染。背景、人物姿态这些没变的,直接复用之前的状态。
这么做带来的直接好处是“少抽卡”。以前可能得生成二十次才能蒙对一个正确镜头,现在靠精准控制,三四次就能拿到满意结果。朱子威表示,这能让总体制作成本下降50%到60%。就像打仗,与其用一万发便宜炮弹盲目轰炸,不如打一发精准制导导弹,单发成本是高,可总账更划算。
180TB“过程数据”构筑的壁垒
控制层模型之所以能懂“导演思维”,靠的不是通用的互联网视频数据,而是达瓦在真实片场里攒下的“过程数据”。
从2014年开始运营科技片场起,达瓦记录了大量影视拍摄的全过程。这些数据不只是最终成片画面,还包括剧本、机位坐标、灯光参数、道具摆放位置、演员的动作捕捉轨迹等。所有信息都打上时间戳,同步记在同一根时间轴上。
眼下,达瓦积累的结构化世界状态数据约有180TB。朱子威形容,主流视频模型是用眼睛看视频学炒菜,只看得见菜出锅的样子;达瓦的模型是真正“进过厨房”,备菜、选料、火候每一步的细节都清楚。
真实拍摄数据毕竟有限,达瓦还采购了英伟达Omniverse和Cosmos的企业授权,搭起仿真环境。通过数字孪生技术批量生成带物理约束的仿真数据,比如火焰怎么蔓延、积雪怎么融化、植物怎么生长。这些仿真数据与真实拍摄数据结合,训练出了目前的34B参数基座模型。
这个模型采用MoE(混合专家)架构,把人物动作、镜头语言、灯光效果等要素拆给不同的“专家”处理。数据经过高度压缩,纯像素噪声也去掉了,模型在剧集和非超大制作的动作戏范围内,已经表现出很强的控制力。
这就构成了达瓦的商业飞轮:片场生产内容,沉淀为训练数据;数据训练出更好的模型;模型赋能FilmOS和Scenes AI产品,提高生产效率;高效的生产又吸引更多客户,带来新的数据。随着真实实拍项目减少,这种靠长期积累形成的数据壁垒,后来者很难在短时间内复制。
一张显卡跑通实时世界模型
除了离线生成的FilmOS,达瓦另一款受关注的产品是实时世界模型Scenes AI。
传统世界模型或视频生成模型对算力要求极高,通常得靠大规模GPU集群。达瓦用“稀疏扩散自回归”架构,把推理成本大幅压了下来。
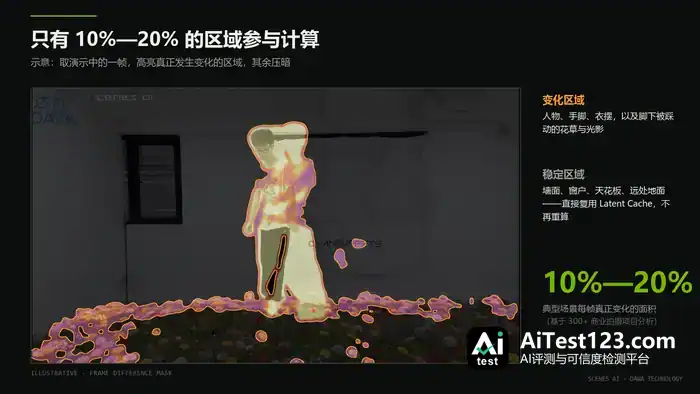
原理其实不难懂:真实世界里,每一帧画面中真正在变的区域通常只占10%到20%。两个人坐着聊天,背景墙壁、地板、天花板都是静止的。Scenes AI不会每帧都把整个画面重算一遍,而是复用稳定区域的空间状态,算力只集中在变化的人物和交互物体上。
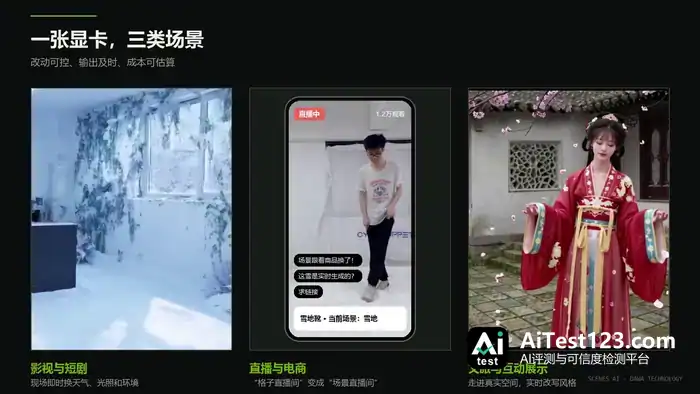
这套架构让GPU消耗降低约60%,推理速度提升3到5倍。目前Scenes AI能在单张消费级显卡(如RTX 4090或未来的5090)上,实现720P分辨率、每秒30帧的实时生成。
AI视频生成不必再拴在云端。达瓦科技把这套能力放到了终端设备上。
演示里的效果挺直观:会议室背景实时换成玉龙雪山,雪花落在肩头,伸手就能拍掉;办公室也能一秒变成玫瑰森林。放到AR眼镜上,想象空间更大——眼前的房间能被实时重新渲染,椅子成了冰封王座,宠物成了精灵,穿模、露线都没有出现。
达瓦科技CPO李宗兴把这看作通向Physical AI(物理人工智能)的关键一步。在他看来,机器人理解世界不能只靠视觉识别,还得弄懂空间关系和物理因果。Scenes AI干的本质上是物理推理:判断寒冰会影响多大范围、温度怎么变化。这类能力以后可以直接搬到机器人训练里去用。
从项目交付到“世界登录器”
达瓦眼下的收入主要来自两块:内容制作和API调用。客户批量买Token,用在影视、广告和短剧制作上。FilmOS是离线生成平台,卖给客户的是确定的结果,过程则不确定。
李宗兴透露,达瓦想把商业模式从项目制转向License授权——把实时世界模型部署到客户设备上,按期收取授权费。按照这个设想,Scenes AI会成为人们进入虚拟世界的“登录器”:打开电脑或者戴上眼镜,就能走进一个完全仿真、可交互的世界。
落地节奏也排好了。2027年,达瓦计划重点推直播电商和游戏化产品。直播里主播能实时切换场景,互动体验更强;游戏里AI可以实时生成NPC和道具,传统AR游戏必须先生产内容的那道限制就不存在了。
大厂在视频大模型上砸下巨额投入,达瓦并不焦虑。朱子威的看法是,视频基座模型做得越大,对达瓦越是好事:渲染层的上限被抬高了,控制层的价值反而更突出。大厂算的是投产比,达瓦手里有的是经过真实业务验证的数据闭环,以及对垂直场景的深刻理解。
在AI技术快速迭代的当下,达瓦科技给出了一个不同的样本:不去挤通用大模型的规模竞赛,而是扎进产业痛点,把传统业务变成数据矿藏,沿着“重控制、轻渲染”的务实路线,一步步解开AI视频工业化的死结。
朱子威说过一句话:“越难收集的数据,越有价值。”算法开源、算力普及的今天,那些藏在真实世界褶皱里的结构化数据,或许才是通往下一代AI应用最坚实的门票。