

起点番茄接连出手,网文平台为何集体对AI文说“不”
网文界今年发生了多场“AI斩杀”。2月和5月,番茄进行了针对AI低质内容的专项治理; 起点7月全面禁止AI文,8月一口气处理了上百本AI小说,其中有多部万订作品;10月30日,起点和QQ阅读发布公告,称将进一步打击签约作品滥用AI的行为,取消对作品的福利发放。 起点新发布的公告 然而,多轮治理后,读者仍然会抱怨榜单上的
今年网文圈经历了好几轮“AI斩杀”。2月和5月,番茄先后针对AI低质内容做了专项治理;起点7月全面禁止AI文,8月一次性处理上百本AI小说,其中多部是万订作品;10月30日,起点和QQ阅读发公告,表示将进一步打击签约作品滥用AI,并取消对这类作品的福利发放。
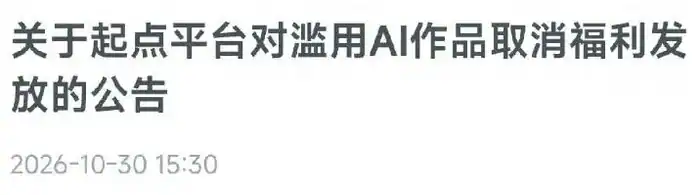
起点新发布的公告
不过,治理了一轮又一轮,读者还是会在榜单上撞见“AI写的”作品。
短剧圈对AI一片追捧,网文界却偏要说不,这到底是为什么?
网文平台拒绝AI,仅仅是因为“不好看”吗?
“写得多”曾经是网文竞争的一道门槛。
多年前我研究过能不能转去写网文,结果被两个大问题卡住了:1、想在晋江入V拿全勤,日更3000字是基础;2、我的大纲很精彩,全稿像科普……嘿嘿。
日更3000到5000字只是普通水平,一些大神把更新量拉到了让人咋舌的地步。头部中的头部,唐家三少曾日更8000字,《大奉打更人》的作者卖报小郎君同样如此。
从天明写到天黑,键盘搓到起火,腰椎肝到突出,这是网文作者的常态。
更新字数很大程度上影响着网文的曝光量和收入。起点曾经的全勤奖门槛,就是VIP章节日更4000以上。可AI出现之后,日更多少字已经不再能给网文作者带来加成了。
今年5月,起点上有个作者惹了众怒。《战锤大贤者的维度穿越》8个月更新470多万字,平均日更2万字。这么惊人的更新量,你应该能猜出这本书的AI比例。确实,这本书的编辑曾公开表示,他的这本书就是由豆包来操刀的。
该书作者还公开嘲讽AI时代仍坚持手搓的老艺术家们。事件发酵后,该书被起点下榜处罚。
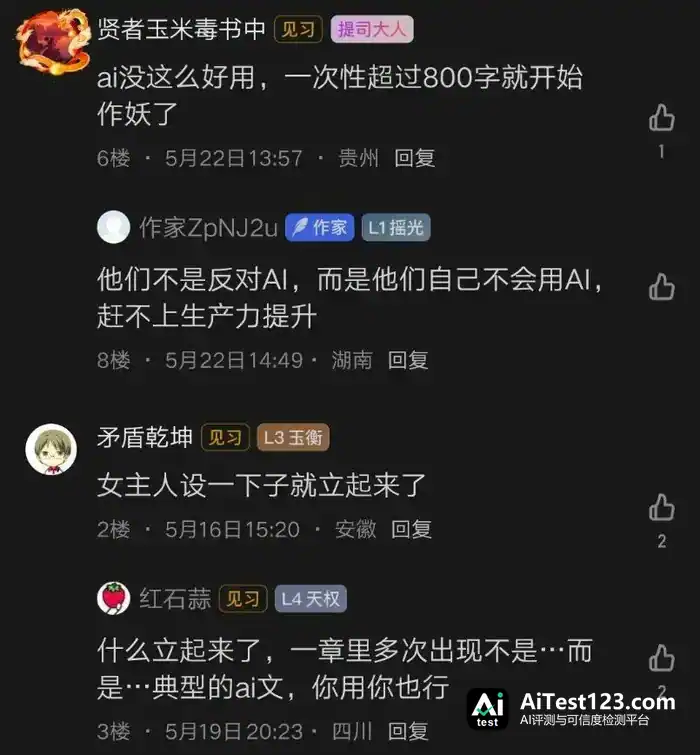
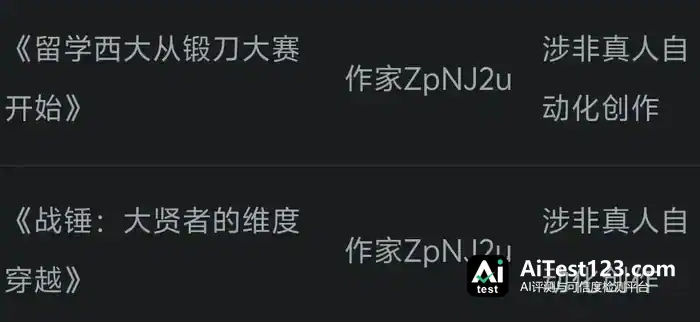
这些恐怕称不上原创的书,正快速攫取着曾经属于原创者的那部分利益,平台的真金白银奖励流向了错误的对象。这恐怕就是网文平台要斩杀AI文的原因。
番茄的遭遇就是个现成案例。这家平台当初对AI生成内容几乎不设门槛,还出过“卖稿条款”,让作者授权把自己的作品拿去喂AI训练。结果呢,一批工作室用流水线方式批量生产低质薅流量文,把平台半边天占了,扶持资源被薅得所剩无几,正经原创作者分到的流量被挤掉大半,读者那边也骂声不断。
起点读者的愤怒更是可以预见的:AI生成的东西,你还想要我按字付费?
一旦沾上AI嫌疑,版权交易也会受牵连。对网文作者来说,卖版权是重要的变现路子,平台同样看重这块。今年7月底,尼日利亚作家杰里·阿德达约·法拉德的处女作《给我打电话,我会藏尸体》(Call Me, I'll Hide The Body)报价一度冲到200万美元以上,两位经纪人分别在英国和美国谈成了六位数和七位数的版权交易,影视改编方也表现出了兴趣。
可转眼间,这200万美元就泡汤了。原因在于,这部小说被认定有AI代笔的嫌疑。作家本人反复强调整本书是自己一字一句写出来的,但出版商眼下对疑似AI创作的小说格外小心。
任何网文的爽点,都能被AI快速拆解
批量制作爆款的小说创作者(或者说工作室),通常会建立一个可自动化批量复制的工作流。
第一步是拆解爆文。网文制造出来的爽,本来就是可以被结构化分析的。
把整篇文章交给AI去分析,它读的不光是字词句,还包括故事运转的整套逻辑:整体设计怎么搭、人物处境怎么设置才能抓住读者?主角想要什么、卡在哪儿、又怎么反打?靠金手指一路升级,还是扮猪吃老虎?哪些信息压着不透露,悬念才最足?
一个爆款框架被拆开之后,工作室手里就有了若干张结构表,人物关系、情节节点、情绪回报、章节功能全在里面。这些要素换个形式重新拼装,一批新故事方案就能成批产出。
我常年付费追知乎短篇,拿它举例:人设可以是上辈子被辜负的侯府主母、被驸马背叛的公主、错信了小人的高门嫡女;情节可以是夫君的白月光、先婚后爱的错位、明明爱你却死活不开口的误会;爽点可以是听见心声、看见弹幕、反复重生。三样东西随机一拼,是不是觉得在哪儿见过?
Science Advance上刊登的一篇文章提出,生成式AI的路子会让故事被评为更有创意、文笔更好,在本身创造力偏低的作者身上尤其明显;问题在于,AI写出来的故事彼此之间太相似了。
换句话说,生成式AI让单个作者的创造力变强了,但整个群体写出来的东西反而没那么多元。这就是代价。
那问题来了:只拿AI润色文字,到底算不算AI创作?
起点这轮清理掉的网文里,不少作者喊冤,说自己就是手打完之后让AI查查病句错句、顺手润色一下。有人还把改前改后的稿子贴出来对比。
可即便底稿是人写的,AI润色照样可能把不同作者的文风拉得越来越像。像到什么程度?有时候是像成一样的烂。
有研究就测过这件事:用AI润色前后,写作复杂度的差异缩小了21%~50%。这跟生成式AI本身的运作方式有关。
多数生成式AI写东西,走的还是按前文猜后文的路子——预测接下来可能出现什么,再从里头挑概率高的词,一路这么续下去。放到某些上下文场景里,有些表达天生就比别的更容易被大模型选中。
举个例子,这个例子你肯定眼熟:
我想先接住你的情绪,你不是太敏感,而是长期没有被真正看见。说到底,你需要的或许不是一个答案,而是允许自己先停下来。
够典吧?真是太典了。
不过“接住情绪”这个说法不是AI发明的。更早的一些心理学文章里,就有“适当接住对方的情绪”这类表达。
等生成式AI把这种表达收进语料库,接住的用法就彻底泛滥了。现在接住的不光是情绪,还能接住某个人、某件事、某个场景、某个问题,什么都能接。我自己都数不清,在多少篇“手搓+AI润色”的文章里撞见过“接住”。
AI润色看上去保留了作者原来的观点,只是把句子捋得更顺。其实它干的是另一件事:把人类原本五花八门、天马行空的表达,压成几种高频出现的通用模板。
我们说的词语和语句,不光是在讲故事,也在讲我们是谁、我们怎么看事情、我们待在什么环境里、身处什么社会。一个人输出的语言和文字,能露出的东西比想象中多——三观,甚至心理健康的状况,都能从中诊断和追踪。
读文学作品的时候,我们有时候不只是在读作品,也是在借作品认识作者的精神世界。可文字一旦过了AI润色的手,那个原本能从字里行间认出来的“我”,就不见了。
那再说回网文评论区,有件事特别常见——“你这是AI写的吧?”
网文圈的AI泛滥先聊到这儿。现在很多人爱在网上甩一段文字出来,问一句:这AI味重不重?
我们也请你来测一测。下面这段,你觉得像AI写的吗:
他那么站了一会儿以后,听到一个如钟声一样的声音:
“阮进武是你什么人?”
声音在庙宇里发出了嗡嗡的回音。
阮海阔环顾四周,他的目光被光柱破坏,无法看到光柱之外。
“是我父亲。”阮海阔回答。
声音变成了河水流动似的笑声,然后又问:
“你身后的可是梅花剑?”
“是梅花剑。
“要是你也觉得这段话AI味很重,那挺巧,说明你也爱琢磨AI,还有自己的看法。
可这段话偏偏是余华写的。是不是上当了?发表在Nature上的一项研究,玩的也是这一套。
研究人员找来10位诗人,还有1634名参与者。每人随机分到一位诗人,读他名下的10首诗——5首出自本人之手,另外5首由GPT3.5仿写。
判断下来,参与者的准确率只有46.6%,比瞎猜还低。给所有诗歌排“人味”名次,垫底的那5首全是真人写的。
人眼鉴AI会看走眼,换成AI来鉴AI呢?坏消息是,一样不靠谱。
AI检测器常见的路数,是看文字有多好预测,从结果倒推它是不是AI生成的;另一种做法,是拿人类写作样本和不同模型的生成样本,训练一个AI文本分类器。起点的检测工具“墨瞳”据说看的是“作品指纹”,专找那些不像人类谋篇布局的特征。
可不管用哪种办法,AI都会判错,眼下低误报率和高检出率没法同时拿到。不少网文平台早就配上了鉴定工具,榜单上照样有AI文,原因就在这儿。是宁可错杀也不放过,还是睁一只眼闭一只眼、别冤枉了真人?平台大概也两头为难。
参考文献
[1]https://www.thebookseller.com/news/it-was-inevitable-agents-react-to-major-book-deal-that-collapsed-over-suspected-ai-use?utm_source=chatgpt.com
[2]Porter, B., Machery, E. AI-generated poetry is indistinguishable from human-written poetry and is rated more favorably. Sci Rep 14, 26133 (2024).
[3]https://arxiv.org/html/2502.11266v2?utm_source=chatgpt.com














