文心无限OCR 2开源:3600页《哈利·波特》整本读完,页数上限被打破

资讯 网易科技 作者:网易 全文 2447 字 · 约 7 分钟读完 配图 2 张 分类百度开源

sina qqZone renren ydCloud 0

所属频道 大厂动态开源生态

7本书、合计3600页,一口气全部读完,是什么体验?

10月27日,百度对外发布并开源文心无限OCR 2(Unlimited OCR 2),号称是全球首次做到这一步:OCR的处理上限从数十页被拉到无限页;《哈利·波特》全系列7部、累计超3600页,也被它一次读完。

读小说并非重点。真正的看点是:一份文档可以被整本读懂,不必再一页页拼接,AI改造知识工作的地基因此又垫高了一层。

下面不吹不黑,说三件事:它治好了哪些老毛病、靠什么做到、百度选择开源究竟在盘算什么。

一、页数自由,解决的是知识工作者的真痛点
文心无限OCR 2开源:3600页《哈利·波特》整本读完,页数上限被打破(配图 1)

传统OCR主要做两件事,可这两件事都带着硬伤:

  • 单页识别:一回只盯一页,多页文档只能识别完再拼起来,一碰上跨页表格、跨页引用就直接崩。
  • 多页拼接:第一代Unlimited OCR把范围扩到了连续数十页,可再往上走,算力和显存就顶不住了。

现实里要处理的文档,很少只有一页:券商研报动辄两三百页,上市公司年报四五百页,医学文献和专利动辄上千页,整本书更是几千页起步。AI能不能真正接手读文档这件事,说到底取决于它能读多少页。

文心无限OCR 2的卖点,正是把这条上限从几十页推到任意页数,而且页数暴涨时精度与效率都还稳得住。按官方说法,这是从OCR 2.0(单页/拼接)迈入OCR 3.0(整本理解)。

对普通人来说意味着什么?以后一整本合同、一整套财报、一柜子病历交给AI,它不用再翻到第几页去找,而是整本吃进去再回答。RAG(检索增强生成)、企业知识库,以及法务、医疗、出版这些最依赖文档的行业,会直接受益。

二、技术内核:它凭什么做到?一句话,像人抄书
文心无限OCR 2开源:3600页《哈利·波特》整本读完,页数上限被打破(配图 2)

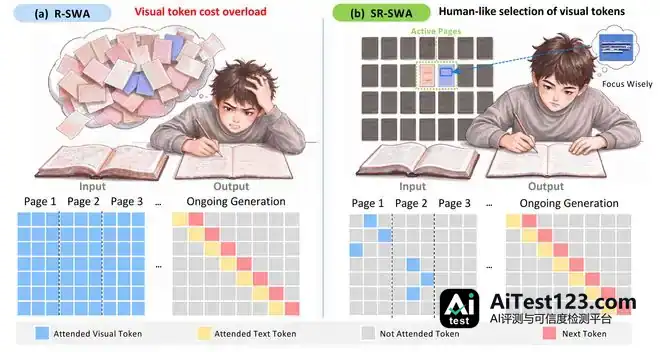
模型采用的机制叫SR-SWA(稀疏参考滑动窗口注意力,Sparse Reference Sliding Window Attention)。名字听着唬人,思路却很朴素:

人抄一本书时,多数时间只盯着当前这页;要核对前文或者找跨页信息,才翻回去看几眼,不会把整本书反复通读。

SR-SWA把这个直觉搬进了注意力计算:

  1. 页面门控(Page Gate):先收缩每个查询的视觉参考范围,从整本文档缩到相关页面,并建模跨页位置关系,无关页面直接跳过。
  2. Token Buckets(视觉Token桶):挑出得分最高的视觉Token,捕捉长距离的视觉依赖,该回看时精准回看。

落到工程上就是质变。官方报告称,百页文档场景下,单步解码速度比Full Attention提升7倍,比上一代R-SWA提升5.6倍;再叠加无限解码机制(Unlimited-Horizon Decoding),超长文档的计算与显存开销被进一步压低。

说白了,快不是靠堆参数堆出来的,而是把冗余计算砍掉了。能真正商用,关键就在这里。

三、开源这一步,百度打的什么算盘?

看看一代的战绩就明白了:6月22日发布,次日拿下GitHub Daily Trending总榜和Python榜、HuggingFace全球模型总趋势榜和多模态榜,四榜第一;5天GitHub Star破1万。截至目前,HuggingFace累计下载破1000万次,GitHub 2.85万Star,图灵奖得主杨立昆(Yann LeCun)也转发推荐过。

OCR 2沿着同一条路走:代码和权重同步开源到GitHub、HuggingFace,同时上线百度智能云与百度AI开放平台。

开源不等于做慈善。在文档解析这条垂直赛道上,百度想要的是两样东西:

  • 标准话语权:谁的开源生态先长起来,谁的接口和范式就会成为事实标准。
  • 开发者心智这块,一个能冲到榜首、还能被LeCun转发的开源项目,本身就是最划算的技术品牌广告。投流没它便宜,通稿也没它可信。

跟闭源API那条路比,开源等于拿"能力"去换"生态入口"。中小企业跟开发者呢,原本得花大价钱买的底层能力,现在免费就到手了。

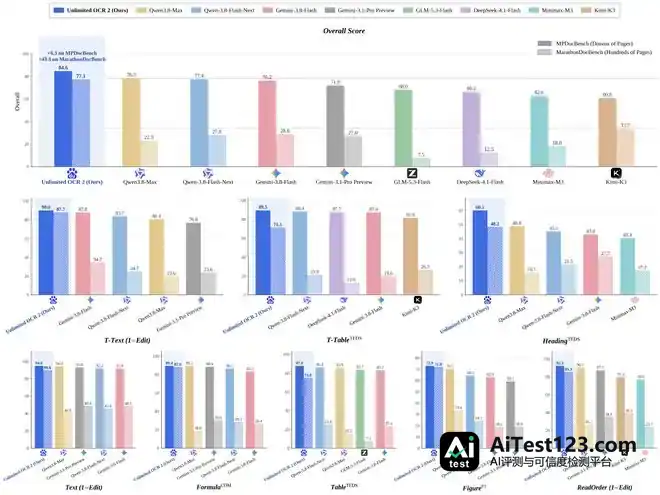
四、竞技场:和Qwen、Gemini、GLM、DeepSeek比,怎么看?据百度公布的公开基准,面向多页文档的MPDocBench上,文心无限OCR 2综合得分84.6;专测百页级超长文档的MarathonDocBench上,得分77.1。端到端达到SOTA,压过Qwen 3.8-Max、Gemini-3.8-Flash、GLM-5.3-Flash、DeepSeek-4.1-Flash等模型。

一句提醒:benchmark是厂商自己跑、自己发的,名次看看就好。真正分高下,还得看开源之后社区复现和落地案例。文档解析的护城河最终不在榜单,而在"谁被用得最多"。

五、冷静一下:别神话,也别小看。几点实在话:

  1. 开源≠零成本。模型能下,但跑起来要算力、要显存,"页数无限"背后是实打实的硬件账单。
  2. 极端长文档的精度衰减,得等社区大量实测。发布当天的数据再漂亮,也只是"官方样本"。
  3. 它解决的是"读得下",不是"读得懂"。解析准确只是第一步,真正理解、推理、生成,还得看上层大模型。OCR 3.0是地基,不是楼。

反过来讲,地基这块也不能轻视。只要出现一次“原先干不成的事如今干成了”,就会带出一批新应用。文档解析这回放开限制,很可能会催生一波新花样,比如“整本知识库”“一键读财报”“古籍数字化”。

结语:下一幕落在“智能组织”上。百度世界2026大会定在11月12日,主题正是“下一幕,智能组织”。文档解析表面看只是个小技术,实际却是“组织把知识喂给AI”的头一道闸门。百度选择开源、把它推到SOTA,押的就是这么一件事:等千千万万开发者都用上“页数自由”,智能组织的地基里能留下自己的一块砖。

对咱们普通人来说,记住一句话就够了——以后别再一页页给AI喂文档了,整本丢进去的时代,开始了。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 具身智能工程生态战:FluxVLA Engine升级,推理最高提速至7.4Hz

    开源工程底座 FluxVLA Engine 技术报告全解读。 作者丨邓哲敏 编辑丨齐铖湧 一个模型在论文中取得好成绩,距离它真正驱动机器人完成任务,还有多远? 模型能否接入现有的数据与训练流程,推理速度能否跟上机器人的控制节奏,生成的动作能否连续、稳定地执行,实验结果又能否在不同机器人上得到验证——这些问题,未必能靠再

    来源 AI 行业观察
  2. 文心5.1:不拼参数拼省钱,弹性预训练怎么做?

    2026年国内大模型市场格局已定:百度文心5.1用6%成本追平效果,阿里Qwen 3.8-Max堆到2.4万亿参数,腾讯混元Hy4、月之暗面Kimi K3等纷纷开源。本文梳理互联网巨头与AI独角兽的核心产品,从参数规模、架构设计到定价策略,呈现真实的产业竞争图景。

    来源 AI 应用前沿
  3. 当DeepSeek成为一种亚文化

    亚文化符号 这个世界上可能存在两个DeepSeek。 一个是以技术更新、融资动态为核心的AI公司,它最近开源推理框架、完成新一轮1000亿元融资的消息刷屏,频繁引发讨论。“DeepSeek何时上市”也是AI圈里的热门话题。 一个是年轻人中正在流行的二创对象。 它拥有了更多名字,比如“大肥鱼”(因鲸鱼Logo而来),基于

    来源 AI 行业观察
  4. KRAFTON AI推出Raon-1 mini预览:30B-A4B开源模型面向韩语

    IT之家 10 月 25 日消息,韩国知名游戏企业 KRAFTON(魁匠团)旗下人工智能分支 KRAFTON AI 本周公布了其从头训练的 Raon-1 mini 模型的预览版本,该模型的正式版和后续的更大模型即将推出。 Raon-1 mini 采用混合专家架构,导入线性注意力,支持推测解码,整体体量为 30B-A4B

    来源 AI 行业观察
  5. 百度健康好医加号:日供12万+加班号源,已加号近600万次

    百度App搜索“好医加号”百度健康总经理杨明璐强调,“好医加号”并不是简单给用户多开一个挂号入口,而是用AI把稀缺的专家“加班号源”与真正需要的精准患者做双向匹配。百度健康医生服务部总经理李杰进一步解释,“好医加号”全称叫“好医加班号源”,医生利用额外工作时间拿出的号源,是公益性质的服务。谈及百度健康在AI医疗赛道的定

    来源 TechWeb
  6. 百度ACG业务归属调整:阮瑜轮岗小度科技,产研形成两层格局

    近日,百度智能云事业群组(ACG)围绕业务发展进行组织调整。ACG 智能应用事业部下相关业务基于各业务属性,分别转入基础设施事业部、智能体事业部、服务交付与质量工程中心。其中,服务交付与质量工程中心更名为行业应用与技术服务中心,部门负责人保持不变,继续向沈抖汇报。同时,百度副总裁阮瑜轮岗担任小度科技组织负责人,继续向沈

    来源 TechWeb
  7. 百度ACG调整业务归属:阮瑜轮岗执掌小度科技

    近日,百度智能云事业群组(ACG)围绕业务发展进行组织调整。ACG 智能应用事业部下相关业务基于各业务属性,分别转入基础设施事业部、智能体事业部、服务交付与质量工程中心。其中,服务交付与质量工程中心更名为行业应用与技术服务中心,部门负责人保持不变,继续向沈抖汇报。同时,百度副总裁阮瑜轮岗担任小度科技组织负责人,继续向沈

    来源 TechWeb
  8. 百度智能云ACG调整组织:阮瑜轮岗小度科技,产研形成两层格局

    【TechWeb】10月28日消息,近日,百度智能云事业群组(ACG)围绕业务发展进行组织调整。ACG 智能应用事业部下相关业务基于各业务属性,分别转入基础设施事业部、智能体事业部、服务交付与质量工程中心。其中,服务交付与质量工程中心更名为行业应用与技术服务中心,部门负责人保持不变,继续向沈抖汇报。同时,百度副总裁阮瑜

    来源 AI 行业观察
  9. 奥特曼再谈闭源:中国开源模型追平,安全牌不好打了

    美国AI大模型的发展路径正经历一场耐人寻味的转向:起步阶段曾拥抱开源,如今主要巨头却集体转向闭源,OpenAI更是一度违背初心走向盈利。日前,OpenAI CEO奥特曼再次为这一选择公开辩解,理由依然是——为了大家的安全。

    来源 TechWeb
  10. DeepSeek开源DeepInfer推理框架:单集群日吞吐155万亿Tokens

    刚刚,DeepSeek宣布,正式开源大规模云服务推理框架 DeepInfer。DeepSeek表示,自身长期致力于将推理性能推向极致。基于 DeepInfer,DeepSeek已实现 DeepSeek V4.1 Flash 高吞吐、低延迟的大规模推理服务。未来,DeepSeek 新模型的推理代码及后续优化也将在此持续更

    来源 TechWeb
  11. OpenAI闭源再拿安全说事,中国开源模型已追到眼前

    美国AI大模型的发展路径正经历一场耐人寻味的转向:起步阶段曾拥抱开源,如今主要巨头却集体转向闭源,OpenAI更是一度违背初心走向盈利。日前,OpenAI CEO奥特曼再次为这一选择公开辩解,理由依然是——为了大家的安全。

    来源 TechWeb
  12. 奥特曼再辩闭源安全论,中国开源模型能力已逼近

    【TechWeb】美国AI大模型的发展路径正经历一场耐人寻味的转向:起步阶段曾拥抱开源,如今主要巨头却集体转向闭源,OpenAI更是一度违背初心走向盈利。日前,OpenAI CEO奥特曼再次为这一选择公开辩解,理由依然是——为了大家的安全。 “最先进的大模型,短期内绝不可能开源” 奥特曼在近日的采访中再度回应开源与闭源

    来源 AI 行业观察
  13. Opera推WebAI标准:浏览器本地跑AI模型,不用云端

    Opera 推出 WebAI 新 Web 标准,支持直接在浏览器本地运行开源 AI 模型,无需依赖云端服务,兼顾隐私保护与低成本优势,目前已在 Opera One 中以预览版上线,后续将登陆旗下其他浏览器。#Opera#AI#WebAI#

    来源 IT之家
  14. Opera推WebAI标准:浏览器本地跑AI模型,Opera One已开预览

    浏览器制造商Opera推出全新网络标准WebAI,旨在让用户直接在浏览器中运行AI模型,无需依赖云端服务。该标准兼容多种AI模型,Opera以谷歌开源模型Gemma为例进行演示,并表示WebAI也支持苹果设备端基础模型。该技术不依赖特定模型,主要面向各类开放权重AI系统,是Opera此前探索浏览器本地运行大语言模型工作

    来源 AI 开发者社区
向下滚动自动加载更多