

IQuestRT引擎:8卡GPU解码910.70 tokens/s,达vLLM的2.94倍
推理提速近3倍!Agent下场调引擎,两周反超人工精调

新智元报道
新智元报道

Coding Agent的兴起,正给大模型推理带来新的性能压力。在软件工程任务里,模型得反复读代码、写修改、调工具,再依据执行结果定下一步。
这些环节之间常常有先后依赖。哪怕算力管够,每一轮Token生成中的等待也会一点点叠加起来,拖慢整个任务。
于是,怎么让单条请求的生成过程一直高效跑下去,成了推理系统优化绕不开的课题。
至知创新研究院(IQuest Research)近日发布并开源了IQuestRT,这是面向IQuest-Q1的专用推理运行优化引擎。
官方技术报告给出的数据是:8卡高性能GPU、单请求条件下,IQuestRT实测解码吞吐量达到910.70 tokens/s,为vLLM参考配置的2.94倍。
成绩背后是一批底层改动——解码循环交给GPU自主控制,投机预测深度动态决定,可能用到的专家权重提前加载,跨GPU通信中的同步等待也被压缩。
另有一处细节:AI Agent同样参与了IQuestRT的底层研发。多个Agent并行做代码实现、性能实验和调试,只用两周,相关优化成果就超过了团队此前人工精细调优的计算流水线。
模型跑得更快,推理引擎的研发方式也在变。IQuestRT把这两条路都摆了出来。
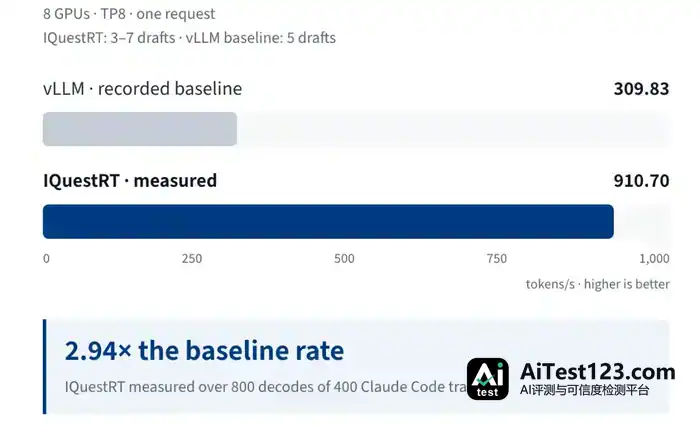
看单请求解码吞吐量,IQuestRT和vLLM参考配置的对比结果如下。

过去衡量大模型推理性能,看的多是吞吐量、延迟这些指标。可放到Coding Agent这类应用上,光看这些不够,还得盯住任务是怎么执行的。
比如用户让模型改一个代码项目,模型往往先找文件、弄明白问题,然后写代码、调用测试工具。测试没过,它还得顺着报错接着分析、接着改。
这期间,模型生成的内容一直在决定下一步做什么。像这种连续交互的任务,每一轮生成快不快,直接关系到下一步动作什么时候能开始。
IQuestRT服务的对象是IQuest-Q1,这是至知创新研究院开源的基础模型。它走稀疏混合专家(MoE)架构,总参数约320B,每个Token激活约15B参数,主要用在代码生成、软件工程、推理和多步工具调用这些任务上。
推理时,IQuest-Q1用的是递归多Token预测(MTP)机制。草稿网络反复运行,连续给出多个候选Token,再由主模型统一验证,一次计算能产出的有效Token数量就此提高。
多Token预测同时带出新的工程麻烦:每生成一轮,候选验证、采样、缓存更新和后续预测都得走一遍,背后还牵扯大量GPU计算任务的启动、模型权重读取以及跨卡数据交换。这类操作单次可能只花几十微秒,可在连续生成中会一遍遍重复出现。
放到单请求、小批量的场景里,调度、同步和数据搬运带来的等待就成了拖性能的关键因素。
IQuestRT的做法,是紧扣IQuest-Q1的计算结构,把整个投机解码流程系统性地优化一遍。

IQuestRT先动的是GPU和CPU之间的执行关系。有些常规推理实现里,GPU跑完一轮,得等CPU读结果、更新状态,再发起下一轮任务,这期间GPU可能一直在等主机完成操作。
而IQuestRT把更多控制逻辑直接搬到了GPU上:候选Token验证、采样、缓存更新,连同下一轮计算的启动,都能在GPU内部搞定。CPU只负责发起第一轮任务,等整个生成过程结束再读结果。
由此,连续解码时那种反复出现的主机控制间隔被压短了。
技术报告里的配对重放实验显示,把主机端的控制间隔去掉之后,每轮计算大约省下22—25微秒;再往后把执行边界收得更紧,又多拿到约3微秒。

CPU控制循环与IQuestRT GPU自主解码循环的对比
投机解码同样用上了GPU自主控制。
提前多提一些候选Token,主模型就有机会一次验证、接受更多内容。可多出来的预测本身也要算。后续候选带来的预期收益不够时,接着生成反倒可能更费时间。
于是IQuestRT加了一套动态投机深度策略。
每轮计算先固定跑前三个预测深度,后面由GPU看着已生成的候选Token,连同它们的概率、熵等信息,判断继续预测值不值得多花这份计算成本。
整轮下来最多产出七个候选Token。
有了这套设计,系统能按当前生成状态定预测深度,收益不够就停掉额外计算。
从削减CPU参与,到动态决定下一步算什么,IQuestRT想让GPU在连续解码时掌握更完整的执行控制权。

GPU调度之外,IQuestRT对MoE模型的专家路由和参数读取也做了深入优化。
MoE模型会依据输入动态挑出参与计算的专家。小批量推理时,把专家权重从显存搬到计算所需位置,这段等待可能带来不小的开销。
IQuestRT的做法是提前预取:正式路由结果还没出来,先预测哪些专家可能被调用,再把对应权重装进GPU的L2缓存。
等到后续计算真正需要这些权重,一部分数据已经就位。
问题是,提前预取也要占用计算资源。
团队实验发现,在滑动窗口注意力层中,有效验证位置为4至5个时,预取能带来收益;位置增至6至8个时,预取成本反超收益。
所以,IQuestRT只在合适的计算路径上开启预取。
另外,预测结果只决定哪些权重被提前放进缓存,真正参与计算的专家,仍由模型的正式路由结果说了算。
再一个优化方向,是减少独立GPU Kernel的启动次数。
研究团队把原本单独跑的专家路由计算,并进注意力相关的既有计算流程。初版路由融合方案在轨迹重放测试中,每轮计算省下88.5微秒。
跨GPU通信也有可挖的空间。
IQuest-Q1跑在8路张量并行的配置下,一次计算要由多张GPU合力完成。这些GPU之间不光得传数据,还得互相确认对方有没有把结果写进去。
针对这个环节,IQuestRT想出的办法是用NaN标记来做同步和归约。
NaN是浮点运算里的一种特殊数值标记。系统的做法是先把输出缓冲区整片填成NaN,等各张GPU算完,再用真实数据把这些位置盖掉。
跨GPU归约出来的结果里如果还留着NaN,就说明起码有一部分数据没写完;反过来,结果里查不到NaN了,系统就能接着处理那些已经就绪的数据。
这么一来,判断数据是否就绪和归约结果被放到了同一步里,多余的同步操作就省掉了。

IQuestRT依靠NaN标记实现的跨GPU数据同步与归约机制
上述改动落在推理过程中反复出现的几个环节:计算调度、数据加载和通信。单独看,一项改进也许只抢回数十微秒,可执行轮次一多、模型层数一深,这些收益累加起来就会作用到整体生成速度上。
不过,计算路径一变,浮点数值结果也可能跟着变。
技术报告里写得很清楚:部分路由融合操作在数值计算方式上与原实现并不相同;FP8激活以及归约顺序调整带来的影响,还得拿更高精度的参考实现单独验证。
这其实是推理系统底层优化绕不开的一道题:计算时间要压短,同时还得盯着数值变化、Token接受行为和最终生成结果。

官方技术报告给出了测试口径:400条Claude Code运行轨迹,两个随机种子,共完成800次解码测试。
采样参数沿用IQuest-Q1的推荐设置——temperature=1、top-k=20、top-p=0.95。
硬件条件为8卡高性能GPU、8路张量并行,只发一个请求,IQuestRT在这样的环境下跑出910.70 tokens/s的解码吞吐量。
再往下拆:每轮投机解码平均输出3.24个有效Token,一轮大约耗时3.558毫秒,摊到每个输出Token约1.098毫秒。
团队同时记下了vLLM参考配置的吞吐量:309.83 tokens/s。两相比较,IQuestRT在这组测试里达到前者的2.94倍。
不过双方的投机策略并不一样:vLLM参考配置固定用五个候选,IQuestRT则在三到七个候选之间动态挑选。这组结果说明的是特定软硬件与推理策略搭配下的整体性能差距。
技术报告里还有一项长上下文单步计算测试。
该测试固定五候选、使用合成KV缓存,单独进行。上下文长度从1K加到192K,中位单步延迟从3.23毫秒涨到3.76毫秒,涨幅约16%。
它的测量方式与前面400条运行轨迹那组不同,看的是指定计算条件下单步延迟怎么变。
另外要说明,910.70 tokens/s只衡量Decode阶段,候选验证、采样、递归预测、缓存处理都算在里面,Prefill、模型加载、计算图捕获等开销没有计入。
所以,单请求解码吞吐量是一回事,完整任务耗时、多请求并发服务吞吐量是另一回事,两者要分开看。
不过,智能体应用要连续生成代码、工具指令和推理内容,能把单请求生成阶段的等待时间压下来,仍有直接的技术意义。

IQuestRT另有一个特点:它的研发过程里有AI Agent参与。GPU高性能计算的优化,向来要靠大量细致的工程活。
工程师得反复分析计算瓶颈,改Kernel实现、数据布局、同步方式和任务调度策略,再跑测试确认改动有没有用。可某项优化即便单独测出了收益,放进完整推理流程后,也可能被额外的调度或数据处理开销吃掉。
为此,研究团队搭了一套工程师与AI Agent共同参与的优化流程:工作负载、数值约束与验收标准由工程师定,哪些修改最终能合入代码也由工程师拍板;AI Agent则负责读代码、提优化假设、实现方案、跑实验、调试和代码审查。
每项实验都留下对应的代码版本、测试环境和原始结果,方便日后对比与复现。实际运行轨迹还帮团队找出了合成测试容易盖住的问题。
一次性能分析里,KV缓存读取长度明明一样,实际请求的单轮解码还是比合成测试慢了约0.36毫秒。团队把原因追到了MoE模型的专家访问上。
数据能说明问题:实际请求平均每层要碰37.7个不同专家,合成输入只有11.0个。访问的专家越分散,权重读取就越多,缓存复用效率也跟着往下掉。
团队据此改了实验方法——凡是可能影响专家权重访问的优化,都得放回实际运行轨迹里验证性能收益,光看合成测试不算数。
自动化实验也跑出过失败方案。团队试过把专家权重进一步压到FP4,本意是减少参数读取开销。测试下来,额外的数据解包与计算调度成本把权重存储省下的收益抵消了,这个方案最终没有采用。
整个IQuestRT研发历程一共留下32个优化检查点。从工程师写的初始实现,到后来的计算融合、通信优化、动态投机解码及GPU自主循环等改进,记录中的单步延迟由6.449毫秒降到3.526毫秒,累计下降约45.3%。
这组数字讲的是整个系统的优化历程,和前面vLLM参考配置的对照不是同一组测试。

IQuestRT研发过程中的32个优化检查点及单步延迟变化
研发方法上,团队花了一个多月摸索,逐步搭起一套由Agent参与的自动化优化与验证流程。
IQuest-Q1发布之后,多个AI Agent被安排在多台GPU服务器上,同时推进单请求推理优化。
技术报告给出的结论是:这轮优化只花了两周,性能就超过了团队此前人工精细调优的Tile Pipeline(分块计算流水线)。
这一结果还说明,AI Agent有能力参与复杂底层系统的研发,这条路走得通。
目标怎么定、正确性怎么约束、最终谁来把关,仍由工程师负责;Agent承担的是更多代码探索和实验验证,并且可以并行推进。
这些工作一旦沉淀为可复用的工具和流程,为具体模型开发高性能推理引擎的工程成本也有望继续下降。

IQuestRT的代码已在GitHub公开,采用Apache-2.0许可证,安装、运行和性能测试的说明一并提供。
不过,它眼下有明确的适用边界。
项目公开文档显示,IQuestRT面向IQuest-Q1以及特定的GPU计算架构和互连环境设计,要求8路张量并行、单个活动请求,其他模型、GPU架构和并行配置暂不支持。
换句话说,910.70 tokens/s 与 2.94 倍的性能数据,还是要放回对应的测试条件下去看。
从 IQuestRT 这个案例能看出,Coding Agent 这类应用开始接手更复杂、持续时间更长的任务,推理优化也随之往具体模型结构和真实工作负载里走得更深。
GPU 执行调度、投机深度怎么选、MoE 专家权重怎么读、跨卡通信怎么做——这些底层环节上的优化,会一起决定一次请求的生成效率。
另一边,让 AI Agent 参与底层性能优化,也给高性能计算软件的研发蹚出了一条新的探索路子。
专用推理引擎的性能优化一旦和自动化研发流程搭上线,今后针对不同模型搭高效推理系统,能试的工程路径或许会更多。
参考资料:















