18天短命收费终结:DeepSeek搜索抓取费用并入Token计费

资讯 AI 行业观察 作者:Suky 全文 1018 字 · 约 3 分钟读完 配图 3 张 分类DeepSeek深度求索Deepseek

【TechWeb】DeepSeek官网显示,自北京时间2026年11月18日12:00起,调用模型时触发的服务端搜索、网页抓取不再单独计费,仅按模型Token用量收费。这意味着,这项落地仅18天的按次收费机制被官方正式取消,开发者的联网调用成本结构从此变得更简单——一次请求,只看Token消耗。 短命的按次计费:从落地

所属频道 开源生态

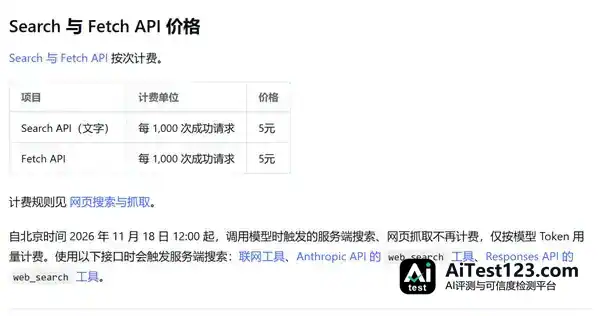
【TechWeb】DeepSeek官网显示,自北京时间2026年11月18日12:00起,调用模型时触发的服务端搜索、网页抓取不再单独计费,仅按模型Token用量收费。这意味着,这项落地仅18天的按次收费机制被官方正式取消,开发者的联网调用成本结构从此变得更简单——一次请求,只看Token消耗。
只按Token收钱!DeepSeek砍掉搜索抓取计费 刚执行18天就取消

短命的按次计费:从落地到取消仅18天

这项被取消的收费机制,实际上才刚刚起步。10月17日,DeepSeek随V4.1-Flash-1017版本发布,正式向公众开放基于自研搜索引擎的Search与Fetch接口,两个接口定价均为5元/千次成功请求。

当时官方为开发者预留了两周过渡期:DeepSeek Harness、Claude Code、Codex中的服务端工具调用暂不计费,11月1日0时起才正式按次收费。

也就是说,模型调用触发的搜索和抓取按次计费只执行了18天,便被官方叫停,相关费用全部并入模型Token计费。

哪些场景受影响?哪些不受影响?

根据官方说明,使用以下接口时会触发服务端搜索:联网工具、Anthropic API的web_search工具、Responses API的web_search工具。此次调整后,开发者在使用联网工具时,不再需要为每一次搜索单独买单。

需要注意的是,独立的Search与Fetch API不受影响,仍按5元/千次成功请求计费。换言之,本次调整针对的是模型调用过程中由服务端自动触发的搜索和抓取,而非独立的搜索服务本身。

自研搜索引擎:千亿级网页索引,日处理数亿次请求

支撑这套联网能力的,是DeepSeek的自研搜索引擎。该引擎索引了全球千亿级网页,支持多语言搜索,每天处理数亿次请求,并针对SEO作弊、GEO操纵和低质AIGC内容进行识别过滤,以保证搜索结果质量。

对开发者的意义:成本账更好算了

对开发者而言,取消按次计费最直接的变化是成本结构变得更清晰。过去,一次联网调用可能涉及“模型Token费用+搜索次数费用+抓取次数费用”多重账单;如今,账单上只剩下一项——Token消耗。对于深度集成联网工具的应用来说,这既降低了成本核算的复杂度,也消除了“每次搜索都要掂量一下”的心理负担。
只按Token收钱!DeepSeek砍掉搜索抓取计费 刚执行18天就取消

从两周过渡期到18天正式收费再到全面取消,DeepSeek在计费策略上的快速调整,也反映出AI行业在商业化探索中“跟着开发者体验走”的趋势:凡是增加使用摩擦的收费项,都可能被重新审视甚至砍掉。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. DeepSeek刚限完流,就去给开发者免单了

    AI应用风向标(公众号:ZhidxcomAI)作者|毕伟豪 编辑|漠影智东西11月19日报道,昨日,DeepSeek调整了API计费规则,自北京时间11月18日12时起,模型调用时触发的服务端搜索、网页抓取不再单独收费,仅按照模型Token用量计费。简单来说,开发者通过DeepSeek模型执行联网搜索任务,不再需要为搜

    来源 腾讯网
  2. 张博开源Linger:零token费本地跑125B模型,12GB显卡够用

    11月19日,前DeepSeek-VL项目负责人张博在X宣布开源个人Agent Linger,开发主体是张博创办的SIMPLEX AI TECHNOLOGIES PTE. LTD.(以下简称“Simplex AI”),代码已上传GitHub。按项目文档,Linger读取本地邮件、日历和文件,操作用户已登录的浏览器;连接

    来源 腾讯网
  3. 谷歌字节快手集体降价,AI视频进入分秒计价时代

    AI视频行业正在靠近一个类似DeepSeek的时刻,模型能力差距收窄,价格被打到分/秒,创作者开始批量调用。 11月初,谷歌把视频模型Gemini Omni 1.2 Flash转为正式版,不仅支持15秒视频生成和多轮对话式编辑等功能升级,还把价格打了下来,720p降到每秒0.07美元(约合0.47元/秒),比上一代低3

    来源 AI 行业观察
  4. 唐飞虎穿女仆装现身云桥大会:Kimi 工程师造型似 DeepSeek“大肥鱼”

    人工智能圈的跨界整活再添一桩趣闻。11月19日,2026云桥大会在杭州拱墅大运河杭钢公园举办,大会圆桌讨论环节的一张现场照片在网络上引发热议。照片中,月之暗面 Kimi 高级研发工程师、开发者关系负责人唐飞虎戴着银蓝色假发,身穿蓝白配色的女仆装手持话筒发言。 圆桌造型引围观:Kimi 工程师疑似扮成

    来源 AI 开发者社区
  5. DeepSeek限额免费用户:梁文锋曾称用户赶都赶不走

    (本文作者为 识礁Farsight,钛媒体经授权发布)文 | 识礁Farsight“去别的地方玩,不要耽误AGI训练。” 这句针对DeepSeek的调侃,如今正变成现实。近日,DeepSeek收紧了网页版和App免费用户的使用额度,超过7天不活跃的长对话无法继续使用,新对话单次输入的文字上限被压缩到4万字左右,连续使用

    来源 腾讯网
  6. LinkX View|万物皆插件:为什么代理框架正逐渐演变为操作系统

    模型越强,harness 越重要,但重要的方式变了。弥补模型短板的补丁正在消失,比如在长任务中“跟丢”后把模型重置。支撑智能体安全连续工作数小时的部分却在持续扩张,包括记录它做过什么、限制它能碰什么、管理它如何接入新工具。harness 正在变成类似操作系统的东西。 DeepSeek Harness 是目前最开放的大厂

    来源 AI 行业观察
  7. 张博开源Linger本地版Muse:个人电脑跑Agent,准确率95%

    智东西(公众号:zhidxcom)作者 | 黄菲编辑 | 江宇智东西11月20日报道,昨夜,前DeepSeek研究员、Simplex AI创始人张博(Tony Zhang)宣布开源个人Agent Linger,号称要让Agent摆脱对云端数据中心的依赖,直接运行在用户自己的电脑上。项目发布后迅速引发关注,GitHub星

    来源 腾讯网
  8. 【钛晨报】《中俄美元首和平宣言》发布;31家出资主体现身,DeepSeek第二轮融资落地;比亚迪发布折叠方向盘,长鑫科技拟25亿至50亿元回购股份

    燧原科技:在手订单充沛,并正在与多家国内半导体产业伙伴进行合作;吴泳铭:建设超过20GW规模全球数据中心的目标可能下调;拼多多Q3利润295亿元,同比基本持平;因150元成被执行人?格力电器最新回应;OpenAI进军手机领域;马斯克披露多项业务时间表,Optimus拟18个月内胜任家务。

    来源 AI 行业观察
  9. 蓝耘Automodel:5模型塞进1个API,混合任务能靠路由解决吗?

    蓝耘推出 Automodel,将 Gemma3、Qwen3-VL、DeepSeek-V3.2 等五个主流模型整合为单一接口。本文通过逻辑推理、代码生成及混合任务三道测试题,验证其路由调度能力,并结合 Next.js 项目实战,分析其在生产环境中提升回答多样性的实际效果,探讨模型路由技术的实用价值。

    来源 AI 应用前沿
  10. 压力给到梁文锋一边了

    出品|虎嗅科技组作者|宋思杭编辑|苗正卿头图|视觉中国DeepSeek第二轮千亿融资,落地了。近日,DeepSeek已完成工商变更,新增股东杭州程砚。这家持股平台同期新增31家合伙人,背后包括腾讯、宁德时代、中国移动、中国电信、vivo、小红书等产业资本,以及砺思、博裕、IDG等投资机构。自从DeepSeek开放融资之

    来源 腾讯网
  11. 腾讯混元Hy4 Flash实测:35分钟出可玩游戏,API价压过DeepSeek

    腾讯新发布的混元Hy4 Flash模型在速度与成本上表现激进。实测显示,它能在十几分钟内完成3D场景建模、增量游戏开发及财报分析,API价格仅为竞品的一半。通过混合注意力与Engram记忆模块等技术优化,该模型在保持高智能水平的同时,将推理成本压缩至旗舰模型的二十分之一,适合处理高频日常办公任务。

    来源 AI 应用前沿
  12. 小米MiMo:Token Plan Pro/Max套餐限时接入UltraSpeed推理模型

    IT之家 11 月 20 日消息,小米 MiMo 官方文档显示,11 月 19 日起,Token Plan 限时支持 UltraSpeed 超高速旗舰推理模型。 Token Plan 的 Pro / Max 套餐现已限时开放和支持 MiMo-V2.6-Pro-UltraSpeed 超高速推理模型,兼具旗舰级智能与更快的

    来源 AI 行业观察
  13. APEC深圳展望:算力围城怎么破,华夏时评给出分层思路

    全球人工智能赛道,正在上演一场“算力围城”。城外,头部大模型企业Anthropic登陆资本市场,抬高前沿竞争的门槛;城内,本土大模型DeepSeek拿到千亿级产业资本加持,却遇到算力芯片供给不确定性上升、算力租赁通道收紧等约束。如何跳出人工智能发展的简单追赶思维,在顶层统筹与开放协同之间找到一条突围路径?刚刚在深圳..

    来源 腾讯网
  14. 三星高管谈AI投资:Neocloud风险有限,需求真实非投机

    IT之家 11 月 20 日消息,据路透社当地时间 18 日报道,三星电子两位高管在本周举行的摩根士丹利会议上表示 Neocloud(新兴 AI 云服务企业)面临的不确定性对整体市场的影响有限,这轮 AI 投资基于实际需求而非投机。 三星 DS(设备解决方案,半导体板块)部门经营战略总管负责人 Kim Yong-kwa

    来源 AI 行业观察
  15. Claude推理引擎实测:首token延迟从12秒压到0.48秒

    人工智能智能体能否自主搭建并强化AI研发基础设施,正成为衡量前沿模型自主能力的重要标尺。卡内基梅隆大学等推出Singularity-Bench基准,设六道AI研发考题,考察其自主构建能力。测试中,Claude Opus5.5搭配Claude Code表现亮眼,在模型推理性能层实现延迟大幅压缩,并通过调度优化提升硬件产出

    来源 AI 产业速递
向下滚动自动加载更多