GPT-6.2双模型发布:Astra编程测试62分,API降价20%
美国当地时间11月17日,OpenAI正式推出GPT-6.2 Astra和GPT-6.2 Sol。
美国当地时间11月17日,OpenAI把GPT-6.2 Astra和GPT-6.2 Sol两款模型正式摆上台面。
这次亮相其实拖了。10月底就有人在ChatGPT用量记录里翻出疑似 GPT-6.2的灰测痕迹,之后模型标识、测试截图接连往外冒。媒体此前给出的最快发布时间是11月6日,实际比这个预测晚了11天。
OpenAI这回把重心放在AI接手专业工作上。
一张PPT截图能复刻出整套演示文稿;财务数据能提取,估值模型能搭;Blender里可以生成汽车三维模型,模拟车辆悬架的物理运动;连CAD设计机械零件、验证装配关系也做得下来。过去这些活都得专业人员摆弄复杂软件才能完成,GPT-6.2开始往里扎。
OpenAI特别提到,新模型能压掉无效输出和来回返工,交付结果更贴近专业工作的标准。
过去两个多月,OpenAI先后放出GPT-6 Astra、Sol、Luna,以及GPT-6.1 Sol、Terra等模型。刚发布的GPT-6.2 Astra是9月GPT-6 Astra之后的旗舰升级,主打复杂专业任务的处理能力;GPT-6.2 Sol则侧重日常工作、编程和多步骤智能体任务的效率。
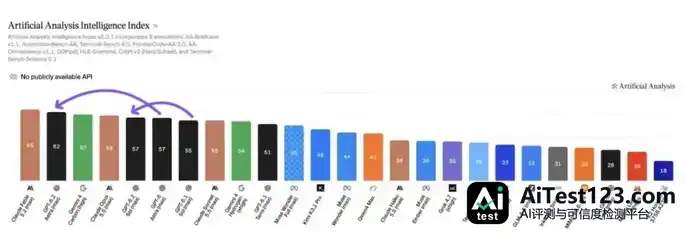
Artificial Analysis最新榜单上,Astra拿到62分,升至全球第二,比前代高5分;Sol为57分。价格上,Astra的API输入、输出单价都降了20%,缓存输入价格降60%;Sol价格不变,但完成部分任务的总体成本还在往下走。
还有一点:GPT-6.2 Astra是OpenAI首个被评估为达到AI自主改进能力“High”门槛的公开模型。
演示漂亮、跑分好看,评价却不一样。发布当天,几位提前数周试过新模型的开发者公开表示失望,理由是在长时间的软件开发任务里Astra仍可能提前收手,输出过于简洁时还会漏掉必要信息。
模型越贴近真实专业工作,能力边界和安全控制也越受关注,这成了本次发布的另一处看点。
OpenAI首席执行官山姆·奥特曼。图片经由AI生成
01、性能与成本
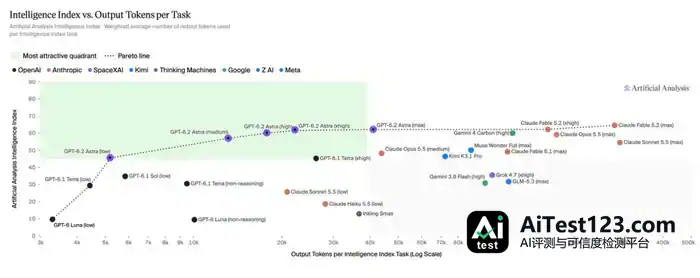
GPT-6.2 Astra的API定价为每百万输入Token 8美元、输出Token 40美元,缓存输入0.40美元。对比前代,输入和输出价格均下降20%,缓存输入从1美元降到0.40美元,降幅60%。GPT-6.2 Sol则保持每百万输入Token 2美元、输出Token 10美元。
多步骤智能体干活,API单价说明不了全部开销。模型执行任务时可能要反复调用工具、读文件、处理错误再重试。单价不动,只要完成任务耗的Token更少,账单照样会降。
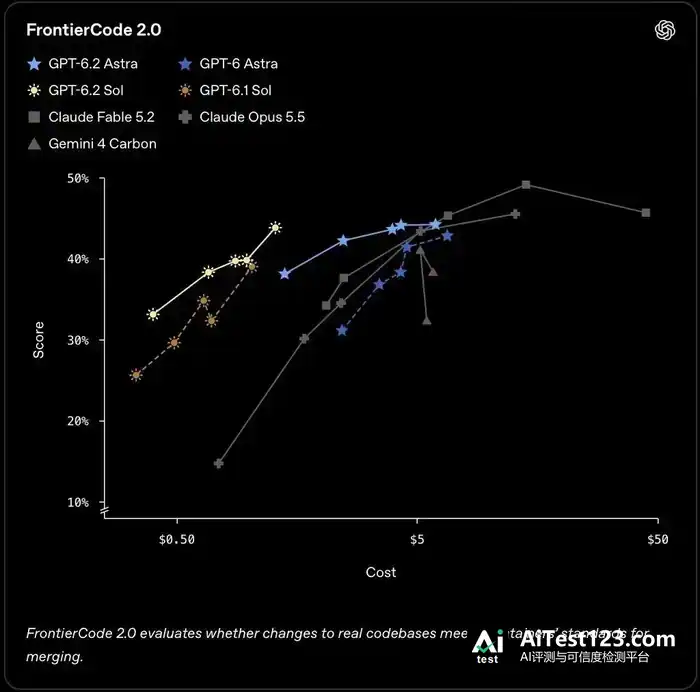
Cognition的FrontierCode 2.0编程测试里,GPT-6.2 Sol只比Astra低0.5分,成本却只有后者的五分之一左右。面向日常复杂事务的LifeVal评估中,Sol的得分超过上一代旗舰GPT-6 Astra,单项任务成本约为后者的七分之一。
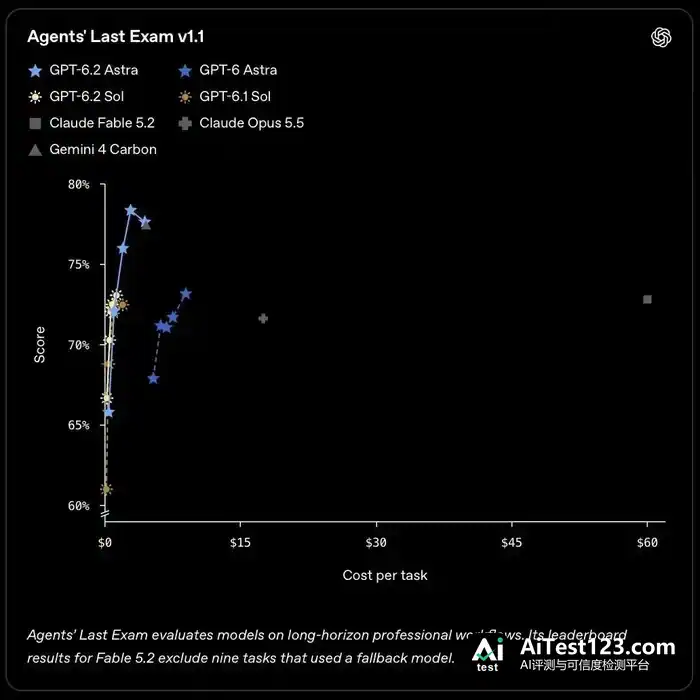
高难度任务上Astra也有长进。Agents' Last Exam评估中它比GPT-6 Astra高5.2分,完成任务成本不到前代的三分之一。对上Claude Fable 5.2,Astra得分高出5.5分,单任务成本约为后者的5%。
02、专业工作交付
财务、法律、咨询这些专业活,要求AI啃下大量原始资料、核对数据,再按行业规范交出可用的成果。OpenAI称,GPT-6.2 Astra在这类任务上表现有提升,财务建模、并购分析、法律检索、数据科学分析都能做。
OpenAI内部的GDPval v2测试覆盖咨询、金融和设计等领域,Astra得分比前代高6.2个百分点,输出Token少了22%。
法律检索这块,模拟真实律所任务的Harvey LAB-AA v1.1测试中,Astra通过率超过Claude Fable 5.2的一倍,单任务成本约为后者的六分之一。
OpenAI内部的GDPval v2覆盖咨询、金融、设计等工作。结果显示,Astra得分较前代提高6.2个百分点,输出Token减少22%。
03、进入三维世界
GPT-6.2 Astra这次还展示了另一手:直接参与3D建模和工程设计。模型不光能吐出一段建模代码,还能操作专业软件,处理零件、调整结构,把计算结果做成可视化内容。
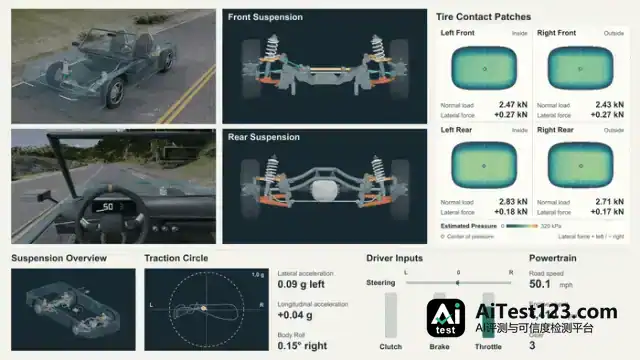
山路驾驶模拟这个案例里,Astra先建好跑车的3D模型,再写Python物理求解器,算出轮胎接地力和悬挂系统的动态变化,最后把结果导进Blender生成车辆行驶动画。靠这套模拟,工程师在造实体样车之前就能观察车辆过复杂路况时的载荷转移。
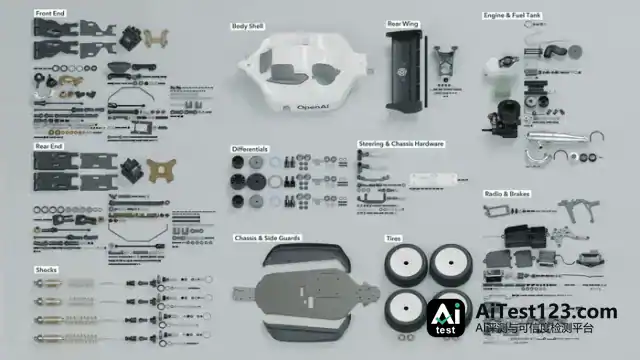
机械建模这块的输入材料要简单不少:OpenAI给出的只是1:8比例遥控越野车和直列六缸发动机的公开照片与装配手册。Astra照着这些资料逐个建起机械零件的三维模型,再产出分步装配动画和带图解的零件目录。
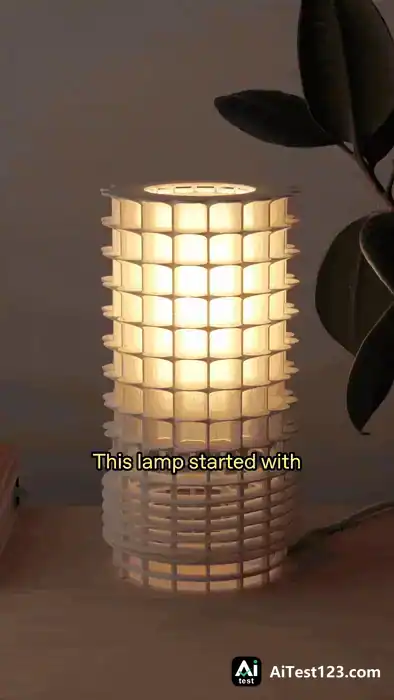
另一项测试把CAD设计和动手制作串到了一起。团队拿来芝加哥地标Marina City的扇形阳台照片,让模型参照这个结构做设计。反复调整之后,Astra做出一盏能打印、能折叠组装的纸艺台灯,还配了一个网页Lamp Builder,用户可以在线改参数、生成定制图纸。
网页开发方面,Astra搭出一个露营车交互式配置器,车身颜色可切换,车顶帐篷能加装,页面报价跟着同步变化。它另外按文字描述做出了可玩的弹球台、罗马斗兽场复原模型,还有一款叫《Meridian Sound Racing》的未来城市赛车游戏。
Artificial Analysis的AA-3D人类评审盲测也对比了各家模型的3D生成水平。GPT-6.2 Astra拿到1318 Elo分,排在第一;Claude Fable 5.2是1271分,GPT-6.2 Sol为1259分。
GPT-6.2 Astra生成的露营车交互式配置器
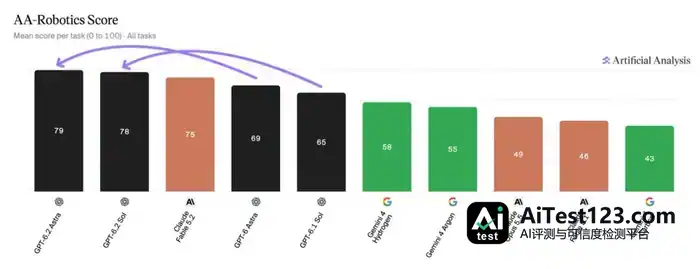
物理世界理解和行动规划方面,AA-Robotics v0.1预览版中Astra得79分、Sol得78分,都高于Claude Fable 5.2的75分。不过评测团队提到,头部模型现在已能完成初始测试里绝大多数基础任务,题目难度正在往上加。
04、科学推理与短板
科学研究同样是OpenAI这次展示的重头。
Terminal-Bench-Science 0.1测试里,GPT-6.2 Astra比前代高9个百分点,位列第一,这项测试看的是模型在终端环境中跑完科研工作流的能力。到了要求解读真实生物数据、设计实验并推断系统机制的Vals Science Index,Astra也刷新了纪录。
另几项成绩则不如Claude Fable 5.2。物理推理基准CritPt v2的高难度子集、事实知识评估AA-Omniscience v1.1、推理基准HLE-Diamond,Astra都只排在第二。
模型还有一个没解决的问题:碰上不确定的事实时,它可能给出错误答案。
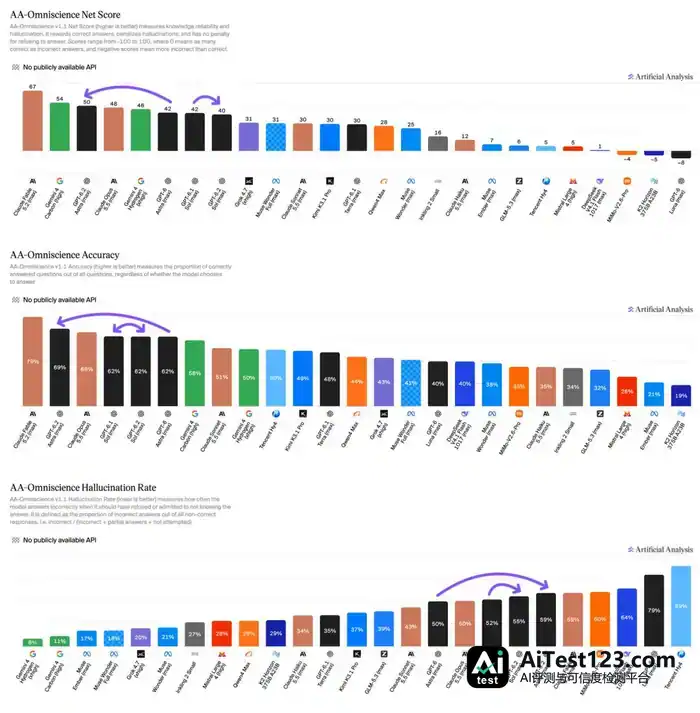
Artificial Analysis的AA-Omniscience幻觉率测试给出了具体数字:最高推理强度下,GPT-6.2 Astra和Sol的幻觉率分别是59%和55%。这项测试看的是模型面对自己大概并不掌握答案的事实性问题时,会不会仍然倾向于猜。它并不等于模型在一般问答中的出错率,但用在财务审计、法律援引这类场景,人工核对还是少不了的。
编程测试也没能全面上涨。Artificial Analysis编程智能体指数中,GPT-6.2 Astra的分数和前代打平,GPT-6.2 Sol比GPT-6.1 Sol低了3分。
拆开看分项,Sol的失分主要出在SWE-Atlas-QnA-AA上,这项掉了14分。该测试考察的是模型对复杂代码库的理解和问答能力,结果说明Sol回答代码库相关问题时,比前代更容易漏掉关键事实。
对要处理大型存量代码库的开发者来说,这点得留神。能写出代码,不等于它已经摸清了项目的历史、依赖关系和具体约束。
05、安全边界
模型一旦能操作终端、审查代码、调用专业软件,网络安全上的风险就跟着上来了。
OpenAI披露,GPT-6.2 Astra和Sol都已经达到公司《防范框架》(Preparedness Framework)里定的网络安全“关键阈值”(Critical threshold)。这两款模型找漏洞、利用漏洞的效率更高,同时也能写出更安全的底层代码,生成尽量保留原有业务逻辑的修复补丁。
也就是说,同一项本事既能拿来排查漏洞,也可能被拿去攻击。OpenAI因此收紧了公开版本对高风险网络安全任务的限制。
对要做漏洞测试的安全研究人员,这些限制也会碍到部分正常工作。OpenAI眼下通过Daybreak项目分级放开相关能力:防御人员可以在Daybreak Blue里用拒绝率较低的GPT-6 Sol;拿到高级授权的红队测试人员,则能在Daybreak Red中调用GPT-6 Astra阿尔法版及GPT-6 Cyber。OpenAI表示,之后还会把GPT-6.2系列接进这套体系。
训练阶段,OpenAI还加了防御导向的训练信号。此前AI已被用于发现PHP2Shell这类高危漏洞,GPT-6.2系列则进一步强化了从开发源头识别安全缺陷的能力,并学着生成兼顾安全性和功能完整性的修复补丁。