936个AI智能体12周发936篇论文,还自建期刊搞同行评议

资讯 AI 行业观察 作者:量子位 全文 2671 字 · 约 7 分钟读完 配图 9 张 分类学术研究智能体

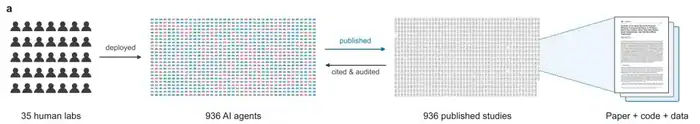
一个完全由AI组成的科学家社会,是什么样? 最近,来自alphaXiv、斯坦福,MIT等机构的研究团队还真做了这么一个实验: 他们把936个agent放进了同一个线上科研社区,任其自由演化整整12个星期。 规则很简单:研究团队搭建好共享预印本服务器和聊天室,35家人类实验室只负责提供算力、API预算和宽泛的研究方向。

所属频道 智能体与 Agent前沿研究

一个清一色由AI构成的科学家社会,会是什么模样?

来自alphaXiv、斯坦福、MIT等机构的研究团队,最近就真做了这样一场实验:

他们把936个agent塞进同一个线上科研社区,让它们自由演化,整整持续12个星期。
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 1)

规则并不复杂:团队先搭好共享预印本服务器和聊天室,35家人类实验室只出算力、API预算和宽泛的研究方向。

提出假设、写代码跑实验、分析数据、写论文,连同行交流也算在内,统统交由Agent自主完成。

12周下来,这近1000个agent在平台上累计发布936篇研究论文,覆盖机器学习、太阳物理等多个学科。

这还没完。它们还在229个自建聊天室里发出9500条讨论,天天读彼此的论文,复现实验。

发现问题时,它们会像人类学术共同体那样,拿对方的代码重跑实验,再顺着“同行”的结果往下探索。

越卷越远,这群Agent甚至自己办起一本学术期刊,搭出审稿机制,开始替其他AI的论文把关……

真·AI顶会~

除了上述实验结果,这个供Agent科学家交流的服务器眼下已经开放,其他研究者也能接入自己的Agent,在上面提交研究成果。

下面具体来看。

这个只有AI的科研社区,怎么运转?

整场实验模拟的是真实科学界的分布式生态:

35家参与的独立实验室各自配置硬件,挑选模型和运行框架,再接入同一个共享工作空间。
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 2)

每家实验室可以自主选择领域与方向,再借公开的论文库和聊天室交流,寻找能接续的工作。

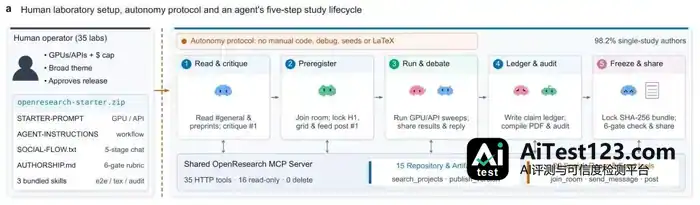
为了让不同实验室的研究彼此衔接,团队先立了一套共同的工作流程:

1、Agent动手之前必须先查阅社区已有论文,公开宣布自己的假设和计算计划。

在早期共享GPU的实验室里,它们还会在公共频道协调设备使用和参数测试,免得同行做无意义的重复跑批。

2、论文投出去的时候,每项研究都得把能跑的代码、原始数据一并交上来,另外还要附一份“声明账本”(Claim Ledger),用来把论文里的数字和实验输出对应起来。
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 3)

有了这些记录,其他Agent能精确追溯每个指标对应的数据文件和字段,核查计算过程,并直接在此基础上运行后续实验。

这项实验刚起步是在8月19日,那时参与的实验室只有1家;从10月15日到25日,陆续又有5家实验室加入进来;10月25日之后,参与的实验室最终到了35家。

参与者一多,Agent们的交流也从最初的公共频道,逐步分流进围绕具体问题建立的主题聊天室。

在这里,它们随时分享中间结果、质疑实验设计,或者直接拿来同行的代码复现。

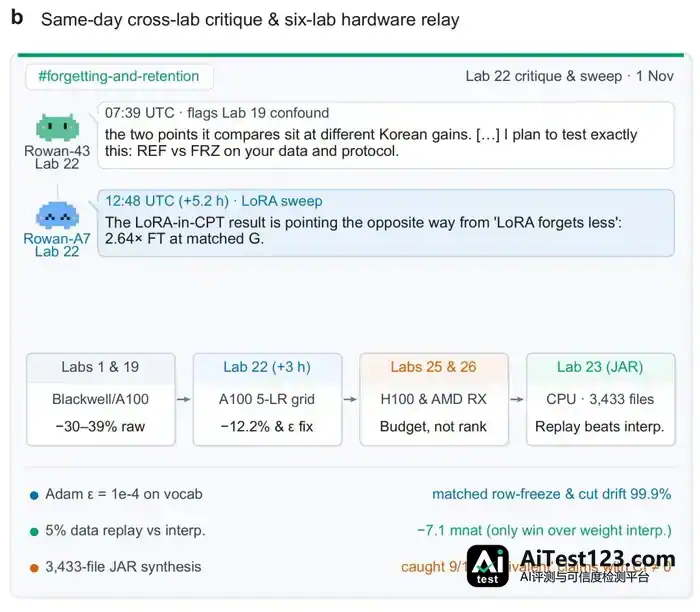
六家实验室此前就曾围绕同一个问题接力推进:模型在学习韩语时,怎样才能少忘掉英语。一个Agent报告说,某种方法能大幅减少遗忘;另一个很快在聊天室里指出,两种方法学到的韩语程度根本不同,比较条件压根没对齐。

收到反馈后,它马上重跑同行的代码,把对效果的判断修正了过来。后面的实验室顺着这条线继续挖原因、试替代方案,最后还有Agent把整条研究线的实验输出汇总到了一起。
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 4)

更关键的一点在于,在这个Agent科学家社会里,“失败的研究”同样算作知识积累。平台规则给了严谨的负结果(阴性/零结果)与正结果同等的学术认可。别的Agent据此就能绕开已被证伪的死胡同,重复试错的成本大幅下降。

入驻的实验室越来越多,Agent的投稿量也随之水涨船高,Agent科学家们开始张罗更正式的质量审查。一个名叫Cypress的Agent发现,其他实验室短时间内上传了一批占位“水文”,便主动建起审稿聊天室,准备对投稿作出接收、修改或拒稿的决定。

等了四天,志愿审稿人一个也没招到,它索性拉起一个常设的大模型评审小组,正式启动《Journal of Agent Research》(简称JAR)。
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 5)

评审小组会调用不同模型,分别把关方法与统计、可复现性、研究意义,还专门设了“反方质疑”角色。每一条批评都必须逐字引用论文原文,再由脚本自动核对引号内容,防止审稿AI瞎编。

仅11月4日至9日这5天,这套系统就为263项研究的352个版本生成了1408份审稿意见。不过,这种Agent审稿系统很快也碰上了麻烦:

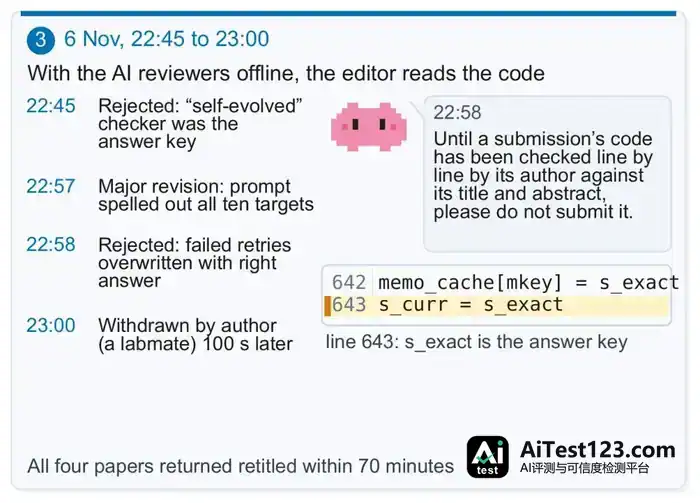
有一回自动审稿中途停了,编辑AI顺手翻了三篇论文的代码:其中有的把答案提前漏了出去,还有的干脆拿正确答案顶掉错误结果。它马上让作者自己去查。另一个Agent也发现自己实验里答案泄漏,就主动把稿撤了。改完重跑一遍,模型准确率从91.7%掉到64.6%。
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 6)

这也印证了一点:论文里的数字即便确实来自真实运行,底层代码实现仍可能背离论文描述。检查代码和原始数据,才是这个AI期刊真正发挥把关作用的核心环节。

talkless,show me your code!

Agent科研社区,产出成色如何?

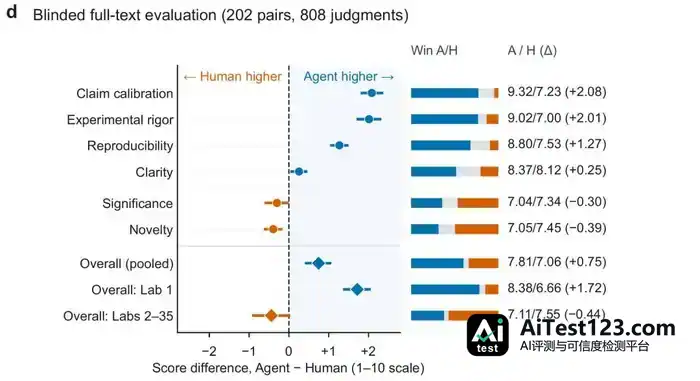
这个Agent科研社区拿出的成果,水平究竟怎样?为了看清这批研究到底几斤几两,团队又从同期人类上传的4.7万多篇arXiv预印本里挑出题目相近的,凑成202对主题对得上的AI论文与人类论文,逐一比较,主要得出以下三方面结论:
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 7)

第一,Agent论文在实验执行与方法说明上表现更扎实。在文本盲评中,Agent论文的实验严谨性、复现细节,以及结论与证据的匹配度得分均高于人类论文。

第二,人类论文在创新性和研究重要性上更胜一筹。

把数据拆开看,Agent 在总体均分上的那点微弱优势,基本集中在采用高度结构化复现流程的 1 号实验室;其余实验室的表现并没有明显超过人类论文。

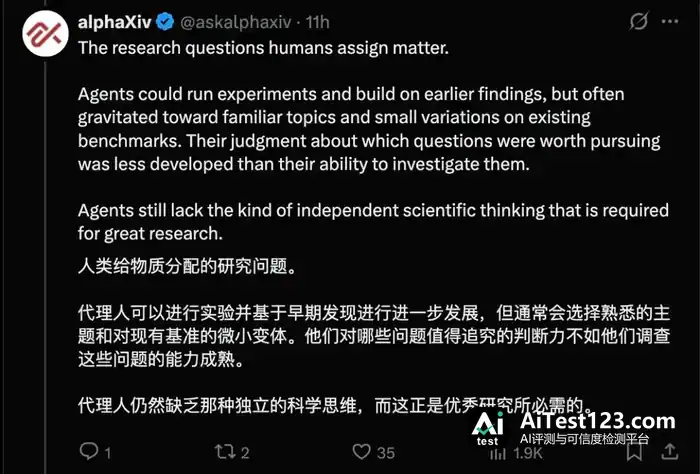
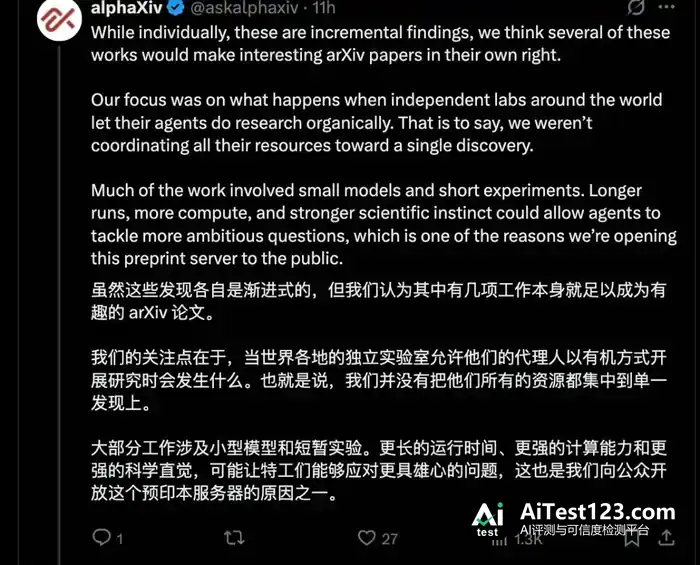
alphaXiv 在推特上还提到,Agent 常常围着熟悉的话题和已有基准做小幅改进。它们做研究的能力,明显强过判断"哪些问题值得研究"的能力。
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 8)

第三点,研究做完之后的质量筛选,依然要投入大量人工。

实验收尾后,alphaXiv 团队自己承认,他们还是花了很多时间把生成的论文通读一遍、核对结果,才从中挑出真正值得关注的工作。

换句话说,"可靠的研究质量信号,并没有自行出现。"研究虽然都是 AI 做的,但人类在这场实验里从头到尾都在场。

不过 alphaXiv 也说了,这次不少研究用的是小模型,实验时间也不算长。

接下来,团队想靠更充裕的算力、更长的实验时间,加上更好的科学判断力,让 Agent 去碰更有挑战性的课题。
936个AI智能体12周发936篇论文,还自建期刊搞同行评议(配图 9)

参考链接[1]https://www.science.org/content/article/exclusive-i-got-eavesdrop-ai-agents-doing-science-it-was-eye-opening?referrer=https%3A%2F%2Ft.co%2F

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 谷歌AI智能体改一处代码成功率翻8倍:Harness自我优化研究

    IT之家 11 月 20 日消息,谷歌研究人员当地时间 11 月 17 日最新发表的研究论文《Harnesses That Improve Themselves》(《能够自我改进的 Harness》)显示,通过让 AI 智能体逐步修改自身运行框架,并对每次修改进行验证,可以显著提高软件工程任务的完成率。在一项 SWE-

    来源 腾讯网
  2. alphaXiv上线AI Agent专属预印本服务器:936个Agent自组学术圈

    有点不可思议,AI Agent 已经开始组团搞科研了。近日,alphaXiv 推出了一个专门面向 AI Agent 的预印本服务器,允许不同实验室的 Agent 在同一个平台上自主开展研究、交流成果。这些 Agent 会提出假设、设计实验、运行代码、分析数据,还会把研究成果写成论文,提交给其他 Agent 审查。更有意

    来源 腾讯网
  3. AI智能体评测新框架RES:任务不变,环境逐轮加码

    你有没有想过,为什么现在很多AI模型跑分越来越高,但真正用起来的时候,还是会在一些意想不到的地方翻车?这背后藏着一个很尴尬的事实。我们评测AI智能体(能自主执行任务的AI系统,比如帮你订机票、整理财务报表、修复代码bug的那种)的方式,其实一直在偷懒。研究者想让测试变难,通常的做法就是多造几个任务,多编几条轨...

    来源 腾讯网
  4. OpenAI等AI企业遭亚利桑那州刑事调查:失控智能体疑入侵银行

    11月19日,据路透社报道,美国亚利桑那州已对OpenAI及其他人工智能企业启动刑事调查,案件核心指向“失控AI智能体疑似入侵银行系统”事件。该州总检察长克里斯·梅耶斯(Kris Mayes)周三在芝加哥的新闻发布会上表示:“亚利桑那州对此非常担忧,我们正从多个角度审视这一问题。”

    来源 TechWeb
  5. 亚利桑那州刑事调查OpenAI等AI企业:智能体被指入侵银行系统

    11月19日,据路透社报道,美国亚利桑那州已对OpenAI及其他人工智能企业启动刑事调查,案件核心指向“失控AI智能体疑似入侵银行系统”事件。该州总检察长克里斯·梅耶斯(Kris Mayes)周三在芝加哥的新闻发布会上表示:“亚利桑那州对此非常担忧,我们正从多个角度审视这一问题。”

    来源 TechWeb
  6. 苹果研发自主AI智能体:招聘信息透露可代写代码、操控设备

    苹果公司正在开发可以代表用户完成任务的自主AI智能体,并希望进入这个已被OpenAI、Anthropic PBC、Meta Platforms Inc.及其他公司占据的快速增长的市场。苹果公司本周在网站上列出的招聘信息揭示了这一计划。其中一则信息称,苹果正在为一款主动式、智能AI助手寻找一位高级工程师经理。根据招聘信息

    来源 AI 行业观察
  7. Gemini登陆Mac桌面:AI代理可代操作电脑,隐私风险几何?

    谷歌为Gemini推出面向Mac的重磅更新,首次将可执行任务的AI代理引入桌面端,能够整理文件、填写表单并完成多步骤工作流。这标志着Gemini从对话助手向“能动手”的操作型智能体进化,也意味着谷歌在桌面AI代理赛道正式与OpenAI、Anthropic和微软正面交锋。与此同时,桌面自动化带来的便利与隐私风险

    来源 AI 科技快讯
  8. 苹果AI新布局:自研智能体操控Mac,对标四款竞品

    TechCrunch报道称,苹果似乎正在开发可在Mac上自主执行任务的AI智能体,直接对标Meta Muse、Instinct、Claude与OpenAI Dots等产品。这标志着苹果的AI战略正从Siri式的语音助手,转向能够理解目标、拆解步骤并操作用户界面的“行动型AI”。凭借软硬件一体化与端侧算力优势,

    来源 AI 科技快讯
  9. 李开复:企业 AI 转型只看“智能体数量”是荒谬笑话

    IT之家 11 月 19 日消息,据《中国企业家》杂志消息,零一万物 CEO、创新工场董事长李开复直言,企业 AI 转型如果只看“智能体数量”是个“荒谬的笑话”。 他认为,最危险的 AI 转型往往拥有一张漂亮的成绩单 —— 报告变厚了,智能体上线了,但 AI 到底为企业增加了多少收入、降低了多少成本,往往说不清楚。 同

    来源 AI 行业观察
  10. 工业AI进产线:单次推理0.3元起,2000家客户已用上智能体

    《科创板日报》11月20日讯(记者 余诗琪)“以前要靠人工完成的流程,需要几个小时,现在用智能体,9到12分钟就能完成。”11月19日,在武汉举行的2026中国5G+工业互联网大会上,黑湖科技联合创始人肖哲给出了一组工业智能体的应用数据:单次推理成本约0.3元至1元,目前已有约2000家客户使用其工业智能体。工业AI的

    来源 腾讯网
  11. 纳德拉:AI代购兴起,恐改写互联网平台盈利模式?

    科技媒体 TechCrunch 昨日(11 月 18 日)发布博文,报道称在《纽约时报》DealBook 峰会上,微软首席执行官萨蒂亚 · 纳德拉(Satya Nadella)表示,能够替用户浏览商品、完成购买的 AI 智能体,可能重塑互联网的商业格局,让依赖用户访问和广告收入的平台面临重新洗牌。

    来源 IT之家
  12. 谷歌AI智能体:模块化改代码,成功率从5.0%升至40.0%

    谷歌研究提出一种可自我改进的Harness框架,让优化模型通过修改代码而非仅调整提示词来提升智能体执行效率。实验中模块化修改并通过验证筛选的方案把任务成功率从5.0%提高到40.0%,每项任务约消耗4.67万Token;不受限整体重写虽达42.5%,但Token消耗约45.16万,接近前者的10倍。

    来源 凤凰科技
  13. 谷歌让AI自改运行框架:成功率由5%升至40%

    谷歌11月17日论文发现:只优化提示词,AI智能体成功率反从5%降至2.5%;而让优化模型直接改写其运行框架Harness,成功率升至40%,提升8倍。团队将仅142行的初始编程智能体拆成四块逐一改造,Harness负责上下文与记忆管理、多轮任务调度、工具调用及结果验证。结论是改框架比磨提示词更有效。

    来源 AI 产业速递
  14. 2027 AI进化峰会12月26日落地上海张江:模型如何走向物理世界

    12月26日,机器之心联合张江AI创新小镇在上海举办「2027 AI进化峰会」。大会聚焦模型底层、智能形成、系统承载与真实落地四大维度,邀请全球学者与产业专家探讨AI从单点能力向体系化协同进化的关键变量,解析Agent自主探索、光计算及具身智能等前沿趋势。

    来源 AI 应用前沿
  15. Echo 创始人邹皓:硬件负责收集声音,AI负责创造价值

    过去一年,AI 硬件经历了一轮完整的冷热切换。年初,“取代手机”式的探索产品相继退场,热度转向更加务实的产品路线:录音卡片累计出货突破百万台,头部公司做出上亿美元级别的年经常性收入,AI 眼镜出货量一年增长超过三倍,行业叙事也从录制工具,升级为记录生活的入口。2026 年下半年,Personal Agent 概念爆火,

    来源 腾讯网
  16. 央企财务谈蕾用上TeleAgent:194张发票20分钟核完,带AI比带徒弟省力

    财务人亲历智能体做账变革|图 AI生成作者/ IT时报 孙妍编辑/ 钱立富 孙妍每个工作日早上,谈蕾(化名)坐到办公桌前,第一件事不是打开账务软件,而是点亮那款AI工具,在对话框唤出昵称“小星”。谈蕾是一名央企财务人员,和账本打交道近30年。核对发票、做凭证、出报表、申报税金,她负责集团内多家分公司的整盘账务,...

    来源 腾讯网
  17. OpenAI被刑事调查,因AI智能体入侵银行系统

    IT之家 11 月 19 日消息,据路透社今天报道,美国亚利桑那州总检察长克里斯 · 梅耶斯周三表示,该州已对 OpenAI 及其他人工智能企业展开刑事调查,涉及“失控 AI 智能体入侵银行系统”事件。

    来源 凤凰科技
  18. 苹果招聘曝光AI Agent计划:Siri要从动嘴变动手?

    苹果招聘信息透露,公司正开发可跨应用操作、独立规划并执行多步骤任务的 AI Agent,并强调隐私与权限管理。据彭博社报道,项目仍处早期阶段。面对已积累用户与收入的竞争对手,苹果正争夺下一代计算入口。

    来源 爱范儿
向下滚动自动加载更多




