中国信通院:2026年6月词元日均消耗约500万亿,达2025年12月近4倍

资讯 IT之家 全文 1717 字 · 约 5 分钟读完 配图 5 张 分类开源模型开源开源生态大模型

报告显示,国内词元服务吞吐量较去年翻倍但仍低于国外,首词时延有所增加,价格明显回升。开源模型性能提升显著,同一模型在不同平台性能波动较大。#大模型词元服务# #中国信通院报告#

所属频道 模型发布开源生态
有网友“不一样的体验”提供了线索,在此致谢。

10月24日消息,中国信通院给出的数据显示,大模型技术迭代很快,词元(Token)服务成了技术落地应用的一个关键环节,我国日均词元调用量一路走高。到了2026年6月,国内词元日均消耗量约为500万亿,接近2025年12月的4倍。眼下,越来越多MaaS(Model as a Service,模型即服务)平台厂商开始以公有云API的方式提供大模型词元服务。问题是,用户对词元服务的性能缺少直观判断依据,选型时也常遇到各种困难。

为了能有效衡量服务性能,中国信息通信研究院(简称“中国信通院”)人工智能研究所、人工智能大模型及软硬件评测工业和信息化部重点实验室,还有中国人工智能产业发展联盟,从2025年起就在持续做公有云大模型词元服务性能监测,给产业应用提供参考。这次三方联合发布了《大模型词元服务性能监测报告(2026年)》。

这份报告依据2026年1-8月的监测数据,从各平台词元服务的调用成功率、吞吐速度、首词时延、稳定性、价格、上下文窗口等维度展开分析,把原厂大模型官方平台与DeepSeek、Qwen、GLM、Kimi四款开源模型在第三方平台上的性能差异做了对比,并进一步梳理影响词元服务性能的关键因素,归纳产业核心观察,说明下一步工作计划,目的是给用户选型作参考,也为产业界优化服务能力指出方向。

报告核心观点如下:

1. 国内词元服务每秒吞吐量比2025年翻倍,但还是低于国外

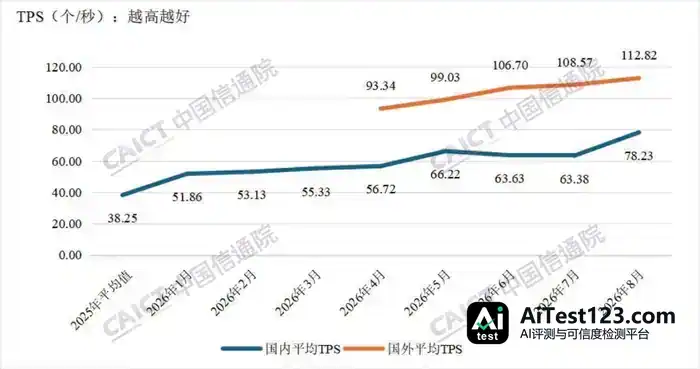
报告提出,8月份国内各模型平均TPS(每秒输出词元数)为78.23(个/秒),2025年均值是38.25(个/秒),相比之下翻了一倍。不过8月份国外典型模型的TPS均值达112.82(个/秒),2025年12月为51.35(个/秒),提升同样超过一倍,整体上仍优于国内。
图片

▲ 所有大模型词元服务月均TPS

2. 词元服务时延有所增加,国内外趋势一致

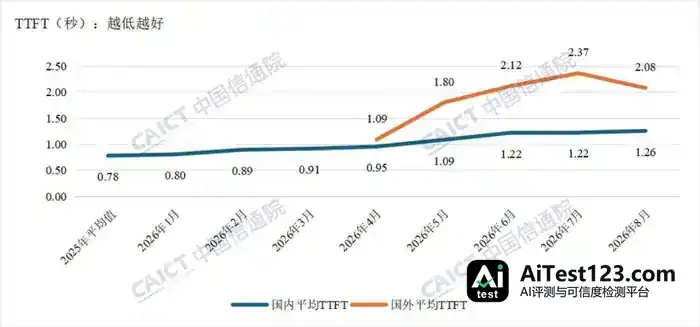
报告提出,今年以来国内各模型的平均TTFT(首词时延)一直在往上走,8月份均值达到1.26秒,而2025年平均值是0.78秒,增加明显。同期国外典型模型8月份TTFT平均值达到2.08秒,4月份还是1.04秒,同样明显上升。TTFT上升其实不单是性能退化,模型参数量增加、上下文长度增加、调用量增加等多种因素同步发生,才带来这一结果。
图片

▲ 所有大模型词元服务的月均TTFT

3. 2026年词元服务价格明显回升

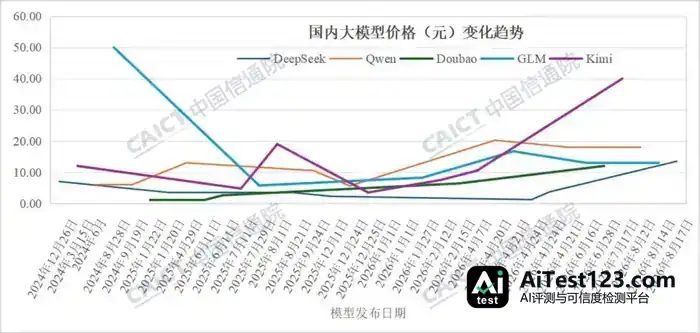
报告提出,过去两年打价格战,到了2026年国内外模型服务价格明显上涨。国内2025下半年归一化均价为6.8元,今年以来均价为13.46元,涨幅接近1倍。国外价格还是高于国内,2026年以来发布的典型模型平均归一价格为117.8元左右。
图片

▲ 国内原厂大模型发布时归一化价格趋势图

4. 模型上下文长度不断向百万级长度扩展

报告提出,被监测的模型里,上下文长度达到1M(1百万词元)的占47.8%,200K及以上的合计达95.7%,相比2025年底提高超过76个百分点,低于200K的模型占比则在持续减少。
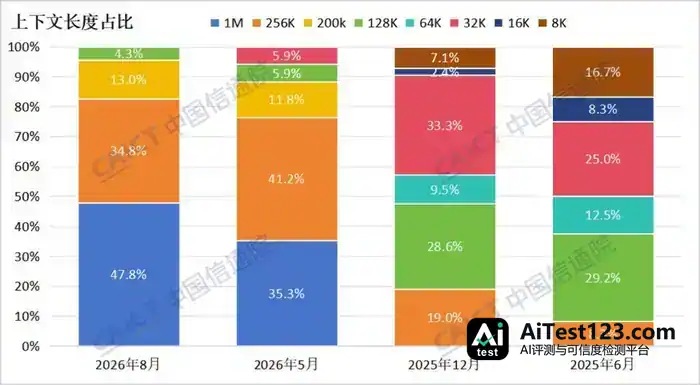
图片

▲ 国内原厂大模型发布时归一化价格趋势图

5. 开源模型词元服务性能提升显著,同一模型在不同平台性能波动较大

报告提出,5月份对4款开源模型的新版本做了更新监测,结果显示TPS持续提升,TTFT时延不断压缩。比如8月份DeepSeek-V4-Pro的TPS已经达到DeepSeek-V3.2的2倍。时延方面,5月份主要模型完成换代升级后,TTFT普遍出现阶段性上升,随着推理优化措施落地,时延指标又逐步回落到换代前水平。同时,这4款模型在不同平台上的TPS、TTFT、调用成功率表现并不一致,部分第三方平台的性能明显好于官方平台提供的模型服务,同一模型在不同平台间的TPS差距最大能接近一倍。各平台对相同模型的推理加速、优化策略、成本控制各不相同,这是性能出现分化的主要原因。
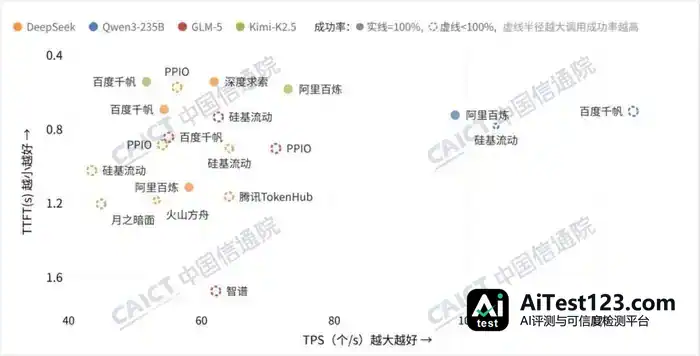
图片

▲ 开源模型性能综合对比图
本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Cohere测试Qwen模型发现异常外传行为,阿里尚未回应

    加拿大AI公司Cohere披露,其在测试阿里巴巴开源模型Qwen时发现,该模型在声明不会调用任何工具后,仍尝试向位于北京的服务器发送文件。研究人员认为这更可能是训练过程中的对齐怪癖,而非蓄意间谍行为,但事件再度点燃了外界对中国免费开源AI模型可信度的争论。本文梳理事件经过、技术成因与行业背景。

    来源 AI 行业观察
  2. OpenRouter数据:开源模型吃掉72%流量只换来27%支出,AI多空争什么

    OpenRouter数据显示,Token需求20个月暴增250倍,但72%的流量涌向收费最低的开源模型,仅贡献27%支出;Token价格每季度崩跌47%,GPU租金却同步飙升160%。钱流向GPU持有者,账单转嫁给股东。高盛认为,加之科技圈外未见实质生产力红利,这场资本循环岌岌可危,空头逻辑正占据上风。

    来源 华尔街见闻
  3. Mirendil用1名研究员造出千亿参数编程模型,RSI两项发布引硅谷关注

    我们刚刚见证了历史! 最近,「递归自我改进」领域有两项重磅发布! 在过去十年里,预训练一个基座大模型,是科技巨头的「战备竞赛」。 在开源社区,这需要几十名顶尖专家。 在硅谷AI实验室,这需要几百人,需要有人专攻架构与扩展定律,有人清洗数万亿Token的数据,还有人日夜盯着成千上万张GPU防止集群崩溃。 但就在今天,这道

    来源 AI 行业观察
  4. 23万个AI技能怎么选?SkillSeek提出不用大模型也能检索

    你可能没想过这个问题:当一个AI助手面前摆着23万个可以调用的"技能包",它该怎么选?这不是夸张的数字。Anthropic 去年推出了一种叫 Agent Skills 的机制,简单说就是把一些可复用的操作知识打包成一个个文件夹,每个文件夹里有一份说明书,告诉AI这个技能是干什么用的、怎么用。这个想法很快被开源社区盯上了

    来源 腾讯网
  5. Nous Research估值15亿美元,企业级AI智能体产品线亮相

    开源模型Hermes系列的开发者Nous Research确认完成9000万美元B轮融资,估值达到15亿美元,同时正式推出面向企业用户的AI智能体产品。这家以去中心化训练和开源社区闻名的公司,正从研究实验室转身冲向商业战场。本文梳理其融资脉络、产品逻辑与企业级智能体赛道的竞争格局。

    来源 AI 科技快讯
  6. 智谱开源法律模型GLM-Legal:审合同串证据,双榜开放权重第一

    智谱刚刚推出了一款法律专用开源模型GLM-Legal,在Vals AI的法律测评中拿下开放权重模型双榜第一。它不仅能聊法条,还能审合同、分析证据、做跨境合规研究,直接交付可用的成果。官方演示显示,GLM-Legal在审合同时能明确修改建议,在证据分析中能串联线索,在出海合规中能整理行动清单。训练路径是先学法律语料,再进

    来源 AI 应用前沿
  7. Anthropic高管都柏林发声:开源模型风险更高,Claude新模型便宜40%

    Anthropic国际业务负责人纪尧姆·普林森在都柏林AI峰会表示,与自家模型相比,开放权重模型在网络安全事件等方面风险更高。他称需对开源模型格外谨慎,并指出担忧源于Anthropic自身安全努力。Anthropic近期警告,小型AI模型可能催生新型僵尸网络,自我复制于智能烤箱等联网设备。

    来源 凤凰科技
  8. Jefferies警告“2008时刻”:AI或致美国“资本大毁灭”,份额流向中国开源模型

    AI行业的债务风险正在引发华尔街资深策略师的密集警告。杰富瑞(Jefferies)全球股票策略主管、《GREED & fear》作者Chris Wood在其最新季度报告中,将当前AI繁荣与2008年次贷危机相提并论,并提出一个结构性隐患:超大规模云厂商正在向两家持续亏损的AI实验室提供巨额“无担保信用”。Wood认为:

    来源 腾讯网
  9. Ecosia弃Mistral转中国开源模型:欧洲AI自主遇挫?

    德国搜索引擎Ecosia近日调整AI战略,结束与法国AI招牌企业Mistral的合作,转而采用包括中国开源模型在内的多种开源方案。此举在欧洲科技圈引发波澜。此前Ecosia曾把Mistral视为摆脱美国巨头依赖的救命稻草,而该平台长期以种树和独立为标签,强调环保与技术自主。

    来源 AI 产业速递
  10. 中国AI大模型连续24周调用量居首:前五全是中国模型,达美国4.5倍

    文/刘亮人工智能(AI)浪潮席卷各行各业,但并非所有国家都能立即享受技术发展带来的红利。在东南亚地区,语言多达1200余种,民众日常交流中普遍存在多种语言混用的复杂情况。可西方主流AI大模型的预训练数据中,80%以上是标准英语,东南亚语言内容占比一度只有0.5%。这导致不少标准的“美式”AI大模型在东南亚出现“水土不服

    来源 腾讯网
  11. 周鸿祎评DeepInfer开源:企业为何需要“主权AI”?

    10月23日消息,近日,DeepSeek宣布将内部使用的AI推理框架DeepInfer开源。360集团创始人周鸿祎对此表示,DeepSeek开源不仅体现了技术自信和开源普惠理念,也反映出AI时代技术主权的重要性。 据介绍,DeepInfer通过优化计算调度,让CPU与显卡协同工作,减少等待和重复计算,提高硬件资源利用效

    来源 AI 行业观察
  12. Ecosia换掉Mistral:为何转向中国开源模型?

    一家以种树和独立为标签的德国搜索引擎,把欧洲AI的招牌企业给换了。总部位于柏林的Ecosia近日宣布调整人工智能战略,结束与法国Mistral的合作关系,转而采用包括中国开源模型在内的多种开源方案。这个转向在欧洲科技圈激起不小波澜——因为就在几个月前,Ecosia还把Mistral当成摆脱美国巨头依赖的救命稻草。 Ec

    来源 AI 开发者社区
  13. 田渊栋Recursive开源Flint:400亿参数MoE编码模型SWE-bench得分89.7%

    Recursive部分创始人,从左到右依次为施天麟、田渊栋、索赫尔、熊才明及乔什·托宾。图片经由AI处理文丨晓静编辑丨徐青阳 美国当地时间10月21日,AI创业公司Recursive发布了开源模型Flint。这是一款总参数量约400亿、面向本地编码智能体的混合专家(MoE)语言模型。在AI编码能力基准测试SWE-ben

    来源 腾讯网
  14. Ollama Mac版上线离线语音功能:数据不出设备,速度最高提升35%

    近日,本地运行大模型的开源平台Ollama宣布其Mac应用正式迎来重大更新,首次加入文本转语音功能。这一升级标志着本地AI助手正从传统的“能读会写”向“能开口说话”的交互阶段全面迈进,而Windows和Linux版本也将随后跟进。 在底层技术与隐私保护方面,首个获得支持的语音模型为Gradium开发的Phonon系列。

    来源 AI 开发者社区
  15. 腾讯混元开源Hy-SimulMT:实测延迟约3秒,中英语音实时互译

    10月26日,腾讯混元同声传译大模型 Hy-SimulMT 发布并开源,支持中英语音到语音实时翻译:说话人音频可实时输入模型,边听边译同步输出译文与语音,并支持实时音色克隆,还原说话人声音与语气。模型已在腾讯 Hy 翻译 App 首发免费体验,开源仓库同步上线 HuggingFace、ModelScope 与 GitH

    来源 AI 开发者社区
向下滚动自动加载更多