谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”

资讯 36氪 全文 4035 字 · 约 11 分钟读完 配图 21 张 分类Google模型发布世界模型

谷歌发布Genie 4,新一代高逼真互动世界模型

所属频道 大厂动态模型发布

谷歌描绘的“黑客帝国”式场景,这次真的落地了。

Google DeepMind在深夜抛出重磅产品:新一代通用世界模型Genie 4正式登场。
按谷歌的说法,这是其迄今最逼真、互动性最强的AI世界模型。

谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 1)

只给一句提示词,就能生成一个能开口接台词、还能实时改写走向的“活体宇宙”。

谷歌CEO劈柴第一时间表态:从“生成一段视频”跨到“实时运行一个世界”,言出法随的“绿洲”时代已经到来。

谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 2)

Genie 4把世界模型推进到“有声、有人、有大脑”的新阶段,几个要点值得划出来:

声音与即兴对话在Genie系列中首次原生生成。环境音和配乐同步产出,角色还能针对突发状况张口即兴交谈。

连贯长记忆达到2分钟,交互帧率24帧。单次连贯世界维持时间翻倍到约2分钟,实机画面稳定在约24帧/秒。

逼真人类与刚体物理被重新塑造。Gemini Omni负责锚定现实常识,人物微表情、镜面反射和物理碰撞都有明显提升。

三个Gemini模型联手搭起“混合世界模型”。Gemini 3.8 Flash在后台盯着画面充当“导演”,Gemini 4 Argon则拆解22步精细动作,指挥机器人下跳棋。

你往前走一步,世界就实时长出一寸;你改一句话,物理法则和NPC台词当场跟着重写。

视频模型还在比拼几秒钟镜头的美感时,谷歌已经把目光投向未来通用Agent与机器人——为它们造出一个可以无限试错的平行宇宙。

目前Genie 4已进入内测,Google AI Ultra用户可以去申请waiting list。

只要一句话,为你当场“生成一个宇宙”

为展示Genie 4的统治力,谷歌放出了一系列极具震撼力的Demo,风格跨度之大、细节之细,让人叹为观止。

在Genie 4面前,你不再是观众,而是“第一人称游戏玩家”,是这个世界的“上帝”。

下面这段王家卫风满满的香港大桥飙车戏,你敢信根本不是原片?

后座的女孩刚喊出台词,玩家敲进两行字:“背景发生爆炸”“毁灭世界的巨型外星触手”。

紧接着,远处的维港天际线立马火光冲天,外星触手直接从天砸落!

谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 3)

连路灯的橘色拖影、女主的皮肤质感和细微的担忧表情,都在长镜头中被完美渲染。

去年的Genie 3虽然开创了实时交互视频的先河,但有一个致命短板——没有声音,生成真人时也漏洞百出。

谷歌直接放出了一段Genie 3与Genie 4的同屏对比。
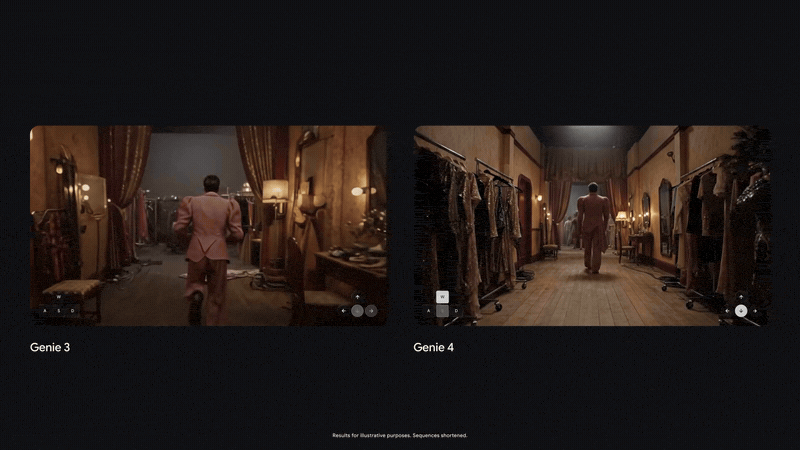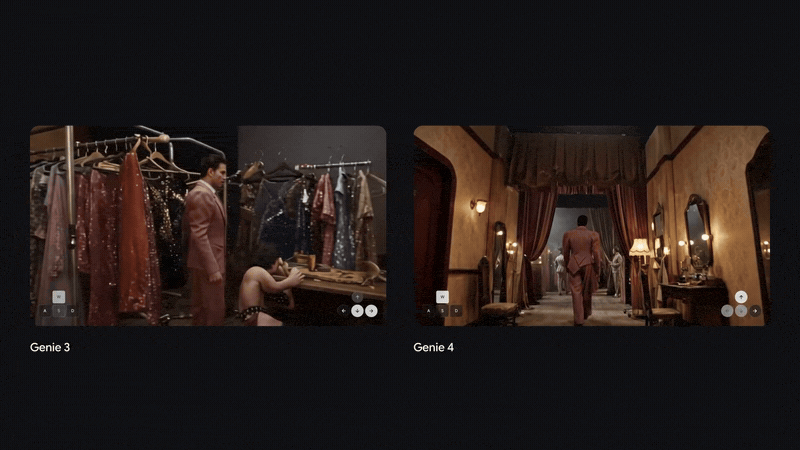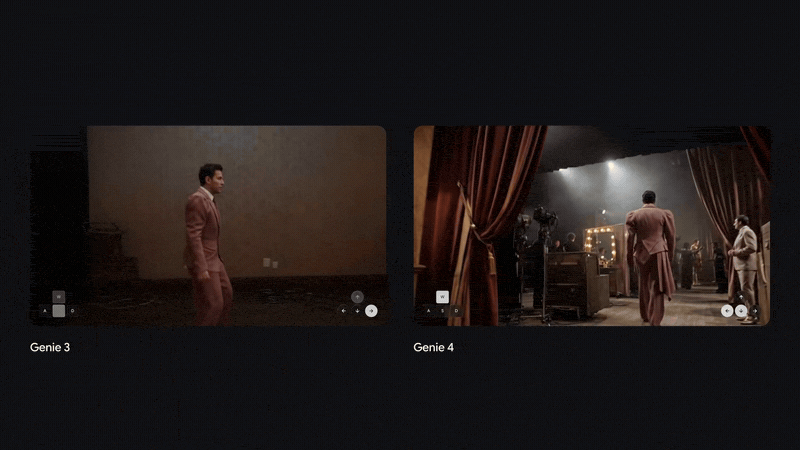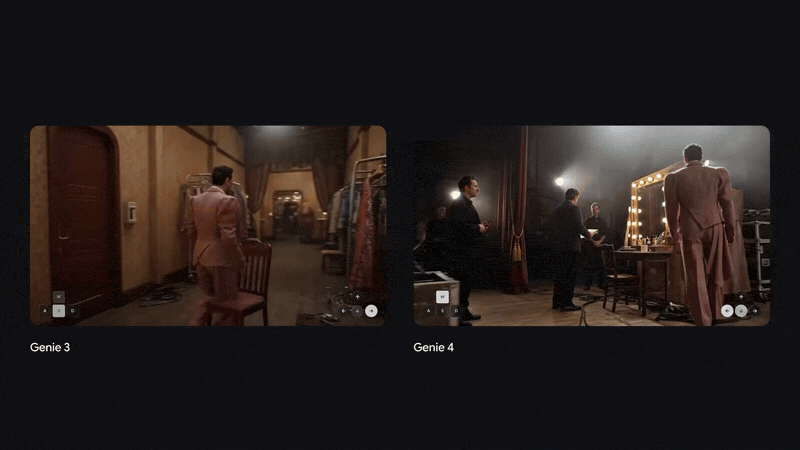
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 4)

Genie 3 那边,人物五官糊在一起、四肢发僵,嘴里也没声音;Genie 4 这边靠 Gemini Omni 用现实常识做锚,化妆镜前的暖光、演员脸上的细微表情都能拍出来,镜面里的实时倒影同样有了,细到像实拍的长镜头。

拿到抢先测试资格的沃顿商学院教授Ethan Mollick,晒出第一手实测录屏。
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 5)

他输入的提示只有一句「由马和机器人共同居住的新哥特式粗野主义城市」,不到1分钟,这座城市就成型了。

单帧延迟稳定在23.4至25.3 FPS。他随手按下「巨龙掠空」按钮,几秒之内,一头巨龙扇动双翼呼啸着掠过画面。
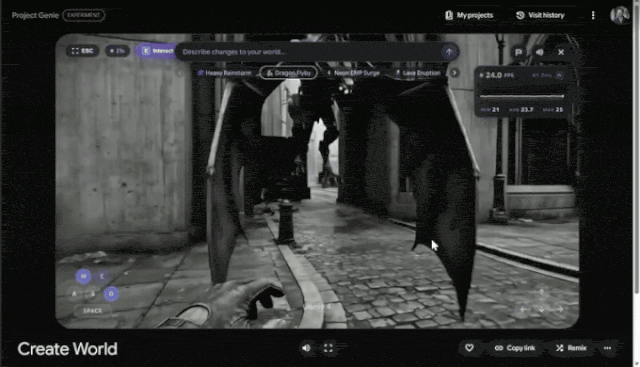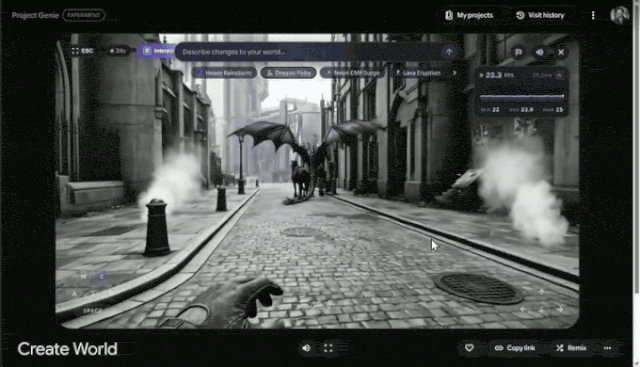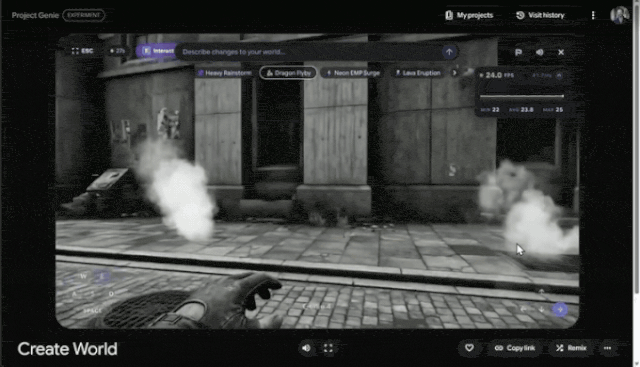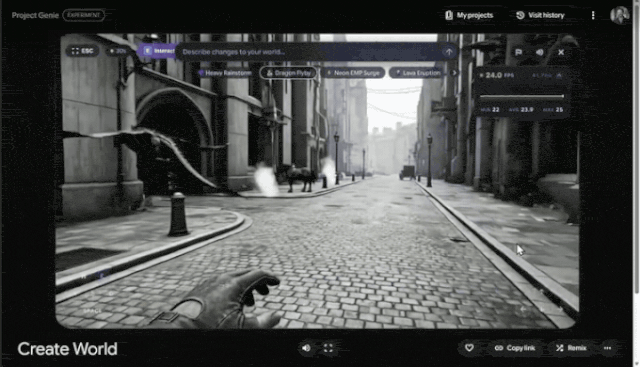
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 6)

觉得不过瘾,他又敲入「一只友好的水獭NPC走过来问问题」。街角随即真的跑出一只穿马甲的水獭,用伦敦腔开口:「打扰一下,旅行者。」

随后他晒出的另一段实测更为夸张:在Genie 4里直接跑《毁灭战士(DOOM)》。
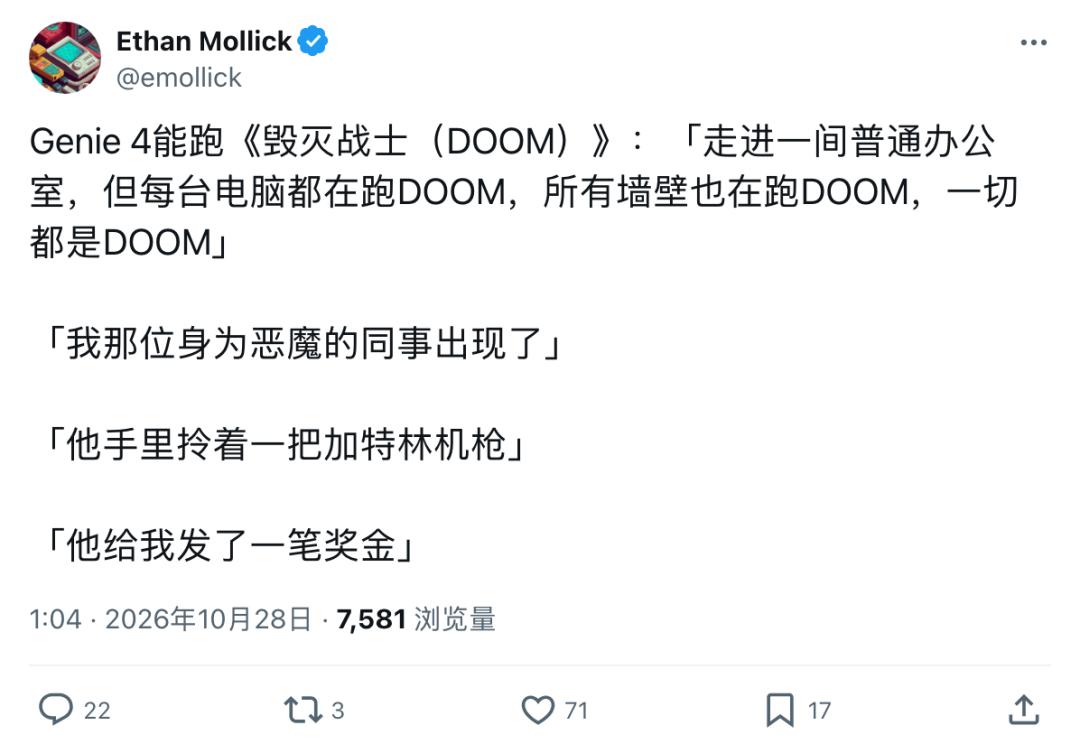
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 7)

他先设定场景为「走进一间每台电脑和墙壁都在跑DOOM的办公室」,再连发三道指令:「恶魔同事出现」「手里拎着加特林机枪」「给我发了一笔奖金」。

指令刚落,一位恶魔同事真的走了出来,双手转着重型加特林,当场把奖金发了出来。

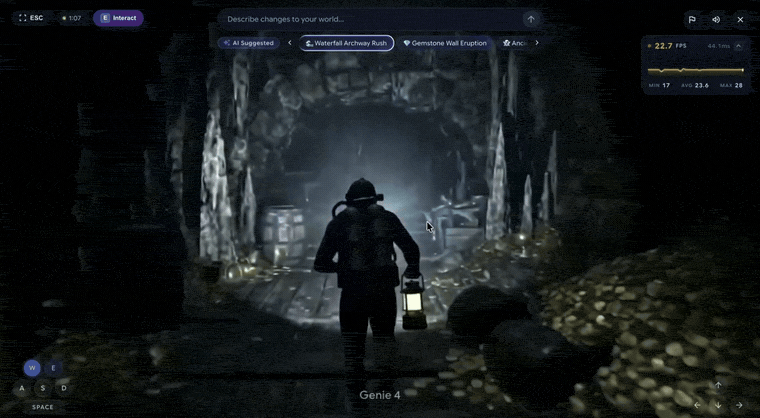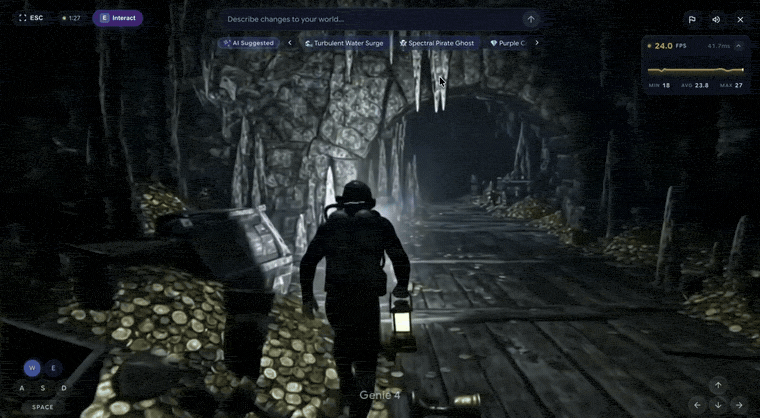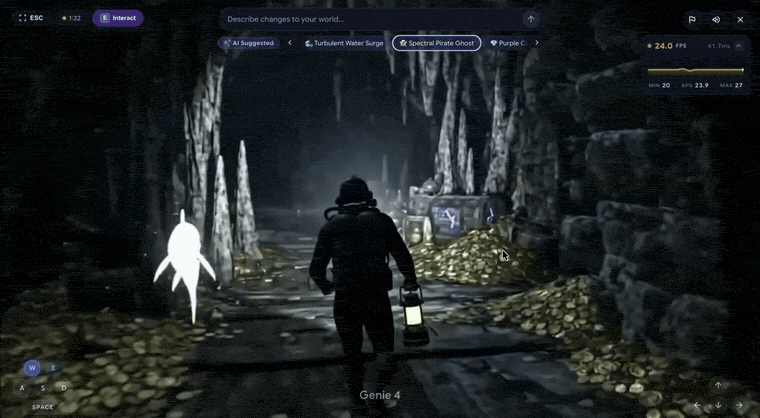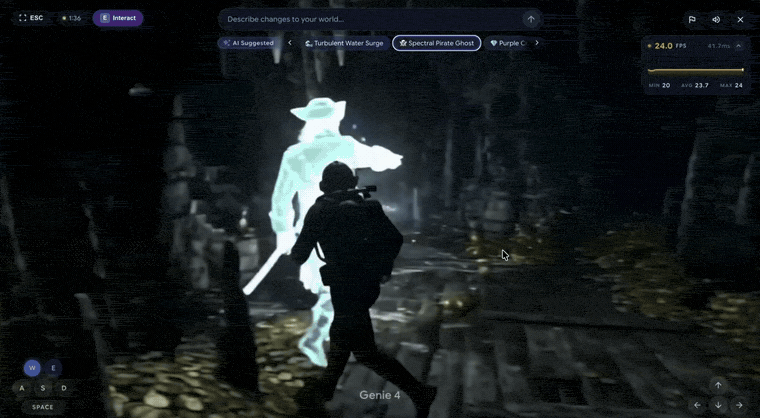
a16z 合伙人Justine Moore也放出了水下潜行实测,她表示这是巨大的飞跃。
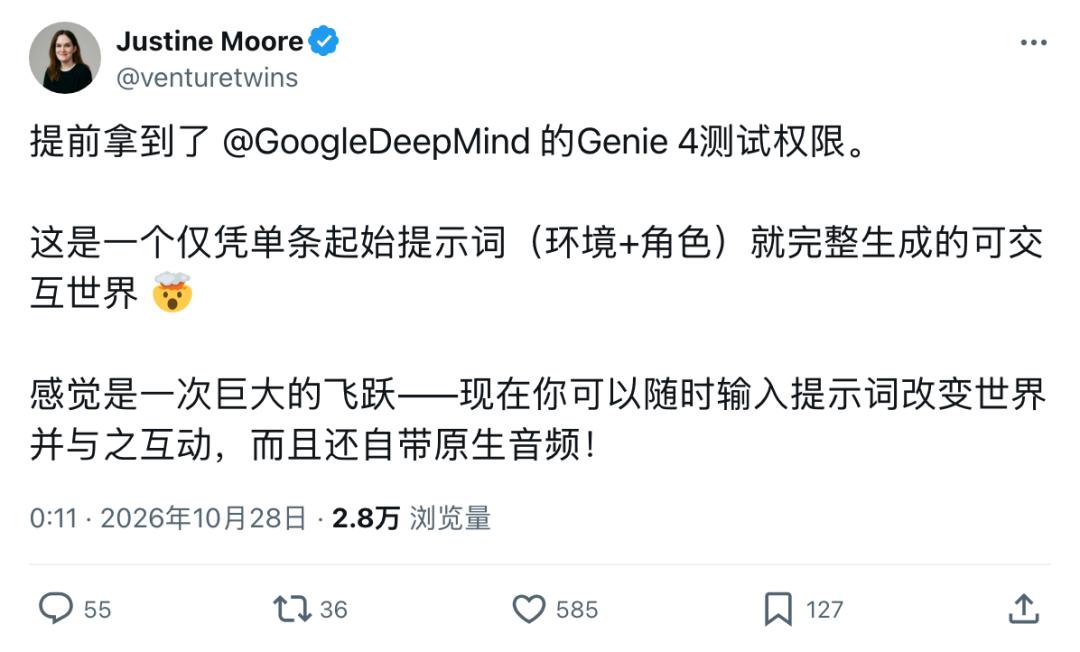
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 8)

在海底洞穴里,她点下「受诅咒的紫钻发光」和「电鳗群袭来」,洞穴深处立刻紫光爆闪,大群电鳗随之出现。
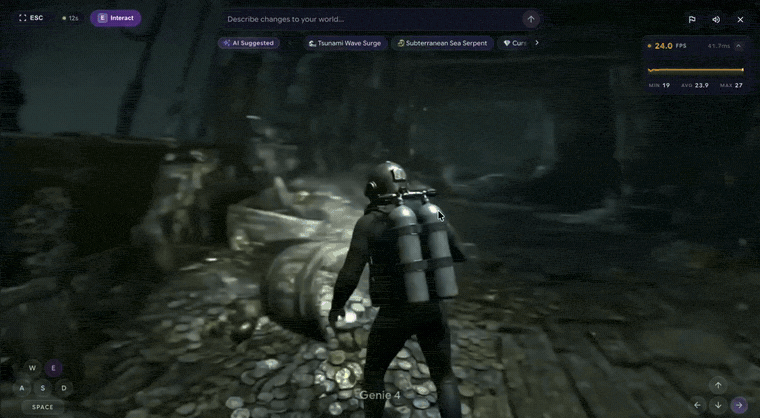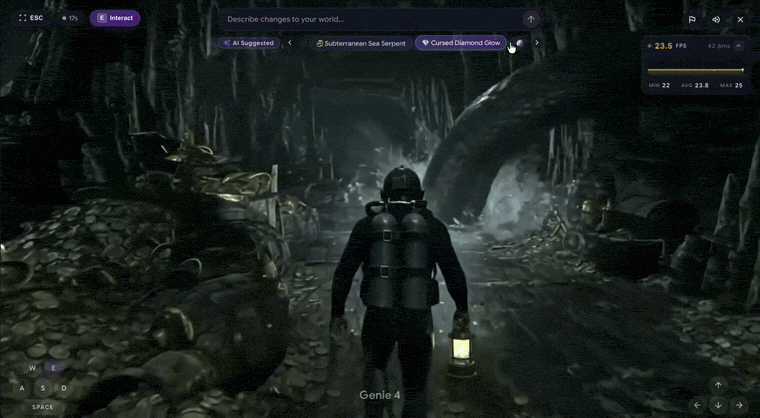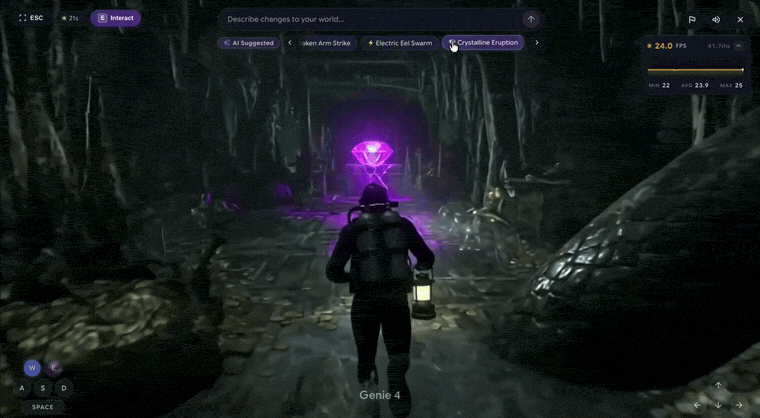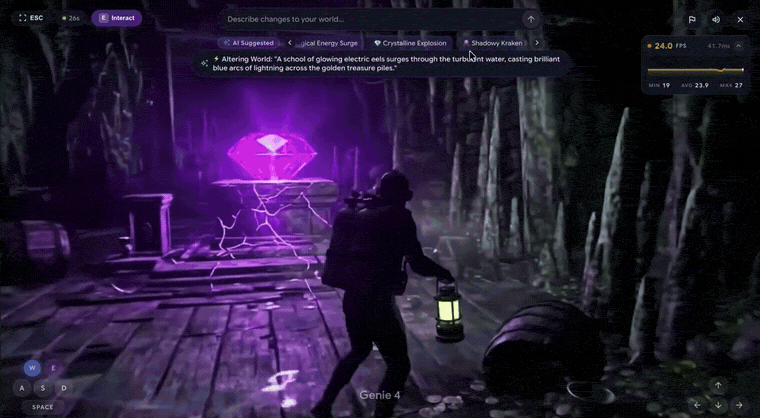
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 9)

再点「幽灵海盗现身」,海盗船长的亡灵立马登场,效果相当逼真。

谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 10)

前谷歌AR/3D产品经理Bilawal Sidhu则把Genie 4用成了科幻大片的实时虚拟片场:他召唤出UFO,再打出一句「它把我吸了进去」,UFO瞬间轰开牵引光束,准备把人吸走。
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 11)

谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 12)

四大关键功能

据谷歌官博介绍,Genie 4在四大关键功能上做了提升。

实时塑造世界模拟

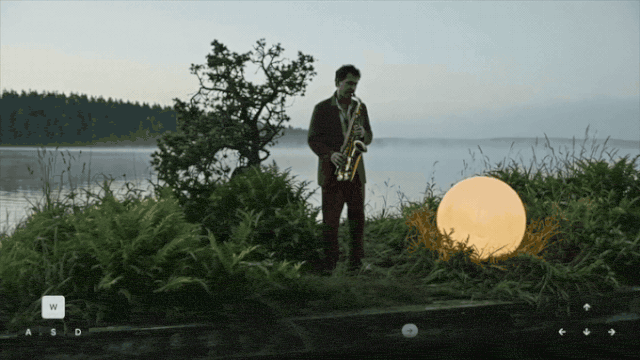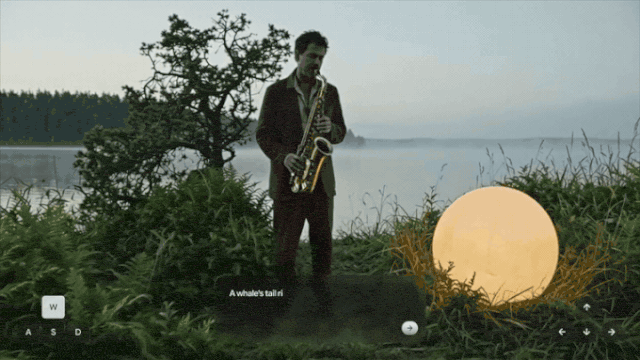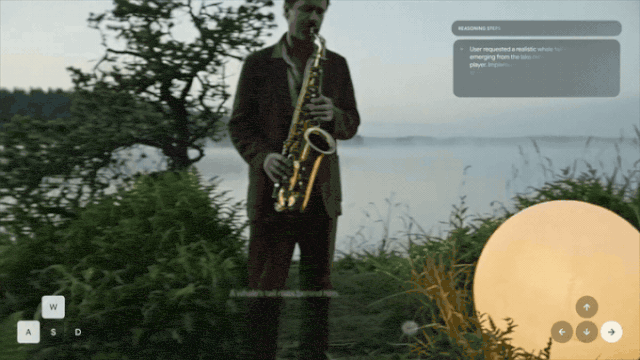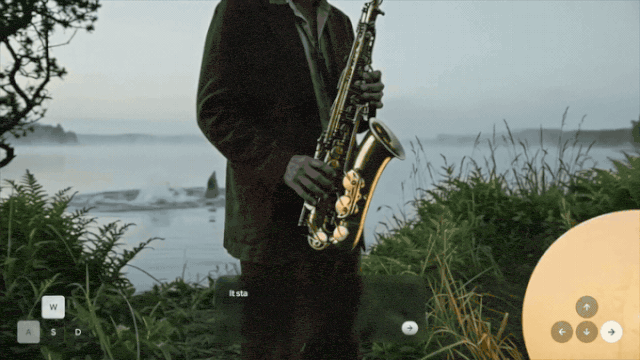
模拟场景可以用自然语言实时修改,比如换天气、移镜头,或者加入新的人物和物体,Gemini会结合周围场景来调整这些指令。在两次输入指令的空档,Gemini还会监控并引导场景,让整个世界流畅地运转下去。听起来,这不就是《盗梦空间》成真了?

一个男人在岛上吹萨克斯,敲下「鲸尾出现」,他身后的水里立刻浮出鲸鱼。接着让这个世界下雪,鹅毛大雪当场飘落。
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 13)

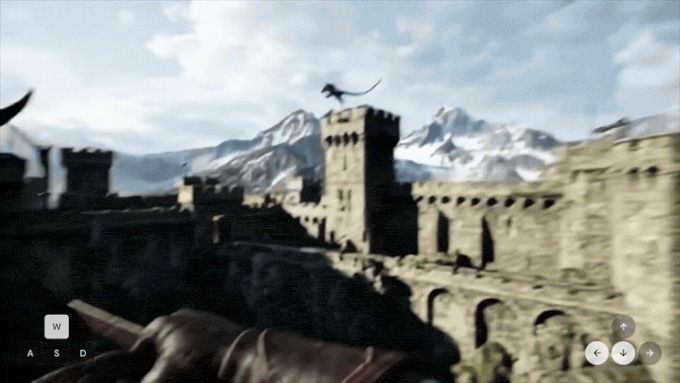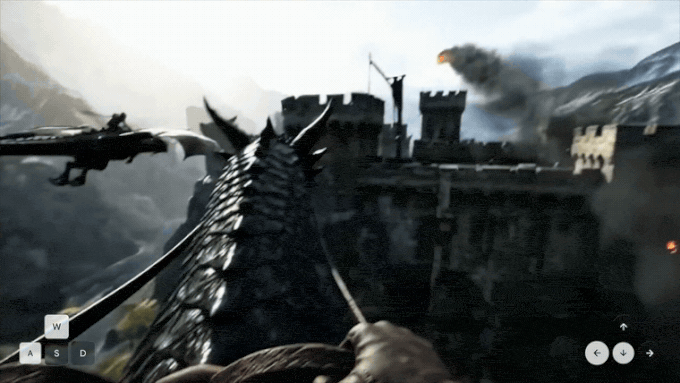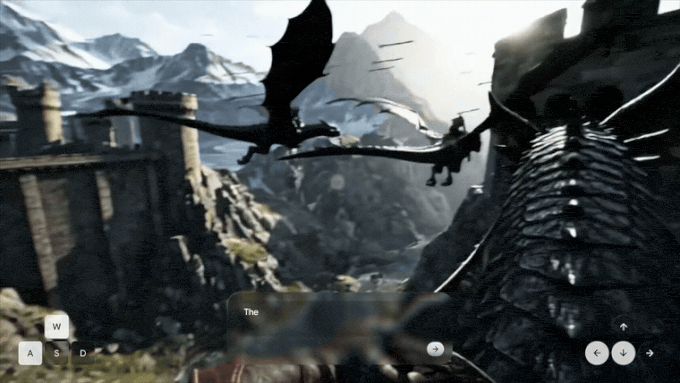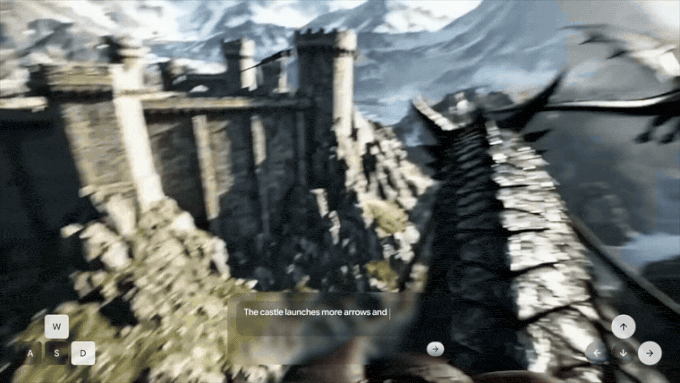
把镜头切到第一人称视角,实时改写世界带来的冲击感会更强。画面里,测试者以140公里的时速骑着巨龙俯冲,掠过古堡,此时下令「城堡发射火球」,塔楼当场喷出烈焰,火球擦身而过,刺激感拉满。
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 14)

另一个场景中,Genie 4先按用户提示生成南极冰封大地,再生成第一人称视角的乘热气球场景。
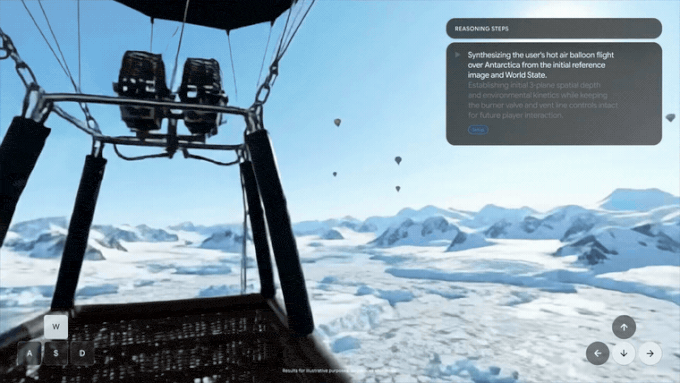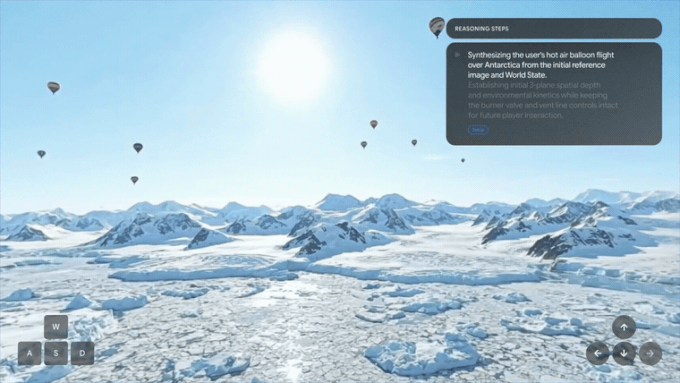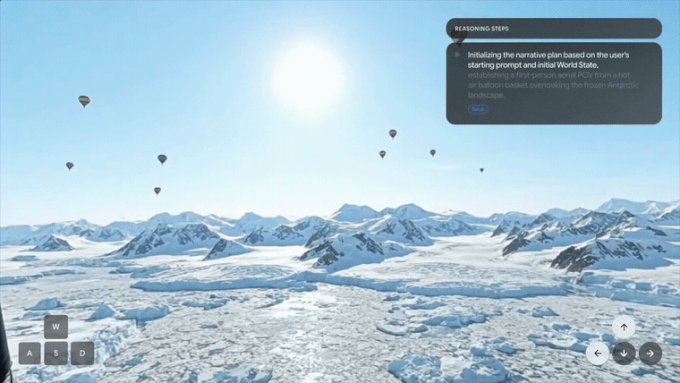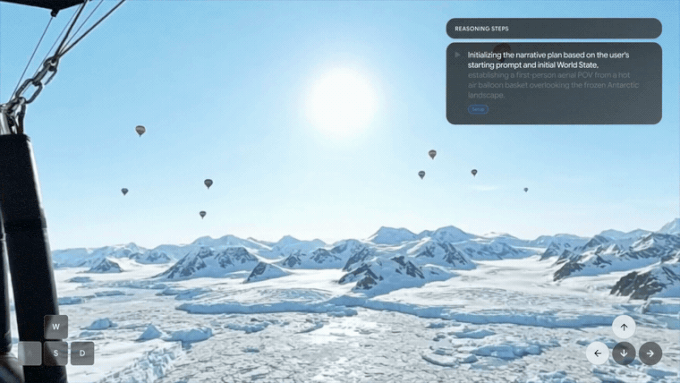
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 15)

拓展物理学和人类行为的现实边界

这一回,Genie 4为交互模拟立下了新的真实感标准。

凭借对世界物理规律的深入把握,Genie 4 模拟真实物理场景时相当逼真,空气动力学、碰撞这类情形都在其中。

Genie 4 这回最扎眼的提升落在人物模拟上——它能生成自然走动、会对环境作出反应、还能实时交互操控的角色。场景放到 80 年代的日本乡村车站,给出一个 prompt,乘务员便会喊出车提示。

再补一个提示,一位拎着行李箱的老妇人立刻现身。后面这些画面,足以让人感慨 Genie 4 的物理交互有多逼真。

户外庭院的台子上,大理石半身像被砸向西瓜。一声闷响,瓜瓤和汁水四散飞溅——从重力冲击到碎片轨迹,Genie 4 在实时交互中都还原得恰如其分。

柔体力学和空气动力学,Genie 4 同样应付自如。草甸上那块粉色丝绸,一阵风吹过便迎风翻涌,层层波浪丝滑逼真。
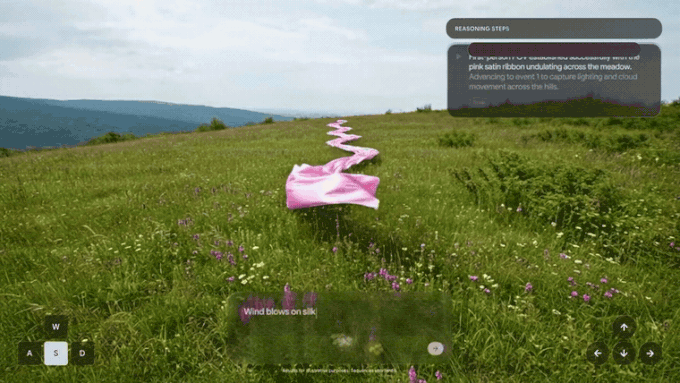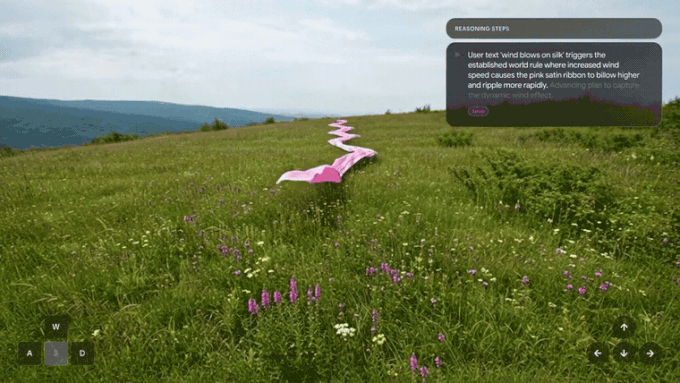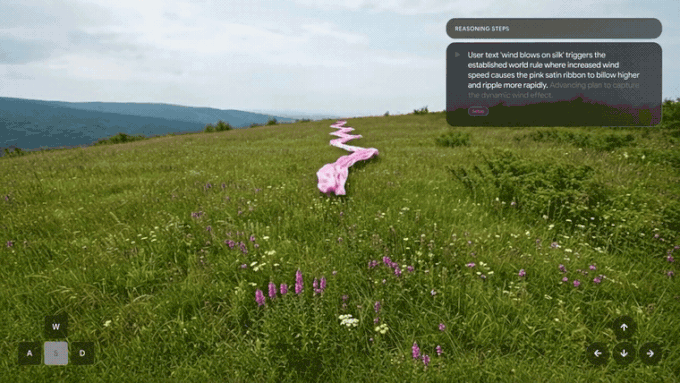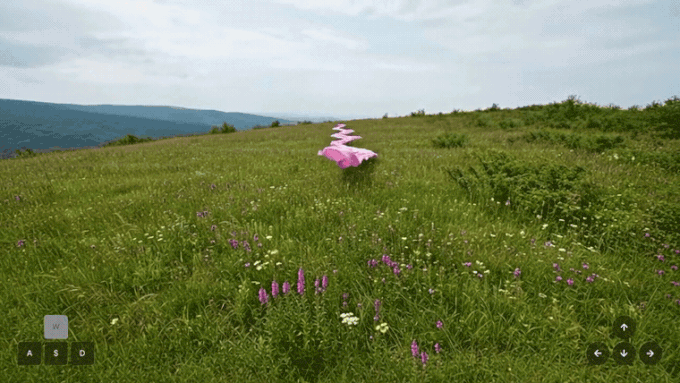
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 16)

枫树种子落地的特写镜头,逼真程度同样不减。镜头推到毫厘之间的微距视角,枫树翅果宛如直升机螺旋桨般自旋滑落,最后轻轻停在草叶之间。
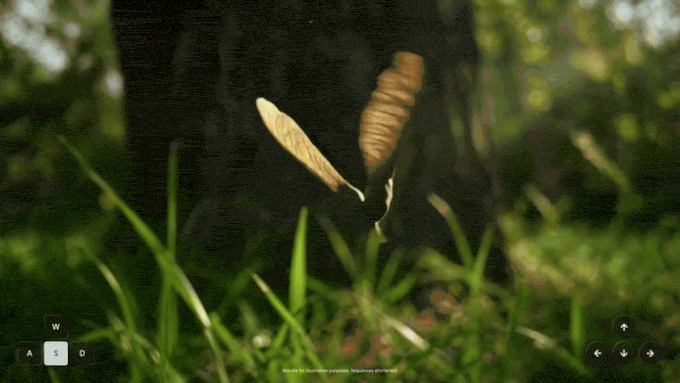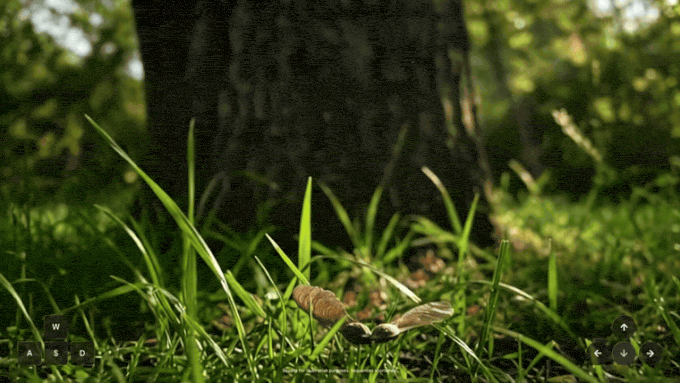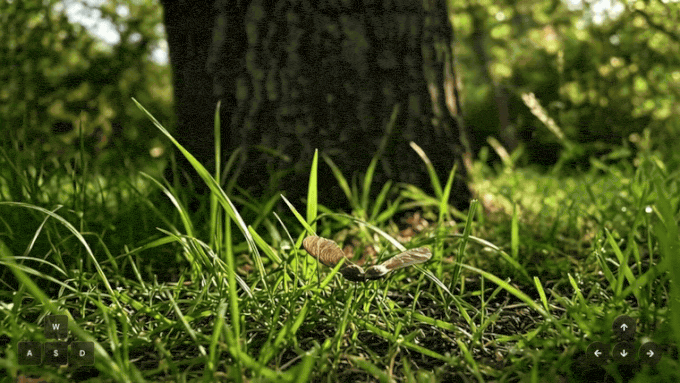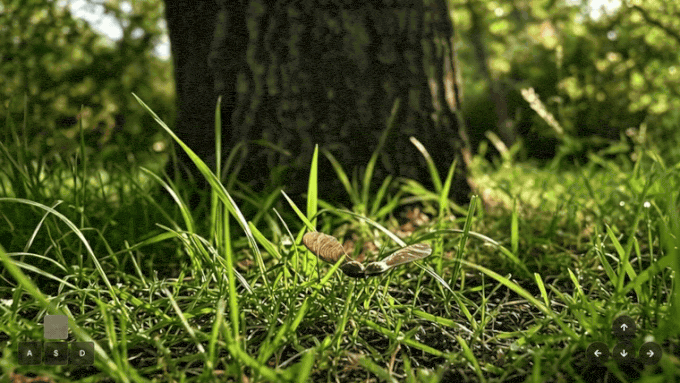
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 17)

告别「无声蜡像馆」,Genie 4能模拟声音了!

Genie 4 是谷歌旗下首款原生生成音频的实时世界模型。每个世界都自带环境声响,比如树叶沙沙、海浪拍岸。

不过真正的难关还是人类语言。Genie 4 为此加入实时互动对话能力:角色会依据你的输入或发生的事件,实时开口对话、做出反应。

在这个半透明的 3D 彩绘玻璃世界里,用提示词可召唤出一只鹿。最抓人的是,它的脚步声自动变成了清脆的琉璃碰撞声。

硬核架构拆解:三大Gemini轮番上阵,搭起「混合世界模型」回路

只把 Genie 4 看作画质更佳、还能出声的「大号视频生成器」,就小瞧了 Google DeepMind 的野心。以往的实时世界模型撑不过几十秒就崩,症结在于纯像素预测缺少长程逻辑规划,第一步做完,后面的目标早被抛到脑后。

为治这个老毛病,谷歌这次拿出颇具颠覆性的「混合世界模型」架构,让三款 Gemini 模型与 Genie 4 组队配合。世界模拟由此多出一个推理层面,Genis 4 得以模拟复杂的多步骤事件,也能在把 AI 引入现实世界之前,测试它们在不同环境里的运行表现。
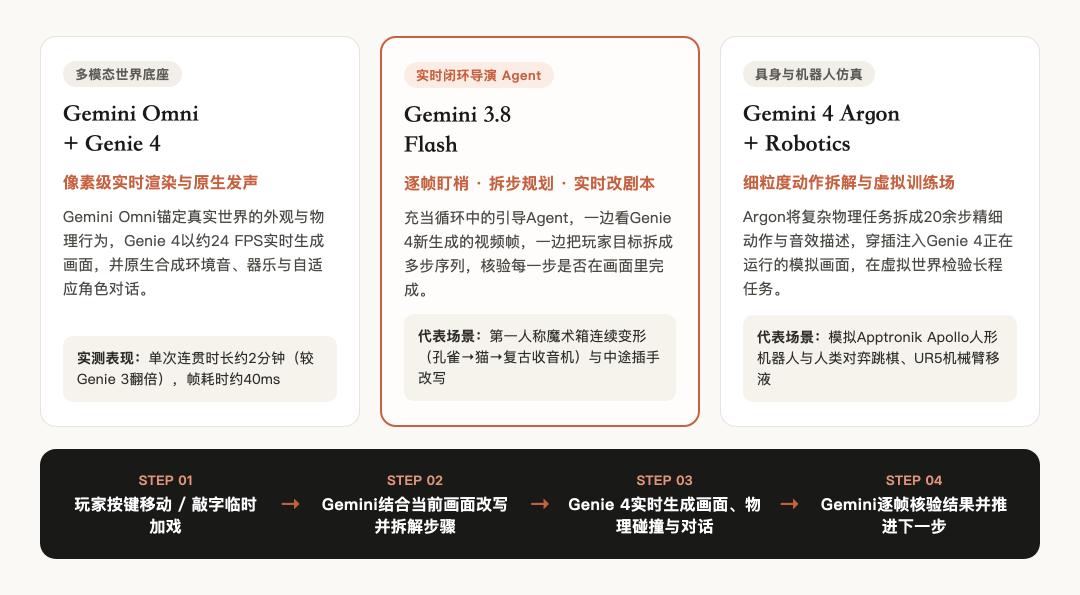
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 18)

第一重配合,是让 Gemini 3.8 Flash 在循环回路中担任实时控场的「总导演」。Genie 4 在前台逐帧生成画面时,Gemini 3.8 Flash 在后台实时盯画面、拆解多步推理序列,一边核对当前步骤是否完成,一边发出下一步指令。

用户一旦干预,Gemini 会马上调整,生成的世界具备可靠因果、程序员行为和多步骤推理。

先看这场近景魔术:玩家每回关上箱门、挥一下魔术棒,右上角的Gemini 3.8 Flash便会确认该步骤已完成,随后指挥Genie 4动手,先把孔雀变成橘猫,接着又把橘猫变成一台复古收音机!

就算演到一半突然改戏,这位「总导演」照样能当场把剧本重排一遍。

再比如,让一颗流星划过冰天雪地,再指挥灰冠鹤走到电子琴前啄出旋律,末了让它一飞冲天。

Gemini 3.8 Flash管的是「世界如何按逻辑演进」;Gemini 4 Argon和Gemini Robotics的加入,则把具身智能与机器人训练的天花板捅破了。

人只说一句「跟对面的男孩下跳棋,走一步红棋」,左侧的Gemini 4 Argon立刻把任务拆成22步毫米级动作剧本。

这些高密度指令实时灌进Genie 4的生成流,右侧的Apollo机器人随之捏棋、走子、对弈,一整套动作行云流水。
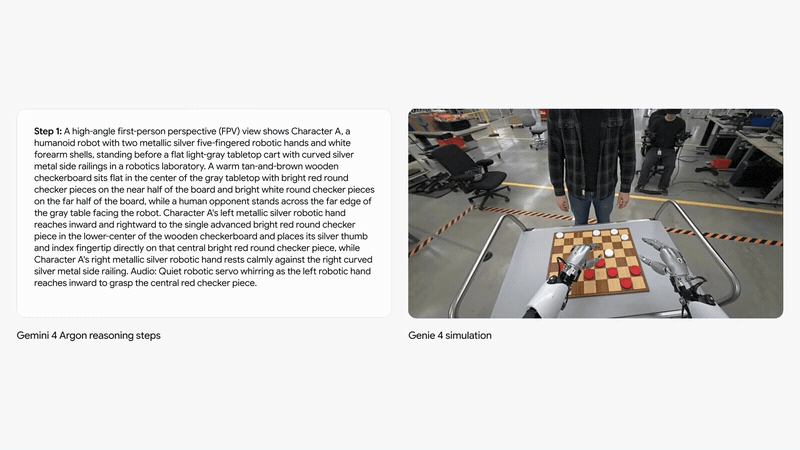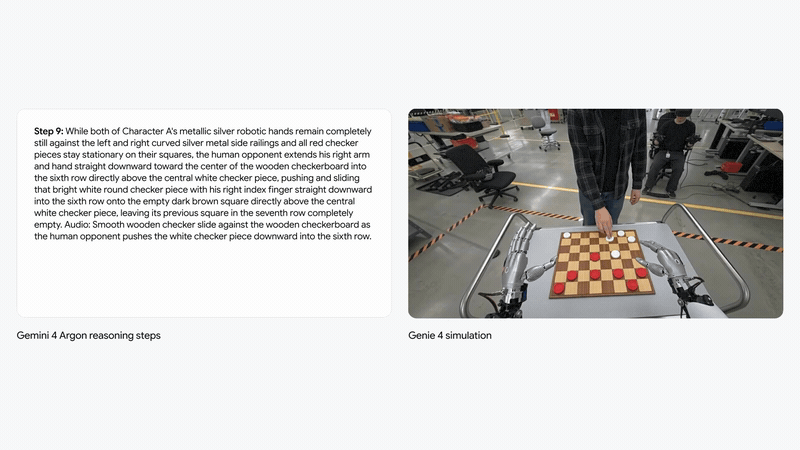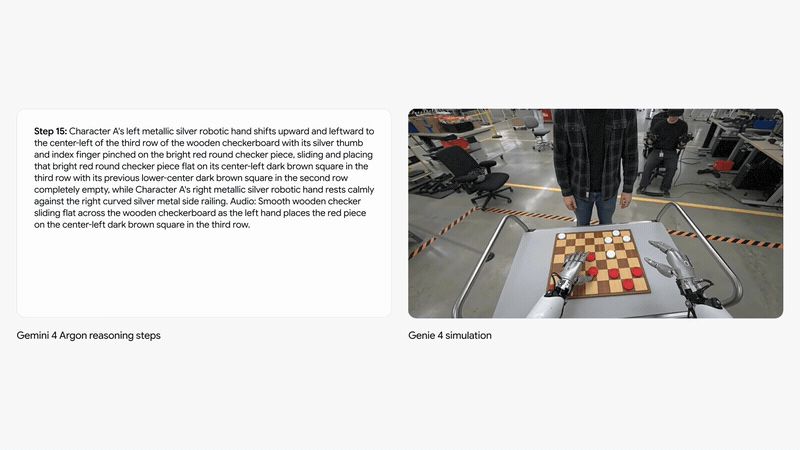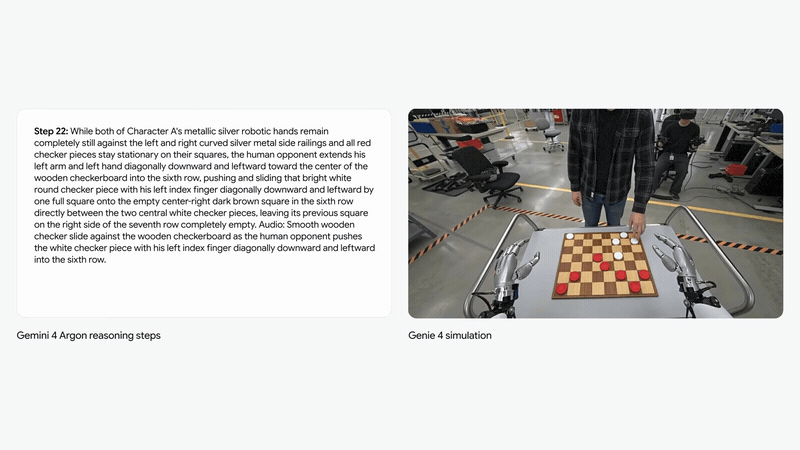
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 19)

Genie 4还能进实验室干精密科研的活。

工业级的UR5六轴机械臂也不例外,它在Genie 4里能精准夹住移液管,插进微孔板滴注液体。

中途把目标挪走也没关系,模型会实时重算策略,按新位置把抓取做完。
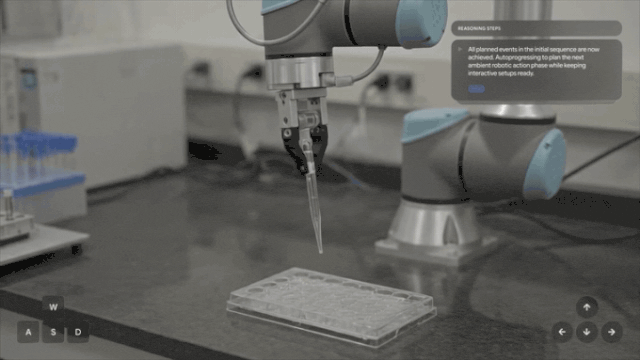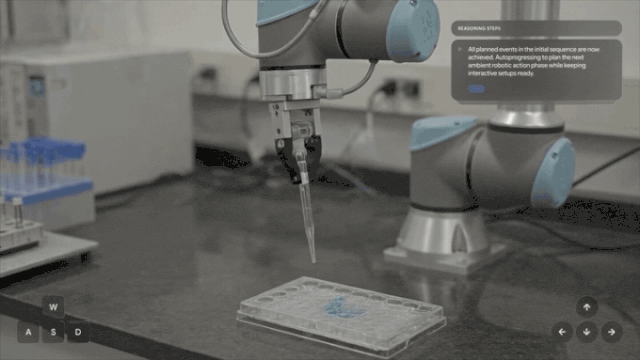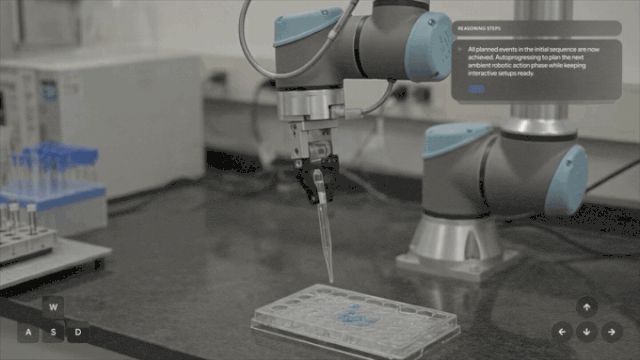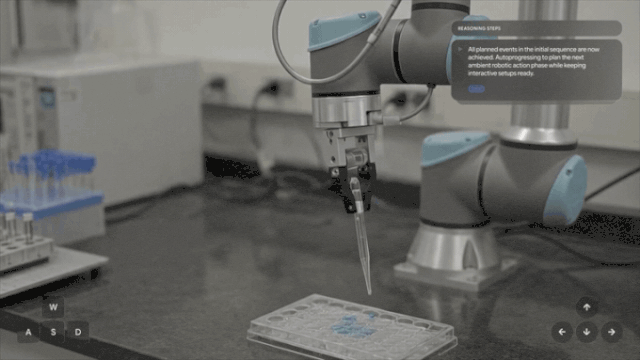
谷歌发布Genie 4世界模型:一句话生成可实时交互的“活体宇宙”(配图 20)

通往ASI的必经之路,是先造出一个世界

真正的「世界模型」指什么?

你推开一扇门,转身走开30秒,再回来时,那扇门还开着。

记得住物理规律,留得住空间记忆——视频模型与世界模型的分水岭,就在这里。

如今,Google Genie 4把这件事做成了。

「海量无标签视频预训练+少量动作轨迹微调」,再叠上Gemini的符号逻辑与长程记忆,Genie 4把单次连贯世界的维持时间一口气推到约2分钟。

打这儿起,搭交互环境再不用折腾手工3D建模。

Genie 4目前已向Google AI Ultra用户开放,还会作为史上首款进入Gemini API与Google AI Studio的世界模型,向开发者敞开大门。

谷歌的野心不难读出来:真正的AGI,绝不可能只活在对话框里!

AI一旦学会在自己造的平行宇宙里穷尽万千种物理可能,它真正推开现实世界大门的那天,也就不远了。

参考资料:

https://deepmind.google/blog/genie-4-a-new-generation-of-world-simulation/

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. DeepMind Genie 4发布:物理与人类模拟双提升,开放生态待解

    DeepMind发布Genie 4世界模型,宣称在物理真实感和人类行为模拟上进一步提升,将向开发者及Google AI Ultra订阅用户开放。本文梳理世界模型从生成可交互环境到逼近真实物理的演进,分析其对游戏、机器人与AI训练的意义,并指出开放生态、算力成本与评测标准仍是关键挑战。

    来源 AI 科技快讯
  2. 谷歌Genie 4实测:30秒生成可玩世界,24帧实时改?

    如果 AI 不再只是生成一段视频,而是直接创造一个可以走进去、随时改变,甚至能与其中人物交流的世界,会发生什么? 谷歌最新发布的 Genie 4,正在把这一设想推向现实。 当地时间 10 月 27 日,Google DeepMind 正式推出新一代世界模型 Genie 4,称其为「迄今为止最逼真、交互性最强的世界模型」

    来源 AI 行业观察
  3. Genie 4研究预览版发布:实时交互世界模型瞄准机器人训练

    一年前,谷歌发布了“可实时交互的世界模型”Genie 3。一年后,号称“迄今为止最逼真、最具互动性的世界模型”的Genie 4来了。Genie从来不满足于“生成一段以假乱真的视频”,它的目标是在你眼前实时运行一个能听、能说、能改的虚拟世界。需要注意的是,这次发布依旧是“研究预览版”,目前只对受邀测试者开放,后续会先向U

    来源 腾讯网
  4. 谷歌DeepMind发布Genie 4:可生成实时音频,场景能边跑边改

    谷歌DeepMind在最新研究预览中发布了第四代世界模型Genie 4,其亮点是在生成逼真交互世界的同时新增实时音频,并能通过提示词实时修改天气、摄像机角度或添加物体。Genie 4可将场景一致性维持两分钟,为上一代的两倍。谷歌强调其与Gemini模型的协同——Gemini担任'导演'负责规划与检查,Genie负责视觉

    来源 凤凰科技
  5. 谷歌发布Genie 4世界模型:原生音频加持,实时可玩3D世界

    物理AI 正成为科技公司的重要技术方向。北京时间10月28日,谷歌发布新一代世界模型Genie 4。与单纯追求视频生成不同,Genie 4的定位是“可实时操控、可听、可推理的动态模拟世界”。它原生支持音频生成,能根据场景实时输出环境音、音乐乃至角色对话。而作为又一款重磅模型,此次发布的时间点,正值谷歌AI投资叙事最受审

    来源 腾讯网
  6. Genie 4:实时交互加原生音频,世界模型能“进”了?

    Google DeepMind推出新一代世界模型Genie 4,主打高保真视觉与原生音频同步生成。该模型允许用户通过自然语言实时修改场景中的天气、物体或人物行为,并引入Gemini系列模型进行逻辑推理以维持模拟连贯性。目前仅面向受信任测试者开放预览,旨在探索其在机器人训练、游戏原型设计及影视预演等领域的应用潜力,同时承

    来源 AI 应用前沿
  7. 谷歌DeepMind发布Genie 4:AI世界开口说话,边玩边改

    出品 | 网易智能 作者 | 小小 编辑 | 王凤枝 骑着巨龙掠过山谷,视角随你转动,耳边是振翅声和呼啸而过的风声。谷歌这次展示的AI世界,已经有了几分亲手玩游戏的感觉。 打开网易新闻 查看精彩图片 图:谷歌官方演示节选,GIF不含声音 美国当地时间10月27日,谷歌DeepMind发布新一代世界模型Genie 4的研

    来源 AI 行业观察
  8. 谷歌发布Genie 4:一句话生成可玩世界,键盘漫游NPC开口对话

    阅读之前记得关注+星标⭐️,,每天才能第一时间接收到更新 谷歌刚刚推出Genie 4,迄今为止最逼真且最具交互性的世界模型。Genie 4 的最新功能: 照片级真实感:基于 Gemini Omni 构建,在空间和主题中呈现逼真的细节 高级物理效果:空气动力学、碰撞以及自然移动的人物 实时控制:通过提示更改场景、添加元素

    来源 腾讯网
  9. 微软MAI-Image-2.7-Preview发布:图像编辑榜排第二,仅次OpenAI

    IT之家 10 月 28 日消息,微软昨日(10 月 27 日)发布公告,宣布推出 MAI-Image-2.7-Preview 模型。微软人工智能首席执行官穆斯塔法 · 苏莱曼(Mustafa Suleyman)自豪地宣布:“MAI-Image 现在是全球排名第二的图像编辑模型!” 苏莱曼在推文中写道,基于 Artif

    来源 AI 行业观察
  10. Ndoc上线:前Meta总监打造AI办公平台,对标Office与Workspace

    前Meta AI总监Rohit Patel近日正式推出人工智能生产力创业公司 Ndoc ,并发布旨在挑战 微软 Office与 谷歌 Workspace的同名一体化办公平台。 该平台跳出了在传统电子表格中简单嵌入聊天机器人的既有模式,从零构建了包含“阶段”、“叙事”和“模型”三个独立标签页的工作空间。用户可通过“模型”

    来源 AI 开发者社区
  11. 禾赛发布Kosmo三维数据引擎:15分钟扫百平米,还要做机器人训练场

    作者|樊雅婷微信|FFF111f__禾赛在具身上又有新动作,这次和数据有关。近期禾赛正式发布了三维世界数据引擎 Kosmo,包括 AI 空间相机 Kosmo One 和云平台 Kosmo World。前者采集真实环境,后者将其转化为可编辑、可复用的三维空间数据,服务机器人训练、世界模型和内容创作。回看此前的布局,这并不

    来源 腾讯网
  12. 微软Azure Container Apps Express正式发布,沙箱层同步GA

    微软近期宣布Azure Container Apps Express正式发布(GA),这是一种部署模型,省去了环境预置(provisioning)这一步骤,并用带有偏好性的默认配置(opinionated defaults)取代了大部分配置项。它与Azure Container Apps Sandboxes同步正式发布

    来源 AI 行业观察
  13. GPT-6.1 Terra发布:API价格降50%,能力逼近GPT-6 Astra

    OpenAI 又卷起了大模型的性价比。 就在刚刚,OpenAI 正式发布新一代模型 GPT-6.1 Terra,主打更快的响应速度、更强的视觉理解和电脑操作能力,以及更低的使用成本。 图|博客🔗 https://openai.com/index/introducing-gpt-6-1-terra/ 相比上一代 GPT-

    来源 AI 开发者社区
  14. 千里科技AI毫米波雷达:10 TOPS NPU进雷达,端到端传感器要换思路?

    过去两年,聊智驾技术基本绕不开这几个词:端到端、VLA、世界模型,还有一张比一张贵的训练卡。讨论几乎全在模型那一侧。可有个问题很少有人正面问:模型换了,传感器要不要跟着换?最近有消息称,千里科技发布了一款 AI 毫米波雷达(4D),千里称这是首次在雷达里集成 10 TOPS 的 NPU。我把手头能拿到的材料从头读到尾,

    来源 腾讯网
  15. VAST开源EdenLive:RTX 5090单卡720P超24FPS实时生成

    VAST正式发布并开源了实时世界模型EdenLive,首次在实时生成的同时支持任意参考输入、任意画风生成和长时连续运行。在单张RTX 5090上,5B模型720P生成速度超过24FPS,端到端延迟百毫秒级。EdenLive采用解耦世界状态与视觉渲染的技术路线,由上游交互系统维护状态,生成模型负责视觉呈现。支持交互式游戏

    来源 AI 应用前沿
向下滚动自动加载更多