

三个00后创业18个月:Palo Alto 45亿美元买下Applied Compute
Anthropic上市,硅谷正在诞生新一轮财富神话。而在这场狂欢的另一角,三个从OpenAI离职的00后也提前拿到了自己的“大结果”——创业不到18个月,直接把公司卖了45亿美元(约合人民币320亿元)。 美东时间11月18日,美国网络安全巨头Palo Alto Networks(派拓网络)宣布达成最终协议,将以45亿
 Anthropic上市,硅谷又一轮造富故事正在上演。另一头,三个从OpenAI离开的00后已经先一步拿到自己的“大结果”:创业不满18个月,公司作价45亿美元(约合人民币320亿元)卖了出去。
美东时间11月18日,美国网络安全厂商Palo Alto Networks(派拓网络)对外称已签最终协议,将以45亿美元全股票方式收购AI基础设施初创公司Applied Compute。交易完成后,约70人的团队整体进入派拓网络,23岁的联合创始人兼CEO Yash Patil将担任派拓网络联席首席AI官。
这家公司跑得很快。11月2日,也就是大约半个月前,Applied Compute刚宣布完成3.5亿美元融资,投后估值32.5亿美元。两周多之后,派拓网络给出的收购价较这一估值高出12.5亿美元,溢价约38%。
他们做的是一门“AI外包”生意:帮企业训练专属AI。客户名单里有微软、英伟达、外卖平台DoorDash和法律AI公司Harvey,横跨多个行业。
按常理,做这种企业服务既得懂模型,又得摸清客户的工作流程,创业者多半是在行业里浸淫多年的老手。可Applied Compute的三位创始人Yash Patil、Rhythm Garg和Linden Li,年龄分别只有23岁、24岁和25岁。
三人从斯坦福相识,又一起走出OpenAI,创业不到一年半,就把这门“大生意”在巨头环伺的硅谷跑通了。
本来的身份是潜在客户,一轮安全评估后成了买家
派拓网络最早找上Applied Compute,为的是看看能不能买他们的服务,收购并不在计划内。
派拓网络董事长兼CEO Nikesh Arora在收购声明里说,最初是以“潜在客户”的身份去接触,想评估对方的后训练和推理平台。
网络安全公司有职业习惯,派拓网络为此派出旗下王牌威胁情报团队Unit 42,给Applied Compute做了一轮“前沿AI安全评估”。
Arora的说法是,一轮摸底下来,他们认为Applied Compute搭出了自己见过的最好的后训练和推理平台,研究团队也极为出色。于是洽谈方向从采购转向并购,派拓网络索性把整家公司买了下来。
派拓网络是全球最大的网络安全公司之一,目前市值接近2800亿美元,最新一季营收34.5亿美元,同比增长39%。过去一年它在并购市场出手频繁,先后完成210亿美元和33.5亿美元两笔收购。这次45亿美元拿下Applied Compute,在其并购版图里也不算小数目。
提交给美国证监会(SEC)的文件显示,45亿美元总价以派拓网络股票支付,参考股价取过去15个交易日均价,为337.16美元/股。
对派拓网络而言,这笔买卖算下来并不亏。Applied Compute半个月前刚融完3.5亿美元,交易中还包含其持有的约5亿美元现金及预付算力承诺;而派拓网络的收购对价全部靠发行股票支付。收购消息与超预期财报一同公布后,派拓网络盘后股价涨了约10%。
一家成立不到一年半的初创公司,能让硅谷巨头评估完就火速拍板,很大程度上是看中了三个年轻人的技术底子和创业经历。
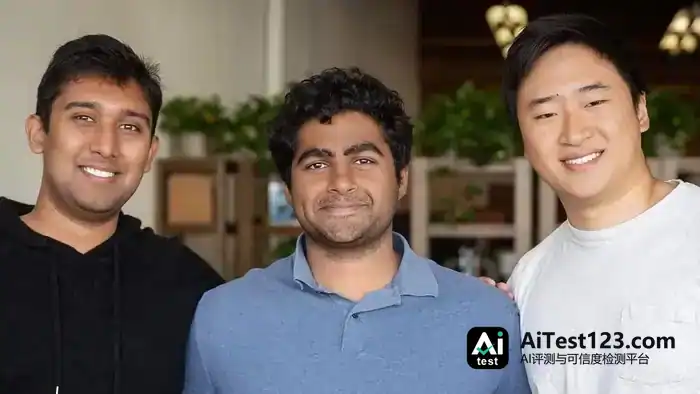
三位创始人是斯坦福校友,也做过OpenAI的同事。Patil最早进入OpenAI,大学期间他主动给奥特曼发邮件,争取参与ChatGPT研发,后来通过研究员驻留项目入职。随后他引荐了Garg,Garg又引荐了Li。
在OpenAI,Patil参与后训练基础设施和Codex相关工作,Garg研究推理模型,Li负责机器学习系统。模型训练和运行的好几个环节,三人合起来正好覆盖,这也成了他们后来创业的技术班底。
中国开源模型的崛起,则为他们出来创业提供了重要契机。
2025年1月,DeepSeek-R1发布。那几天,三位年轻研究员正在太浩湖滑雪。按他们后来的回忆,滑雪间隙三人一直在聊这个刚发布的中国模型,以及开放模型的未来。
有了OpenAI的经历,他们判断:开放模型的基础能力已经不错,企业完全可以拿来继续训练,让AI更熟悉自己的业务流程。几个月后,三人离开OpenAI,创办Applied Compute。
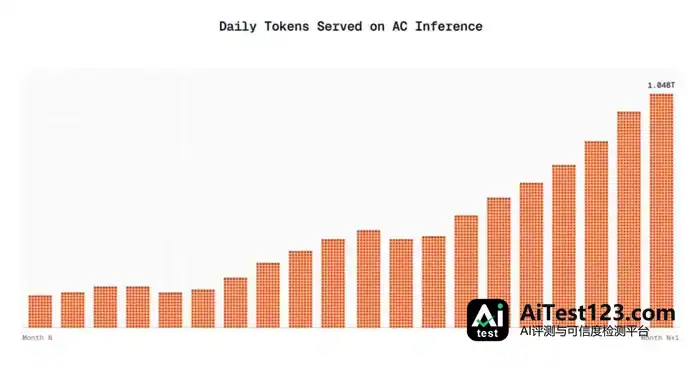
业务进展很快得到资本认可。2025年6月,公司还没公开亮相就拿到Benchmark领投的2000万美元融资;今年4月完成8000万美元融资后,估值达13亿美元;8月推出核心的AC2平台。到11月初融资时,客户自7月以来已在AC2平台上完成超过1700次训练运行,其推理服务每天处理的Token量超过1万亿。
谈到这次并入派拓网络,23岁的CEO Patil在声明中称,他们创办公司是为了让任何企业都能轻松训练、运行和改进专属模型;加入派拓网络后,安全会被放到所有产品的核心位置,也能更快触达全球最大的一批企业客户。
用中国模型,帮美国大公司省钱省事
派拓网络愿意开出45亿美元,关键在于Applied Compute切中了大企业用AI时的痛点。
在Applied Compute官网,这家公司把自己的业务叫作“专属智能(Specific Intelligence)”。按他们的说法,企业不必直接拿通用大模型来用,而是拿自己的业务数据训出一个只属于自家的模型。
对不少大公司而言,直接调用OpenAI或Anthropic的顶尖闭源模型,一旦用得频繁,既慢又贵。更麻烦的是,通用模型摸不清企业内部的具体标准——银行有银行的风控要求,外卖平台有外卖平台的审核规则。
为模型“后训练(Post-training)”掏钱的企业正在变多。Menlo Ventures近日的调查显示,受访AI构建者中做过后训练的比例一年内从6%升到10%,其中91%请了外部合作方。
Applied Compute干的就是大模型和企业之间的“中间商”生意:一头连着现成的开放模型,一头连着有需求的企业。挑模型、按客户任务继续训练、再帮客户把模型跑起来,都是它的事。
位置是中间商,干活却更像驻场团队。硅谷把这种扎进客户公司的工程师叫FDE(前线部署工程师),最早由Palantir推广,今年在AI圈明显走热。Applied Compute的工程师要进到客户公司,看明白人家的活儿怎么干,才知道模型该往哪调;训好的模型最终跑在自研的AC2平台上。
在帮美国大公司进一步压成本这件事上,中国开源模型让Applied Compute如虎添翼。Menlo Ventures估计,其统计的开源模型相关支出中,中国模型占了89%。
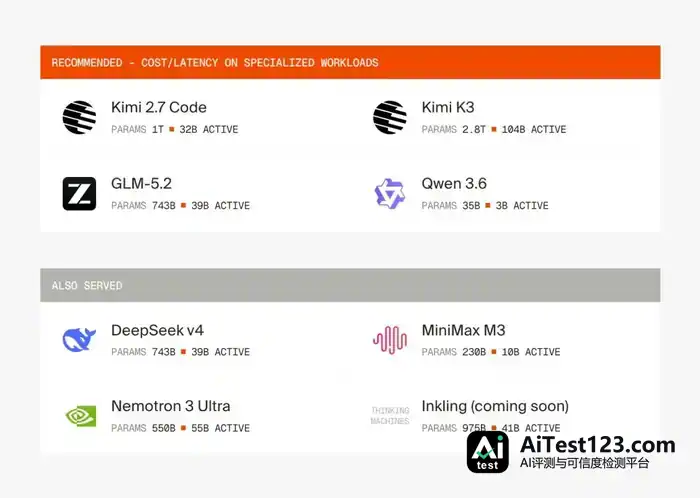
海量任务的开销压在企业客户身上,便宜好用的开源模型就成了刚需。千问、Kimi、GLM等中国模型把权重开放出来,用起来的成本普遍比美国顶尖闭源模型低一大截。可拿到开源模型只是有了个底座,训练人才和系统企业都缺,Applied Compute正好接手,把中国的开源模型调教成顺手的工具。
Applied Compute官网披露的案例显示,中国开源模型在多个项目里挑起了大梁。
和美国营销软件公司Clay的合作,盯的就是AI使用成本。Clay的AI产品每天帮用户搜集大量企业信息,一整批问题难度有高有低,什么都调用最贵的模型,开销太大。
Applied Compute拿阿里巴巴的千问,训了一个负责“派活”的AI调度员:先判断问题难度,再挑最划算的模型去处理。生产环境A/B测试显示,这套路由方案让推理成本最高下降47%,关键质量指标保持稳定。
到了法律AI独角兽Harvey那里,智谱的GLM又派上了用场。
法律文件一点错都出不得,AI要从成堆文件里找出答案,还得向律师交代清楚条款依据在哪。训练和打分用的是公开法律材料与合成任务,对象是GLM-5.2。评测结果摆在那里:特定法律文档任务中,训练后的模型回答质量有提升;跟Claude Sonnet 5比,平均每个单元格的推理成本降了54.8%。
底座是中国开源模型,性价比高;本事是工程师驻场调教模型。两头一凑,Applied Compute在一年半里把年化收入做到1亿美元,派拓网络也正是因此盯上了它。
卖身网安巨头,外包争议,和安全隐患有望一起解决
年化收入已经冲到1亿美元,半个月前刚融完3.5亿美元,估值正处于一路狂飙的上升期。
在这个节点,三个年轻人却选择溢价38%把公司卖给了派拓网络,这会是一个好归宿吗?
这背后或许与“AI外包”模式独立发展面临的瓶颈直接相关,而派拓网络的出现,恰好能帮他们把几个难题一起解决。
争议先落在商业模式上,还有大客户怎么拓展。被收购之前,外界追着问:Applied Compute到底算AI平台,还是靠工程师接项目的外包服务公司?
在投资者看来,这两种前景差得很远。要是后者,每来一家新客户,都得派不少工程师去摸业务、从头搭训练流程。客户一多,人力投入跟着涨。这门生意就没多大意思了。
还有一层疑问:帮客户把模型训练完,后续的推理运行业务能不能持续卖出去赚钱。公司此前披露过,同时用上它训练和推理服务的客户只占40%。
并进派拓网络,渠道至少宽了。按规划,Applied Compute将直接接入派拓网络遍布全球的7万多家客户网络。持续订阅这块,派拓网络给的目标很明确:到2029财年,这项业务要新增10亿美元年化经常性收入(ARR),是眼下1亿美元年化收入的十倍。
算力投入要持续烧钱,这笔账如今有大厂来付。派拓网络打算在未来三到五年内建成超过100兆瓦的全球推理算力基础设施,2027至2030财年为此投的资本开支(CapEx)不到30亿美元。
代价是对内也得干活:这群年轻人对外继续卖平台,对内要当派拓网络的“AI研发引擎”。派拓网络不造通用大模型,可旗下防火墙和安全软件每天要扛海量攻击。23岁的Patil出任联席首席AI官,这支团队计划到2027财年末扩到100名研究员,为派拓网络所有安全产品训练专有的大小模型。
最后,背靠网络安全巨头,也有望帮他们缓解企业客户在使用开源模型、尤其是中国开源模型时的安全顾虑。
今年下半年,美国相关部门接连对美企使用中国AI模型表达关切,联邦民事机构也被要求停用DeepSeek产品。开源模型底座来源敏感,传统跨国企业和金融机构即便看中低成本,企业首席信息安全官(CISO)也常常不敢签字,怕拿核心数据去训练开源模型,招来数据泄露或合规风险。
这道门槛,恰恰是网络安全巨头派拓网络的看家本领,初创公司单打独斗最难跨过去。
派拓网络CEO Arora的判断是,未来每家企业都会混合运行开源和闭源模型,直接把训练平台买下来,安全防护就能嵌进模型定制的第一步,企业也敢在自有环境里训练开源模型。
Arora还在财报会上说,这笔收购带来的业务机会,最终可能会“比我们今天做的业务还要大”。
一份45亿美元的收购协议已经摆在桌上,三个以中国开源模型为底子的00后凭它提前离场;而硅谷那边,“AI外包”究竟是不是一桩好买卖,争论还没停。














