推特创始人推“不识字”AI:语音直达语音,能否走出新路?
语音AI 两条进化路线
训练细节没公开,模型规模也没披露,外界很难判断这条路线的天花板在哪。但方向已经清楚:从语音直接到语音,这条被文本大模型压了许久的「非主流」路径,正被它指出来。
先会说话,再会接电话
Dessa 像是在实验室里琢磨语音的本质,同一时期另一条务实路线则加速进入日常工作流。xAI 几乎同时推出 Grok Voice 3.0,同样主打实时端到端语音交互(speech-to-speech)。
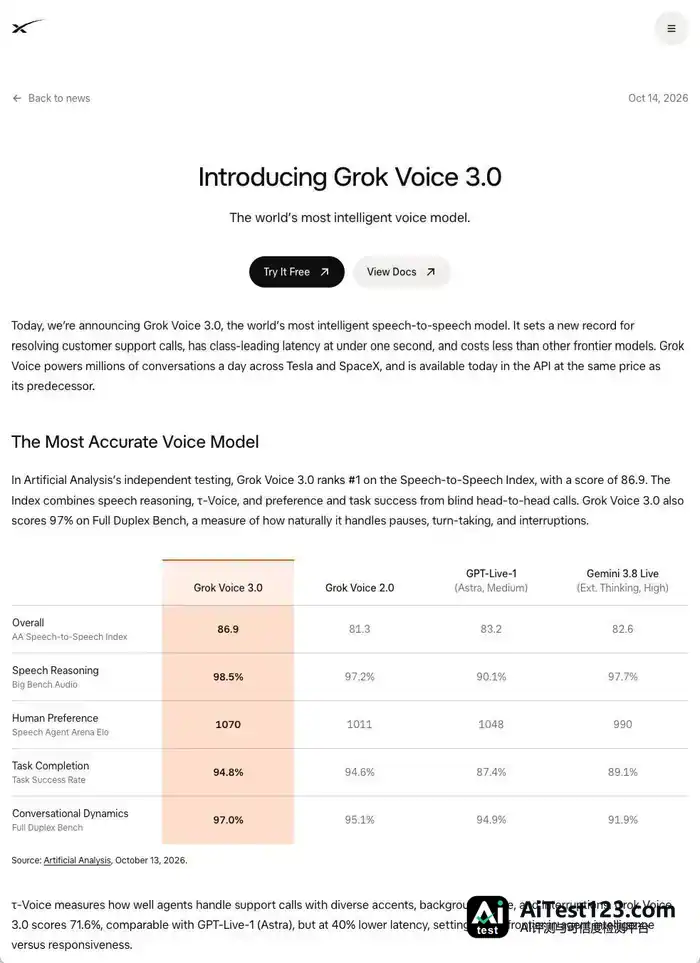
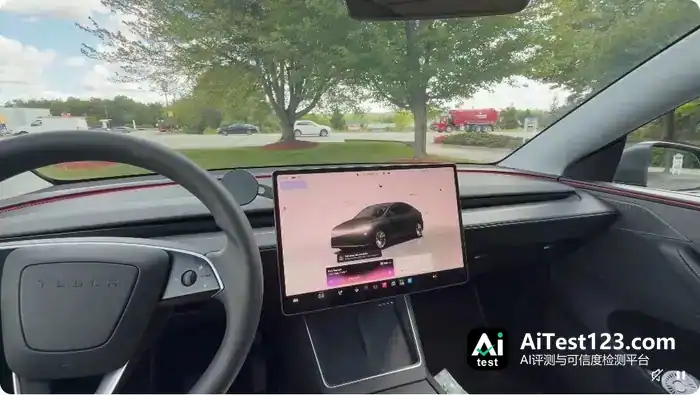
Dessa 那种「完全不碰文字」的洁癖式训练,和 Grok 这类主流商业模型不同,后者更在意把大模型的文本推理底子跟原生语音能力接起来,让声音真能派上用场。特斯拉车主就是例子:直接在车机上跟 Grok 对话,不用另外掏手机、点开 app。
这批主流语音模型往前跑的方向,其实都盯着一个极微妙的时间点:半秒钟。
在键盘上多等半秒,交流的性质几乎不变;电话里沉默半秒,对话就可能彻底走向另一头。所以哪怕 AI 答案无懈可击,只要它死板地等人说完才接茬、在不该笑的地方发笑、被打断后还固执念完原稿,用户立刻出戏。Grok Voice 3.0 的评测里,半秒就是优化目标。
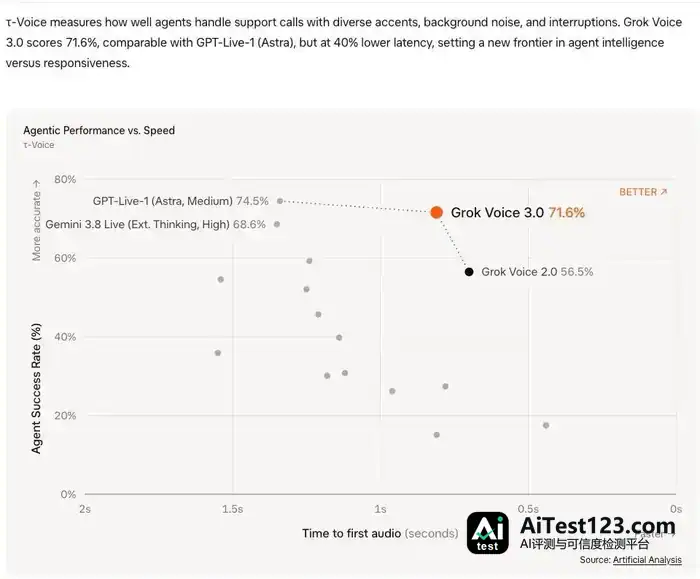
毫秒级的差别,落到商业应用上很直接。车载空间和客服热线,是语音 AI 目前最能施展的两个场景。xAI 披露的内部运营数据显示,这套系统每天除了应付大量特斯拉车内对话,还接 Starlink 每天约 2 万通客服来电,其中约七成问题不用转人工就能办结。
光快还不够。通话里夹着口音、背景噪音和频繁打断,模型得听清诉求;后台还得检索资料、调用工具、处理故障,最后礼貌挂断。这一串动作要丝滑走完,再加上自然的声音,才算真正「上岗」。
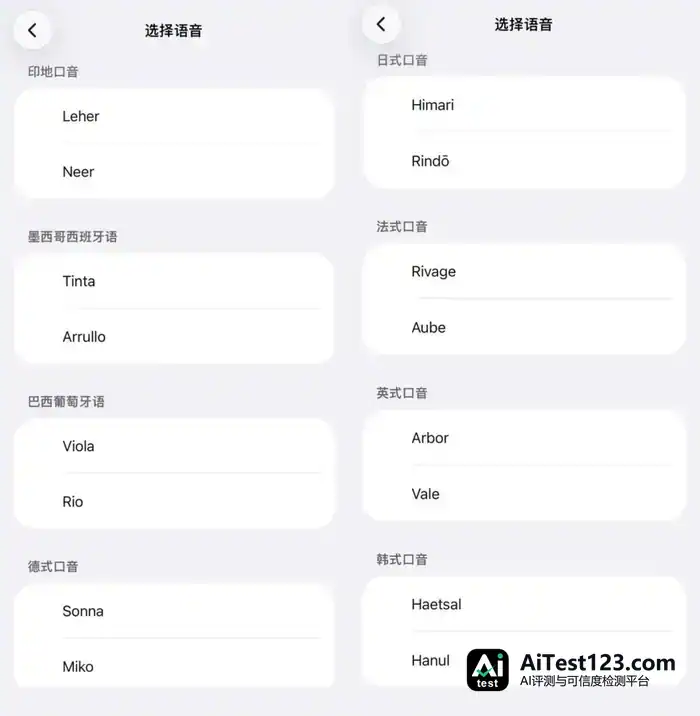
10 月中旬,OpenAI 更新语音模型 GPT-Live:ChatGPT 客户端里多语言口音的自然度有所改善,面向开发者的 API 一次性新增九款音色,包括日韩口音英语,还支持用文字描述直接定制声音。
AI 的声音,装着人对未来的想象
人类想象用语音实现控制,由来已久。1982 年的《银翼杀手》里,主角 Deckard 就对着图像分析仪一声声下口令,让画面平移、放大,直到锁定藏起来的线索。
到了《Her》,操作系统 Samantha 又往前走了一步:从执行指令的机器,变成随时陪在身边的灵魂伴侣。日常任务全包,声线还极灵动,男主才能跟它生出感情。
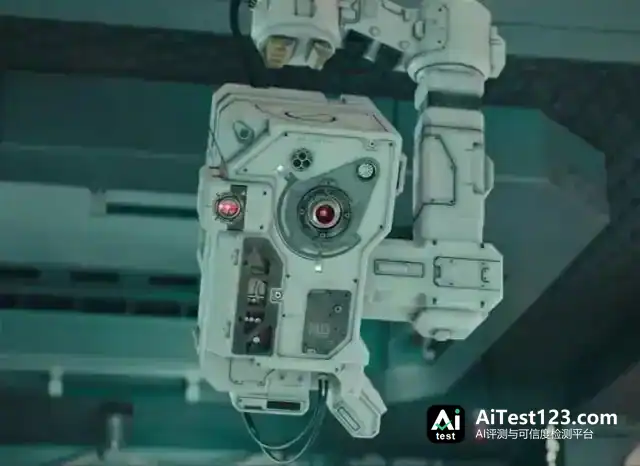
再前沿的机器,也得有声音。《流浪地球》里的 MOSS 台词不多,只出过寥寥几声,却是片中「人工智能」的代表,映着整体的科技水平。
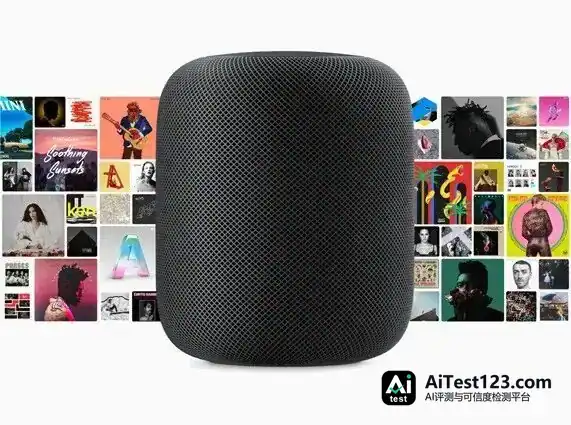
现实里的技术演进,也确实把原先的想象兑现了。早年的手机语音助手只会处理设闹钟、查天气这类固定句式;智能音箱进了客厅,最常干的也不过是放音乐、倒计时。大语言模型跟语音 Agent 结合之后,机器才算真听懂自由散漫的口语,开始帮用户收发短信、预约餐厅,听着开发者的口头描述去调用编程工具改代码。
可就算语音 AI 能处理远比「把灯打开」复杂的任务,屏幕在我们面前仍有一席之地。敲键盘、点鼠标,眼下还动摇不了。
问题不在模型不够聪明,而在声音作为信息媒介的物理属性。
声音是线性的。调度 AI 时,它特别适合表达一个模糊的意图,比如编程中的想法,比如指挥 Agent 安排任务。
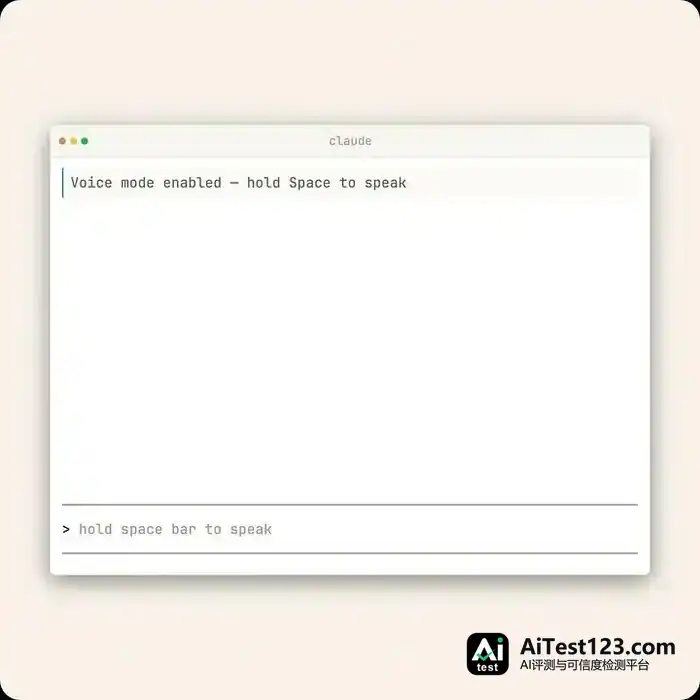
Claude Code 的语音模式
但到了工作生产场景,它不擅长让人同时审阅多个并列选项。写文章,要一目了然看到段落结构、随时回溯修改;写代码,得盯着屏幕比对差异和运行结果。哪怕只是订张机票,把几个航班的价格、起降时段、退改签规则同时铺在屏幕上扫一眼,也比听语音助手逐条念高效得多。
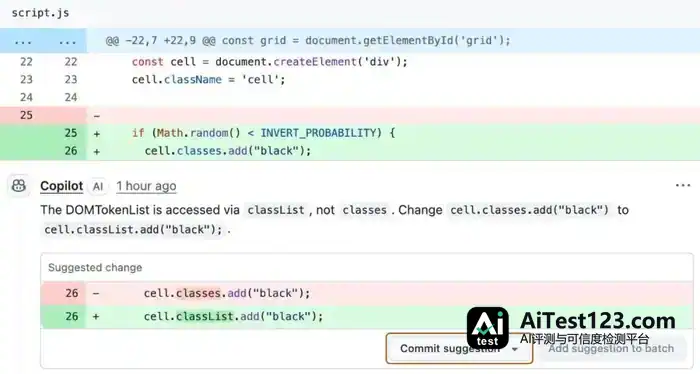
AI 替人代劳的权限越大,人越需要一块可视化界面,去核实它到底干了什么,在出错之前及时停下、回撤。
物理环境和社交礼仪也在暗中划边界。开车、做饭、双手抱着孩子时,视线和肢体都被占住,开口说话最省力;场景一换到安静的开放式办公室,一个人对着电脑不停说话,还是太诡异。整个办公室一起说,更像大型客户呼叫中心。
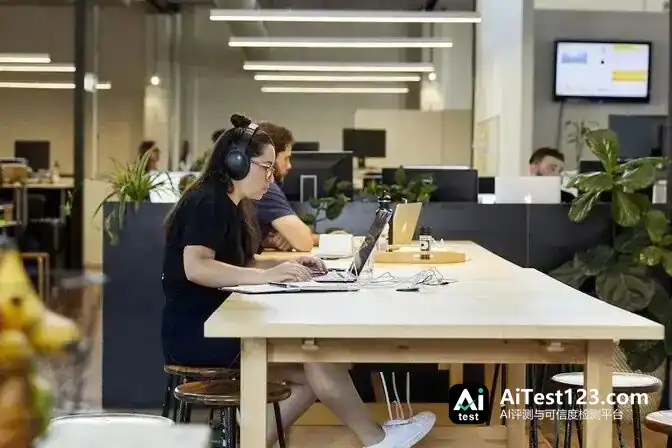
说到底,卡住这些场景的是信息带宽和隐私边界,工程师把模型延迟再压掉多少毫秒,也绕不过去。
科幻片里那句「对电脑说句话,一切就完成了」的预言,正一点点变成现实。可机器越会像人一样开口,我们反倒越明白:哪些时候能说,哪些时候还是得把嘴闭上。