LiberAI发布Liber-0:220万小时人类数据预训练,清华00后博士创业
超220万小时人类数据训练。

机器人前瞻(公众号:robot_pro)作者 | 周加琦 编辑 | 漠影
11月4日,机器人前瞻获悉,物理世界模型创业公司LiberAI当天正式推出Liber-0。这是一款世界动作模型,预训练用了超过220万小时的人类经验数据。
这家公司的创始人刘松铭生于2000年,目前是清华大学计算机系博士,拿过清华大学特等奖学金,多年来一直排在年级第一。他跟随视频生成模型领域学者朱军教授做研究,方向包括人工智能、具身智能和世界模型。
Liber-0把大规模人类视频与LiberSense Glove采集的人手动作数据结合起来,将人类积累的操作经验转成机器人的操作能力。这样一来,对真机数据的依赖降低了,跨任务、跨本体的泛化能力则得到提升。
在 GPT-6随机生成的60项任务上,LiberAI一共做了600次真机测试,事先没有针对这些任务专门采集机器人示范数据。Liber-0表现出零样本泛化能力,总体成功率达到36%。
还有一组实验显示,在使用数据手套采集的人类操作数据后,即便真机数据砍掉75%,模型的表现依然好于只用完整真机数据训练出来的模型。
一、GPT-6随机出题,60项任务成功率为36%
LiberAI安排了一系列零样本真机测试,用来检验Liber-0的实际操作水平。
这60项任务由GPT-6随机生成,共分三类:PnP(抓取放置)、Non-PnP(短程非抓取放置),以及难度更高的多步骤非抓取放置,每类20项,难度一级级往上走。
每项任务测10次,合计600次。Liber-0最终的总体成功率为36.0%;分类别看,抓取放置达到63.5%,短程非抓取放置为34.0%,复杂多步骤任务只有10.5%。
对照实验里,LiberAI让GPT-6 Astra独立控制机器人跑同样的60项任务,每项测3次。
Astra在三类任务上的成功率分别是8.3%、5.0%和1.7%,整体只有5%。它单次决策的平均推理耗时87.3秒,成功任务的平均完成时间为17.8分钟。这说明通用大模型虽然已经能操作机器人,但落到实际场景中,动作精度、连续执行和推理延迟仍是难题。
零样本评测之外,LiberAI还演示了Liber-0处理多步骤操作的表现,任务包括做奶茶、整理物品和操作抽屉等。
二、超220万小时数据预训练,让机器人学习人类操作
Liber-0之所以能在没有针对性训练过的任务上完成一部分操作,跟它用大规模人类经验来训练的路子有关。
过去,机器人操作主要靠针对特定机器人和任务采集的示范数据。这种数据采集成本高,规模也很难快速做大。互联网上却存在大量人类操作视频,覆盖不同物体、任务和环境,可以给机器人学习提供丰富的数据来源。
但人类视频数据没法直接变成机器人能执行的动作。人类和机器人在结构、运动方式上不一样;普通视频也很难准确抓取人手动作数据,技能迁移的难度因此增加。
针对这些问题,LiberAI从模型架构、数据训练和机器人硬件三个层面做了设计。
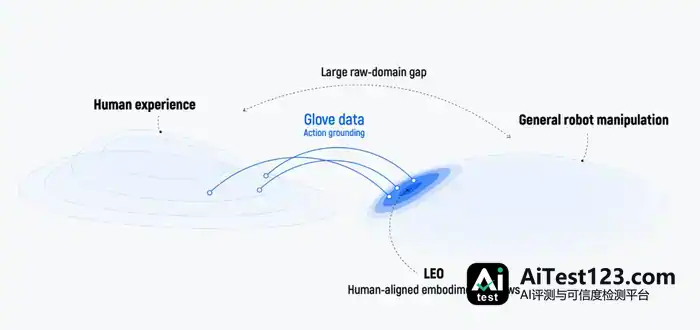
▲Liber-0 整体技术框架(图源:LiberAI)
模型架构方面,Liber-0采用混合Transformer架构,分为语言、视觉和动作三个模块,可以联合预测未来画面与操作动作。它还引入统一本体表征,把人类和机器人的身体结构、运动学特征等信息统一编码,让模型按不同本体预测相应动作,从而支持跨本体的技能迁移。
此外,图像分割、图像编辑和视频理解等任务也被纳入联合训练,模型对任务语义、空间关系和操作进度的理解能力因此增强。
数据训练上,Liber-0用了超过220万小时人类经验数据,来源主要有五种:LiberSense Glove采集的数据、跨本体机器人数据、公开第一视角视频、外部采集的第一视角视频,以及互联网人类视频。
预训练分三个阶段推进:先通过大规模视频学习预测未来画面;再把人类视频、手套数据和机器人动作数据放在一起,联合学习视觉变化与实际动作;最后提高数采手套和遥操作数据的采样权重,强化精细操作能力。
模型架构和训练方法之外,LiberAI还专门开发了LiberSense Glove和机器人LEO。
LiberSense Glove是套轻量化的可穿戴数据采集系统,厚度只有0.3毫米,重131克,人手运动数据和第一人称视角视频都能同步采。这套手套不用配机器人就能采数据,覆盖的人群、任务和日常环境更广,大规模操作数据的采集成本也跟着降下来。
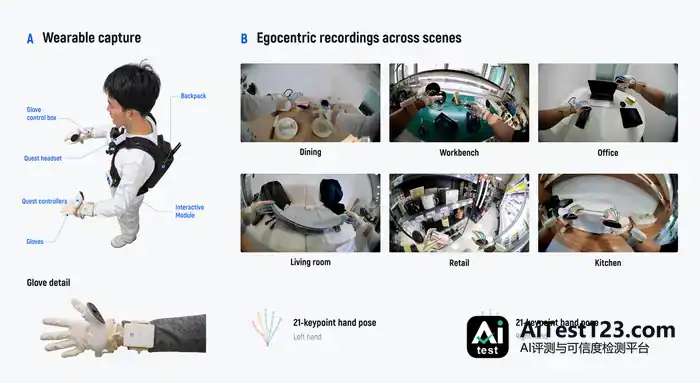
▲LiberSense Glove(图源:LiberAI)
机器人LEO那头,配了灵巧手、前臂、可活动腰部,手腕带三个旋转自由度。手腕旋转、弯腰、伸展这些动作,它做起来更接近人。
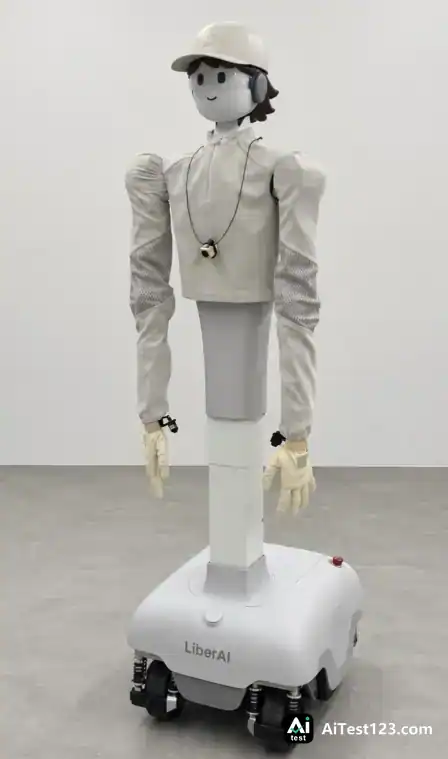
▲LEO(图源:LiberAI)
三、减少75%真机数据,结果表现反而更好
不同数据来源对机器人操作能力有什么影响,真机数据砍掉之后效果又如何,LiberAI用多组实验做了进一步验证。
第一步是对比五类数据来源,看训练规模往上走时,模型的操作能力怎么变。
数据手套采的数据优势很明显。只用1万小时手套数据做预训练,再经过相同的机器人数据后训练,模型在PnP和Non-PnP两类评测里都超过了用200万小时网络人类视频数据预训练的模型。
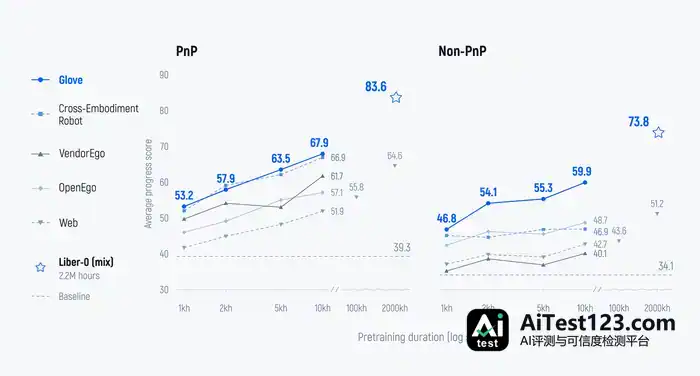
▲不同数据来源的预训练 Scaling 曲线(图源:LiberAI)
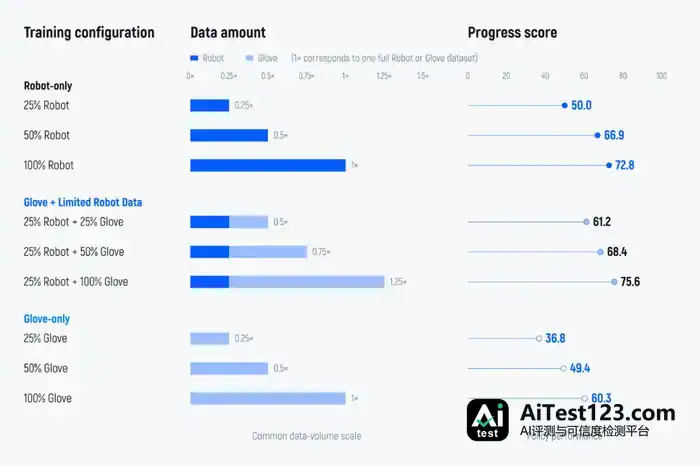
接着,团队又测了一件事:人类手套数据能不能让机器人少要些真机数据。
实验以只用机器人示范数据训练的模型为基线,再把手套数据和不同比例的机器人数据搭在一起训练。
机器人示范数据只留25%,掺入手套数据后,模型任务得分达到75.6,比用全部机器人示范数据训练的72.8分还高。
换句话说,真机数据少了75%,加上人类手套数据,模型表现反倒更好。
人类手套数据还有别的用处:真机示范数据里没有的操作技能,机器人也能靠它学。
团队设计了一组实验,机器人示范数据只含抓取放置任务,另外加入人类手套采集的非抓取放置操作数据。
测试下来,模型在非抓取放置任务上的得分从2.2升到47.5。这说明人类操作数据能帮机器人拿到真机示范没教过的技能。
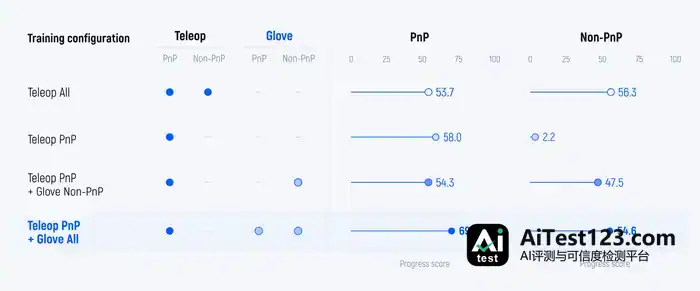
▲不同任务覆盖范围的手套数据与机器人数据组合实验(图源:LiberAI)
人类身体形态的多样性对技能迁移有什么影响,LiberAI也做了考察。训练数据总量不变,实验分别用1人、3人、10人、30人和100名示范者的数据来训练。
示范者数量越多,模型的跨本体迁移表现越好。手套数据与少量机器人数据混合训练的设置下,任务得分从60.6提高到69.5。
也就是说,除了把数据规模做大,让模型接触不同人的手部结构和操作方式,同样能帮机器人提升操作能力。
结语:人类操作经验的规模化利用仍需探索
训练数据规模扩大只是其中一步。不同来源、不同身体形态下的操作经验,怎么让机器人有效用起来,才是提升通用操作能力的关键。
接触、力度这些物理信息,人类操作过程中怎么准确获取,目前仍是待解的问题。往后看,数据采集的精度、规模和场景多样性上去了,人类操作经验有望支撑机器人学会更复杂的操作技能。