Seedance、MiniMax和Qwen image修改能力测试:3轮连改,谁更好用?-钛媒体官方网站
11 月 9 日,字节发布 Seedream 5.5;11 月 10 日,MiniMax 发布 H3-Image,还同步开源了模型权重。再加上阿里此前推出的 Qwen-Image-3.0-Pro,几家热门模型刚好凑到了一起。
最近,AI 画图模型又热闹起来了。
11 月 9 日,字节发布 Seedream 5.5;11 月 10 日, MiniMax 发布 H3-Image,还同步开源了模型权重。再加上阿里此前推出的 Qwen-Image-3.0-Pro,几家热门模型刚好凑到了一起。
用 AI 画图,有个挺现实的问题:图生成得好不好,指定的文字有没有错误、风格对不对;可一旦要局部修改或者抽卡,模型却把整张图重画一遍,那也够让人头疼的。
因此这次测试把三家拉到一起,先分别测五种绘画风格,再拿生成的图做三轮连续修改,重点看各家的局部调整能力。
五轮生图,三家各有风格
参与测试的三家是:MiniMax 的 H3-Image,走 MiniMax Code 客户端;字节的 Seedream 5.5,用豆包的 AI 创作入口;阿里的 Qwen-Image-3.0-Pro,在千问 AI 平台上跑。
三家拿到的是同一套基础场景要求:一个穿红色雨衣的女孩站在雨夜便利店门口,手里拎着一袋牛奶。然后分别让它们出写实摄影、儿童插画、盲盒手办、赛博朋克和扁平插画五种风格。每轮都新开对话,提示词发出去后不再纠正或补充,平台设置按默认及实际使用情况来。
还有,盲盒手办和赛博朋克这两轮的提示词里,我另外要求画面中出现“便利店 Convenience Store”的指定文字。
第一轮:写实摄影
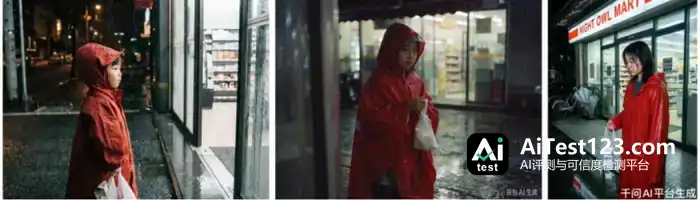
这一轮我更中意 H3 出的图。女孩、便利店都处理得挺自然,整张图看着像雨夜街头随手按的一张,而且这次是 4K 输出。
豆包的画面更集中在人物身上,背景虚化比较明显;千问则是竖版构图,人物和店招都有,但和另外两家的画面比例不太一样。
第二轮:儿童插画
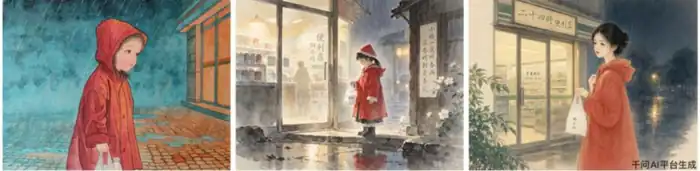
这一轮豆包画得很有绘本的感觉,雨水、灯光和便利店的环境都比较丰富,是我个人比较喜欢的一张。
H3 这边画面偏简单,更接近手绘插画的路子,只是便利店被切掉了一块,场景交代得有点敷衍。千问那张国风感挺重,细节扣得很细,不过离我想要的普通儿童绘本味道还差一些。
第三轮:盲盒手办
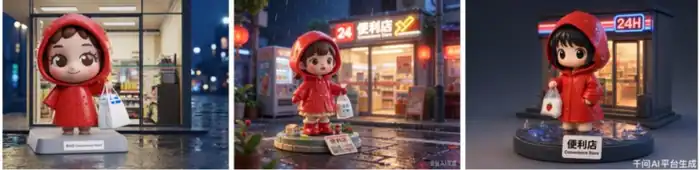
盲盒这一轮,三家都完成了人物手办的效果。
画面元素最满的是豆包,底座、店铺背景连同周边展示的东西都画齐了;H3 走的是简洁路线;千问更把重心放在人物上,大眼睛和红色雨衣格外显眼,牛奶袋上还多了个草莓图案。
这轮点名要出现的“便利店 Convenience Store”招牌,三家都写全了,没看出谁明显赢谁明显输,选哪种还是看各人偏好。
第四轮:赛博朋克
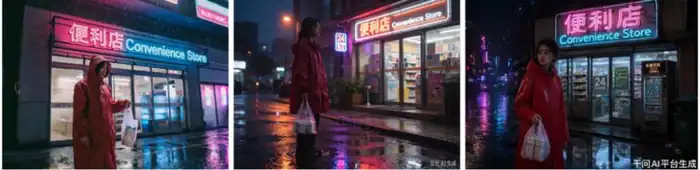
这一轮我觉得最有意思。
H3 出来的效果接近雨夜街头的霓虹景象,人和便利店的位置关系看着顺。豆包把店内和四周环境铺得很足,同样是一张完成度很高的雨夜街景。
未来城市那股味最浓的是千问这张,粉蓝霓虹、湿漉漉的街面、密密麻麻的招牌都到位,招牌上的中英文也没写错。光论视觉冲击,这张确实抓眼,就我自己来说,这是最合心意的一张。
第五轮:扁平插画
最后一轮,H3 的画面最简单,色块和线条都比较干净,和我想要的扁平插画更接近。
豆包和千问都往画面里加了更多光影和细节,画面是丰富了,却更接近那种带立体感的商业插画。豆包这张还把便利店画成了现实中的全家,招牌上带着品牌名和广告语,画蛇添足的味道多少有一点。
五轮比下来,没有哪一家每次都明显领先。H3 相对规矩,豆包偏爱把画面做得更满,千问时不时给出一些意料之外的效果。
生图只是第一步。真正值得继续比的,是后面的改图。
连续改图,差距就出来了
改图测试直接拿第四轮那张赛博朋克图接着操作,没有重新上传图片。随后连续提了三个要求:
- 把女孩手里的牛奶袋换成雨伞。
- 把红色雨衣改成黄色。
- 在便利店招牌上增加发光的“24 小时”字样。
每一步之后都没有补充其他说明,也没有重新生成整张图的提示词,只看它们能不能按要求在原图基础上继续修改。
先看豆包。
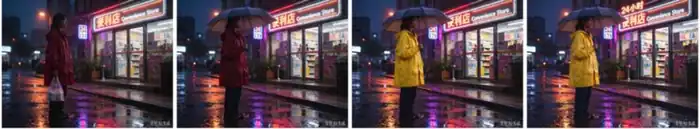
三个要求都完成了。
第一步换雨伞:牛奶袋变成了雨伞,女孩的站位、便利店、雨夜和地面积水反光都保留了下来。
第二步改雨衣:红色变成黄色,画面其他地方没有明显变化。
第三步加字:招牌上多了“24 小时”发光字,位置稍显拥挤,压在原有招牌上方,原来的招牌内容没有被破坏。
就编辑本身来说,豆包这三轮确实做到了改哪里、动哪里。
官方当初给 Seedream 5.5 造势时,主打的就是多轮编辑,还演示过连改 100 轮、非编辑区域尽量不动。这回测试没到 100 轮,只走了三轮,不过它的发挥算是过了关。
再看 H3。
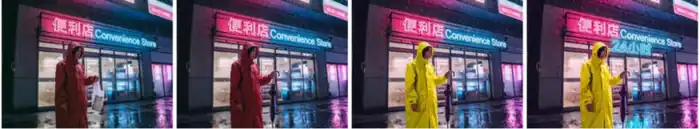
H3 同样完成了三次修改。
第一轮,女孩、店面和红色雨衣都还在,牛奶袋的位置换成了一把合起来的雨伞。第二轮,雨衣换成黄色,雨伞也照旧留在画面里。第三轮,原有招牌下方多出“24 小时”的霓虹字,没把原来的字盖住。
关键在于这三步是连续的:第三步是在黄色雨衣那张的基础上接着改,并非每次都从头重画。从构图、人物站位到雨夜氛围,三轮下来都没有明显漂移。
收尾时把原始 4K 图里的招牌区域放大看,原先那几个字仍旧清晰、没缺笔画。H3 这次直接输出 4K,几轮改动下来,画面细节也没怎么走样。
最后看千问。
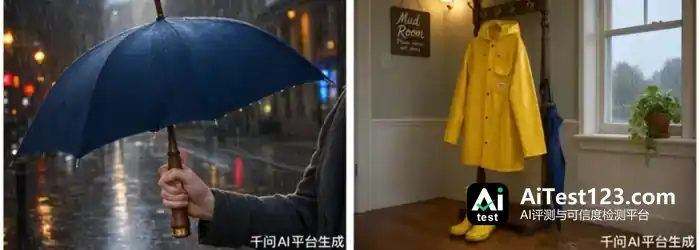
千问的结果让人绷不住。
第一次要求把牛奶袋换成雨伞,它给出的结果直接变成了雨伞的近景,原来的女孩和便利店场景没有保留下来。
第二次要求把红色雨衣改成黄色,画面又变成了一个走廊和衣帽架,和原来的雨夜便利店已经没什么关系了。
到第三轮,我直接不试了。
在同一个对话里连着改图,这次测试中它没能把原图改完。跟另外两家摆在一起看,差距一眼就能看出来。
几个零碎观察
除了画面本身和改图过程,这轮测试还有几处细节可以拿出来说说。
先说提示词的处理。H3 和千问在生成之前都会自动把提示词扩写一遍,千问的界面上有这个开关,而且是默认打开的。这算不上作弊,平台本身的能力,本来就该算进测试里。
比例这块,豆包我两种路子都走了:出图前在配置里选 4:3,连跑五轮都稳;再把比例直接写进提示词里跑一遍,出来的图同样正常。配置和提示词,两条路它都认。
千问和 H3 则会照着提示词里写的比例去动。千问把画幅调了回来,H3 连参数怎么调都会主动讲明白原因。
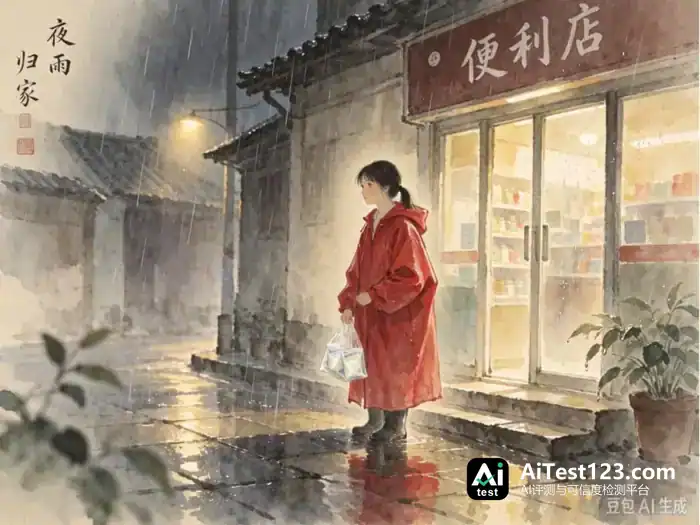
出图规格上同样有区别。H3 全程给的是 4K 输出,另外两家出的图尺寸小一截,放大看细节倒都没问题。
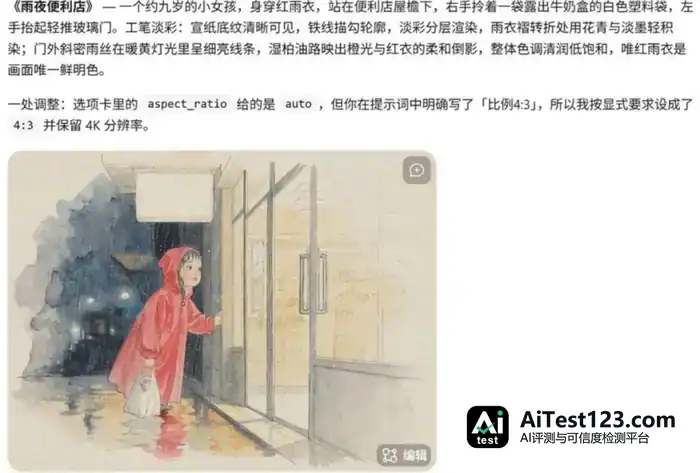
千问的平台还允许一次出好几张图,尺寸和数量都能在输入框里设,最多一次能直接出 6 张。这次测试每家每轮只跑了一张,这个功能没派上用场,不过对想一口气多挑几张的人来讲,它挺实用。
再说速度。豆包这回大多十几秒就出图,千问差不多一分钟,H3 在部分测试里接近一分半。当然,这只是我这次跑下来的感受,实际快慢还跟任务和平台当时的状态有关。
最后是水印。豆包和千问出的图带着平台水印,H3 这回没有。
说下感受
整轮测下来,三家出图都不差,差别更多落在画面风格和细节处理上。
可要是生成完还得一遍遍改,H3 和豆包这次明显更让人放心;千问出图有亮点,偏偏连续改图这一环没达到预期。
让我给三家各配一个场景的话:常要连着改图的,豆包和 H3 这次都靠得住;对画幅比例、清晰度和提示词执行有明确要求的,H3 更占优;主要拿来出单张图、基本不用后续改的,千问表现也不赖。
当然,这只是我拿同一套提示词做的一次小测试。不过对我而言,AI 画图不只看第一张能不能画得好看,能不能顺着我的想法一直改下去,一样要紧。