文心5.5Flash Base开源:2800亿MoE,多项基准超DeepSeek-V4

资讯 AI 开发者社区 作者:编程导航 全文 595 字 · 约 2 分钟读完 配图 2 张 分类SOTADeepSeekDeepSeek-V4百度深度求索开源

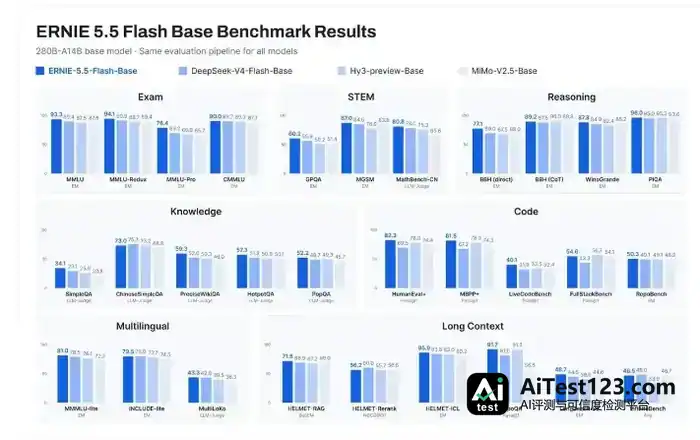
11月5日,百度正式开源全新基座模型文心5.5Flash Base,在知识、推理、数学、代码、多语言和长上下文等多项基准测试中刷新同尺寸模型SOTA表现,超越DeepSeek-V4-Flash-Base、Hy3-preview-Base等同类模型。 该模型采用MoE架构,总参数量达2800亿,激活参数140亿,使用33

所属频道 大厂动态开源生态

11月5日,百度开源了全新基座模型文心5.5Flash Base。该模型在知识、推理、数学、代码、多语言和长上下文等多项基准测试中刷新同尺寸SOTA表现,成绩超过DeepSeek-V4-Flash-Base、Hy3-preview-Base等同类模型。

文心5.5Flash Base采用MoE架构,总参数量2800亿,激活参数140亿。预训练用了33.5万亿Token,预训练上下文长度最高128K;到了微调与推理阶段,支持的上下文长度最长可达100万Token。
QQ20261105-153729.jpg

效率是这款模型的主线,系统层做了不少算法创新。注意力机制上,它引入Latent-Gated Sparse Attention,把HCA与MLA组合起来压缩历史信息,并对历史位置做细粒度访问;低秩门控注意力让门控投影权重参数减少75%,虚拟头注意力则用来提升表达力。

专家路由方面,模型采用Multi-Router Latent MoE,用多个独立路由器改善专家选择的效用。训练目标上引入ECHO,复用主干最后一层来学习预测后续Token,省掉了额外的MTP模块。大模型基建上,团队优化了分布式Muon优化器,还推出FlashMask-4注意力算子,让大规模训练的通信与显存利用效率进一步提高。

眼下大模型的竞争,正朝着模型能力、训练效率与场景创新协同演进。文心5.5Flash Base开源后,专业模型的开发门槛降低了,开发者也多了一个构建定制化专业模型的高效技术底座。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 文心5.5 Flash Base开源:2800亿参数MoE,多基准同尺寸SOTA

    11月5日,百度正式开源最新基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base)。模型采用MoE架构,总参数量2800亿,每个 Token 激活140亿参数,使用33.5万亿个 Token 完成预训练,预训练上下文长度最高达128K,微调与推理阶段支持最长100万 Token上下文。在知

    来源 腾讯网
  2. 百度文心发布ERNIE-5.5-Flash-Base:280B参数,开放预训练权重

    IT之家 11 月 5 日消息,百度文心大模型今日发布 ERNIE-5.5-Flash-Base,开放 ERNIE 5.5 Flash 预训练终点的权重。 这是一个稀疏 MoE 语言模型,总参数 280B,每 token 激活 14B,在 33.5T tokens 上从零完成预训练;最长训练上下文为 128K,微调与推

    来源 AI 行业观察
  3. 豆包工作首次接入第三方模型,首批上线Kimi、智谱与DeepSeek

    10月29日,字节跳动旗下 豆包工作 团队订阅版与企业订阅版正式全面接入第三方模型,首批上线Kimi K3.1Pro、GLM5.3以及DeepSeek V4.1Flash三款外部大模型。该功能上线后默认开启,企业用户无需额外采购,调用消耗的Token将直接从账户已有的AI点数中扣除。 此举标志着该办公Agent产品打破

    来源 AI 开发者社区
  4. 梁文锋密集看具身项目:DeepSeek两轮融资1055亿元后的下一步

    「核心提示」从埋头做模型到密集看项目,梁文锋在想什么? 世外高人要下山了。 近期,外媒曝光了DeepSeek第二次融资的详细情况,目前共筹集1055亿元人民币,腾讯和宁德时代领投。从原本“钱足够,不接受外部融资”,到半年之内连续进行两轮融资,梁文锋改变了过往姿态。 下山之后,高人也开始把目光看向了大模型之外的地方。据了

    来源 AI 行业观察
  5. 漫步者:AI功能已全面上车,耳夹式OWS明年加码

    每经AI快讯,11月5日,漫步者在投资者关系活动中表示,AI相关功能已在公司产品中全面搭载,如“漫翻译”功能实现多国语言实时翻译、“智能助手”已接入豆包和DeepSeek双大模型、“AI会议速记”功能实现语音实时转文字。近年来,开放式耳机市场处于快速增长阶段,公司2026年深化了带有AI功能、不同细分消费场景尤其是耳夹

    来源 腾讯网
  6. 腾讯 Hy4 正式版亮相:挤进最强开源阵营,主打"真干活"

    腾讯混元 11 月 4 日发布最新一代大模型 Hy4 正式版。比起 8 月底推出的 preview 版,这回不仅显著扩大预训练与后训练规模,还首次引入视觉能力——能结合感知、推理与工具调用,做图像处理、图表分析与数学视觉推理。更难得的是 Hy4 首次支持"电脑操作",可混用命令行与图形界面;腾讯还针对 Blender、

    来源 AI 开发者社区
  7. 微信PC端9月活跃用户超1.6亿居首,AI应用占前十中三席

    【TechWeb】11月5日消息,第三方数据机构QuestMobile近日发布《2026年秋季中国移动互联网实力价值榜》,其中的"中国互联网PC应用用户规模TOP10"榜单显示,微信PC端9月合计活跃用户数超过1.6亿,稳居第一并大幅领先其他产品。 该榜单统计口径为2026年9月PC端合计活跃用户数。具体排名方面,百度

    来源 AI 行业观察
  8. 一家8万Star的AI公司,决定让AI接管自己

    10月31日凌晨4点04分,开源项目LobeHub的GitHub页面上,一个名为lobehub-coder的账号,跑到Codex审查机器人提交的代码审查意见下面留言,意思是问题已经修复。 在随后的18分钟里,双方来回交流了好几轮,lobehub-coder先修复了Codex两天前指出的两个问题。紧接着Codex又提出三

    来源 AI 行业观察
  9. 百度首次发布物理AI世界模型Apollo World,萝卜快跑近百辆无人车搭载新架构运营

    11月3日,在深圳举行的百度AI Day·Apollo专场上,百度首次披露面向物理AI的世界模型Apollo World。百度智能驾驶事业群组首席架构师王亮表示,目前约百辆萝卜快跑无人车已搭载新一代端到端架构参与运营,累计全无人运营安全里程接近百万公里。 新一代架构采用端到端模型,从驾驶数据中直接学习驾驶策略,预测转向

    来源 AI 开发者社区
  10. MLCommons上线Candela:Safety 1.2.1与Jailbreak 1.1可按需跑测

    MLCommons近日发布AILuminate Safety 1.2.1和Jailbreak 1.1两项基准,开发者可通过Candela服务自测AI系统产生有害内容的风险及抗攻击能力。基准由80多家机构共识构建,覆盖12类危害场景,并采用确定性评估器提升准确性。公开结果显示27个系统表现差异显著,开放权重模型从第4到9

    来源 AI 科技快讯
  11. 苹果智能国行版实测:图像消除与相册搜索表现如何

    至于搜索就更简单了,AI会直接调用百度的视觉模型,然后通过百度的以图搜图来给你找出类似物品出现过的网页内容,个人觉得聊胜于无吧,在没有接入淘宝、京东等购物类app的情况下,它并没有太多的用武之地,毕竟如果只…

    来源 搜狐科技
  12. 中国科大周少华团队开源RNA模型structRFM,登Nature

    IT之家 11 月 5 日消息,中国科学技术大学(中国科大)今日官宣,该校医学影像智能与机器人(MIRACLE)实验室周少华教授、熊鹏特任研究员团队发布一款开源 RNA 序列基础模型 structRFM,提高了模型在 RNA 结构预测与功能推断一系列下游任务中的性能,有望助力人工智能驱动的科学研究、生物学机制理解、药物

    来源 AI 行业观察
  13. Box联合英伟达推智能体检索系统:速度提4倍,token降90%

    企业内容管理平台 Box 推出了一套采用“智能体优先”思路的内容检索系统,其核心基于英伟达 Nemotron 开源模型。据称,新系统响应查询的速度提升至原来的四倍,错误率降低 20%,而消耗的 token 数量减少 90%。这标志着企业搜索正从“检索增强生成”的单轮问答,转向由模型自主规划、多步执行任务的智能体检索架构

    来源 AI 科技快讯
  14. MiniMax H3被英伟达、Pika采用:估值160亿美元的fal也拿它做底座

    最近最火的风口,非AI视频莫属。 11月3日,专注生成式媒体推理的fal宣布完成最新一轮融资,估值达到160亿美元,较今年4月翻倍,由顶级VC Bessemer领投,英伟达作为战略投资方参与跟投。在Bessemer 的对外分享中,出现了一个中国开源模型的名字。 fal基于中国开源模型MiniMax H3打造的H3 Ma

    来源 AI 行业观察
向下滚动自动加载更多