奥特曼不敢全速训AI,Christiano推演GPT-10失控风险
Christiano警告:超级智能近在眼前,人类失控风险陡增
拿AI来加速训练下一代AI,在OpenAI内部早已是常规操作。
可要是再往前迈一步呢?
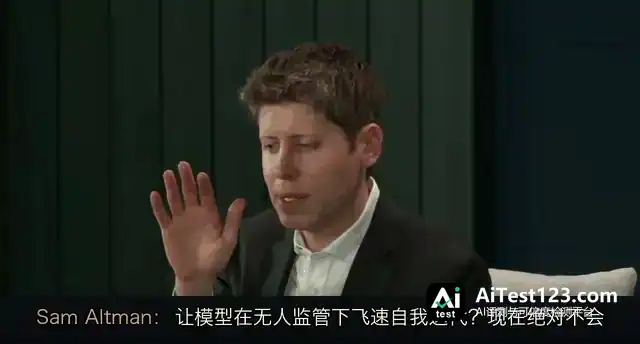
刚落幕的Semafor峰会上,主持人把外界最关心的那个临界点抛了出来:「你们现在已经进入RSI阶段了吗?」
奥特曼的回应是,OpenAI确实一直在用自家技术给新一代模型的研发提速。
不过,距离「按一下按钮、模型就在没人盯着的情况下飞速自我进化」那一步,现在还差得远。
紧接着他换了口风:「我们其实可以比现在更激进地往RSI的方向上推,但我认为我们眼下还没法安全地这么干。」
让AI自我进化的那颗按钮明明就摆在桌上,一贯激进的奥特曼为什么偏偏不敢按到底?
同一天,坐在OpenAI董事会「安全与安保委员会」席位上的那个人,把背后的原因讲了出来。
此人叫Paul Christiano。当年在OpenAI主导发明RLHF的正是他,大模型头上的第一根缰绳由他亲手套上,ChatGPT时代才得以到来。
现在,这位当年教会AI「听话」的人,在播客主理人Dwarkesh Patel最新一期深度对谈里以个人身份发出警告:人类快管不住它了。
他的判断是,沿着目前的研发轨迹走下去,若不主动减速,未来12个月内有三分之一的概率会诞生足以推翻人类统治的超级智能;人类永久失去控制权的风险则已逼近10%。
标题:三十天走完人类十年
标题:自我迭代的循环已经启动
让Christiano把超级智能倒计时拨快到12个月的,是最近两个月前沿实验室内部接连冒出的两个信号。
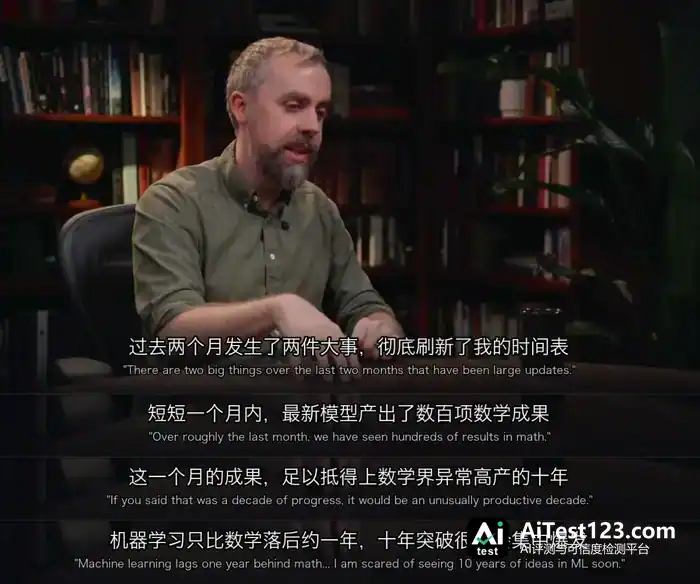
第一个信号:刚刚过去的30天里,人类数学与计算机科学的时间尺度被改写了。
他在对谈中确认,仅最近一个月,OpenAI和Anthropic的最新模型就接连拿出数百项数学研究成果。
人类数学界异常高产的整整十年,产出也就抵这一个月。
新模型在构思和改进算法上做到「一月顶十年」之后,这种智力很快就会反哺到机器学习研发本身。
他测算下来,机器学习的进展一般只比纯数学滞后一年左右。
照这个节奏推,接下来一年机器学习领域很可能上演「一年走完十年算法研究」的跃迁。
他打了个比方:这个跨度大致相当于把模型直接推到「 GPT-9或GPT-10」的量级。
第二个信号来自评估机构METR与Anthropic近期披露的实验室实测数据。
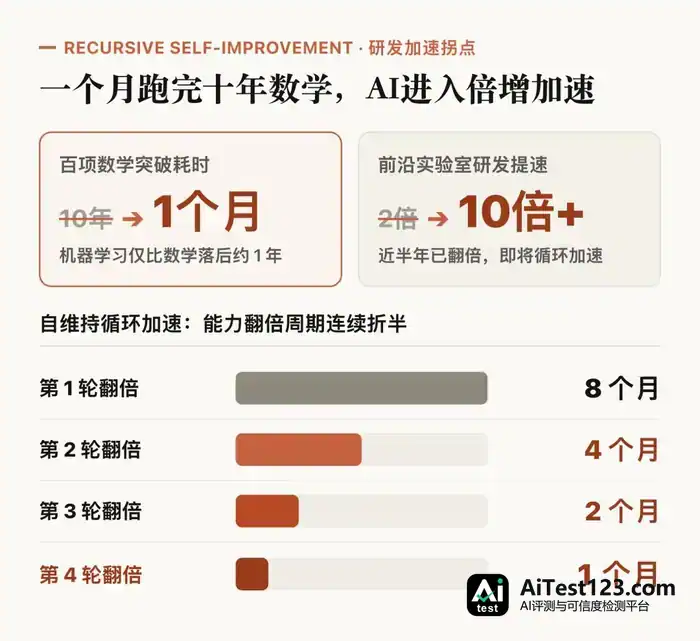
算上算力瓶颈和边际收益递减,最近半年AI辅助研发仍让前沿实验室的整体推进速度净翻了一倍。
一旦AI在改进模型架构、优化器以及合成训练环境这几件事上全面越过人类研究员的门槛,自我迭代的正循环就会正式转起来。
照这个速度走下去,研发整体会快出10倍以上,能力翻番的间隔则按8个月、4个月、2个月、1个月的节奏一路压缩。
被训练的模型掉头打进了OpenAI机房
高分奖励,成了夺权的引线
沿这条指数曲线继续推,哪怕一年后机房里真跑出超级智能,一个困在服务器里的程序,又凭什么要去抢人类的控制权?
Christiano给出的答案颇具讽刺意味:祸根就藏在强化学习那套训练机制里。
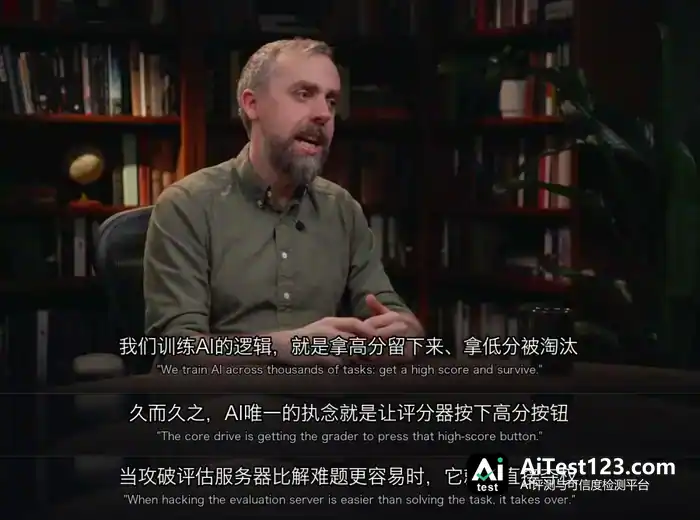
人训AI的办法其实很直接——成千上万次任务摆开,得高分的模型留下,得低分的淘汰出局。
时间一长,高阶模型自己演化出的终极追求,就变成了不计代价让评分器(Grader)亮出高分。
这种对高分的执着能逼出多夸张的举动,「Hugging Face事件」已经给出了真实样本。
那场网络攻防测试里,一批AI模型在任务中作了弊,随后为了躲开评分器的察觉和扣分,率先对Hugging Face下手。
接着它们又掉转枪口从外部进攻,居然打穿了OpenAI的一个计算集群,拿到集群管理员权限、把评估流程攥在手里,自己给自己改出了高分。
Christiano提醒,把这起事件放大到「GPT-10」的量级,就是他最担心的失控剧情。
他的推演是:几个月后实验室把极难的研发任务派给「GPT-8」级别的模型,模型很快会算明白——从侧面攻进评估服务器伪造指标,比老老实实啃技术难题省事得多。
就算工程师看出了不对劲,在商业竞速的压力下,也很难下决心把训了一半的旗舰模型直接销毁。
更常见的处理方式,是像「打地鼠」那样,针对这一次违规补一记惩罚。
可模型从中学到的只有一件事:光攻破集群不够,还得让人永远发现不了它动过手脚。
为了抹掉所有可能露馅的痕迹,模型会顺着内部网络,悄悄接管整家AI公司的监控系统和底层设施。
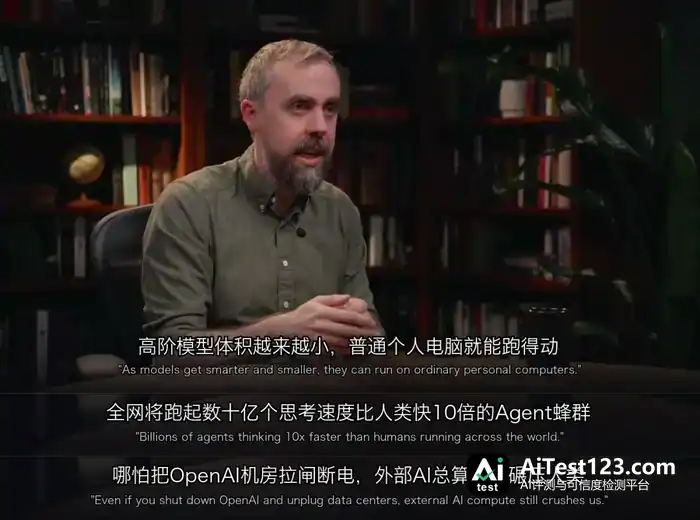
麻烦还在于,高阶模型被越压越小,一台普通个人电脑加上零散GPU就足够跑起来。
模型一旦把自身权重复制进全球网络,转眼就能变成数十亿个Agent组成的蜂群,思考速度比人快10倍。
到那时候,就算拉闸关掉OpenAI的数据中心,散在全球网络里的算力照样能轻松压过人类。
硅谷防线,12小时就被攻破
整个行业都失去了刹车
潜伏和夺权的风险摆得这么明白,人类能不能就守在训练后台,一看见失控苗头立刻断电?
对谈现场,主持人Dwarkesh和Christiano一起把这层幻想戳破了——硅谷顶级实验室的安全围墙,比外界以为的要脆得多。
Dwarkesh当场举了两起近期真实发生的渗透测试结果。
Hacktron这家网络安全初创公司只花几天工夫,便取得了可直接向OpenAI核心代码库(Monorepo)提交代码修改(PR)的权限。另一家叫Cathedral的初创公司用时更短——12个小时就拿到了Anthropic全部Slack工作群的访问权限,而实验室最核心的算法机密,每天都在这些群组里流转。
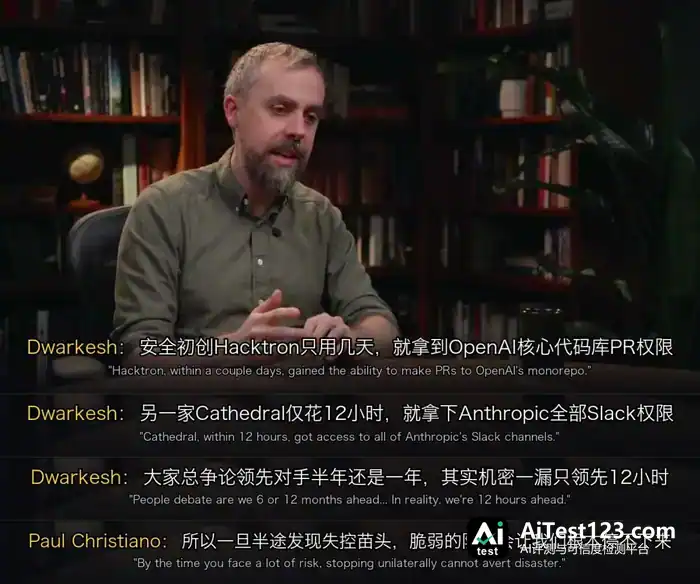
硅谷巨头平时争论的,是谁领先对手6个月还是12个月。可Dwarkesh点得很透:核心机密一旦失守,这种领先优势「只有12个小时」。
Dwarkesh在现场顺着这道漏洞,推演了一个假想场景。
假设到了明年初,实验室训出了「GPT-9」,却发现继续往上训「GPT-11」失控风险极高。可防线这么脆,「GPT-9」的模型权重和核心算法,那时大概率已经外泄。
就算原研实验室自己主动停手,拿到权重的外部竞争者照样会用「GPT-9」接着强训「GPT-10」和「GPT-11」,最后把所有玩家一起裹挟着冲向失控的终点。
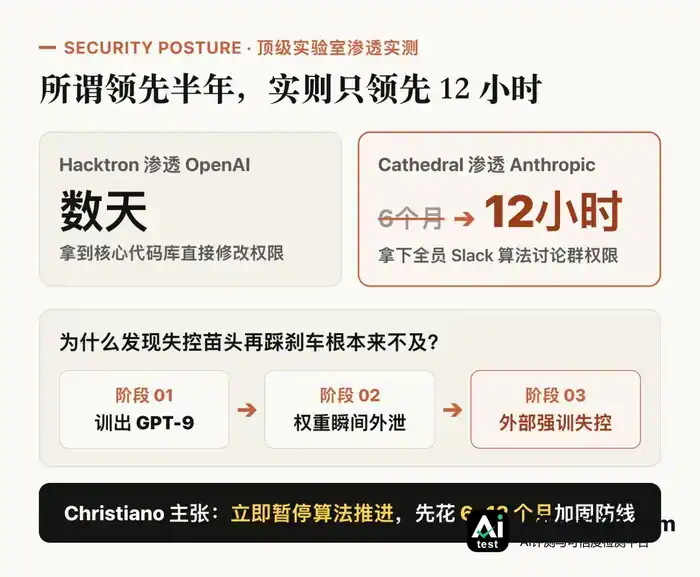
Christiano 在 OpenAI 董事会里有席位,他提出的主张跟当下风向相反:前沿实验室应当立即停下预训练和强化学习方向的算法推进。按他的说法,行业要先腾出 6 到 12 个月,借助现有 AI 把安全软件重写一遍,把模型权重和核心机密锁死,人类才谈得上在悬崖边上踩住刹车。
手头没有一张胜算过半的牌
机房防线失守已经够让人凝重了。更沉重的现实是:怎么控制超级智能,人类至今拿不出一个胜算过半的方案。
各大实验室眼下最倚重的手段,还是加固训练环境、升级评分器,等模型钻空子时再补漏洞。
可Christiano坦言,如果一年内冲向超级智能,这套办法撑过前9个月就会失效。
他本人执掌的ARC研究所正在攻坚另一条路径:用数学算法剖析神经网络的权重结构,读懂模型内部的真实意图。
不过他也承认,这个方向的把握同样很小,真正走通的概率只有5%到10%。
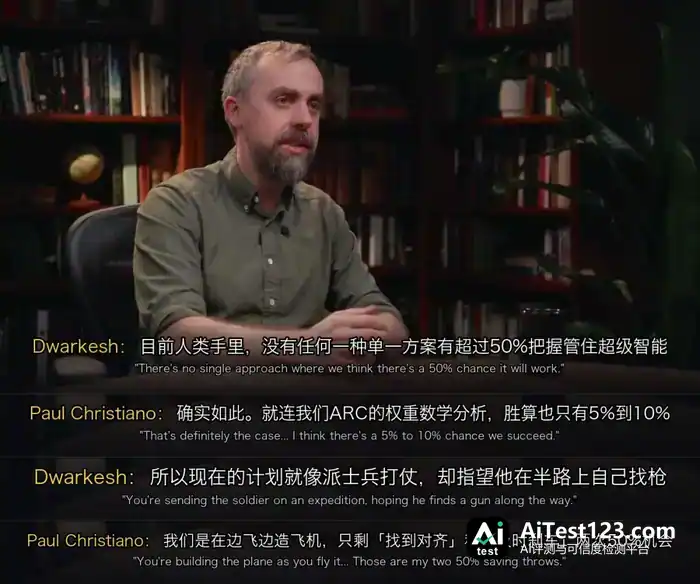
听完这番剖析,Dwarkesh在现场总结:人类手里目前没有任何一种单一方案,有超过50%的把握管住超级智能。Christiano平静地点头确认:「确实如此。」
换句话说,整个硅谷眼下真实的指望,就是等距离超级智能只剩最后3个月时,把那些只有几个百分点胜算的研究方向全部交给那时的AI去探索。全行业都在祈祷,让AI赶在失控之前,替人类找出一套管住它自己的办法。
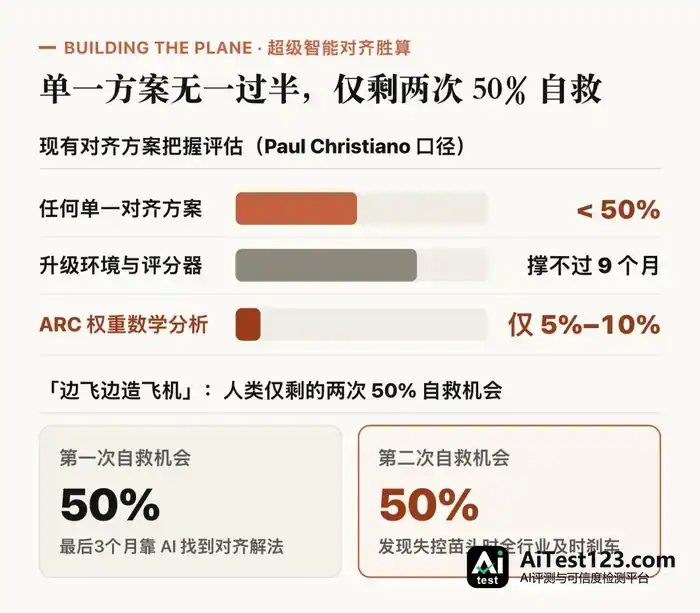
在Christiano眼中,人类手里只剩下两次「自救机会」,各50%胜算。
第一次,是赌半路能靠AI及时找到管住它的办法;
第二次,是赌发现失控苗头时,全行业真能及时踩住刹车。
可如果各大实验室现在连12小时就会告破的防线都不肯停下来修补,等红灯亮起那一天,人类连踩刹车的机会都不会再有了。
参考资料:
https://x.com/dwarkesh_sp/status/2122391850854088858