DeepSeek宕机5小时后发布4.1 flash 1017,实测表现如何?
主要能考察到模型的这几项能力:编码能力、端到端智能体能力、以及基础视觉和视觉推理能力。
前阵子 DeepSeek瘫了将近5个小时,热搜上挂了好一阵。
AI圈不少模型似乎都有个习惯:一更新就先崩。昨天17号DeepSeek果然发了个新模型4.1 flash 1017,我一开始还犯嘀咕,4.1 flash不是早发过了吗?
宕机5个小时,就憋出这么个东西?细看才明白,版本号后面缀着1017,这是款新模型。
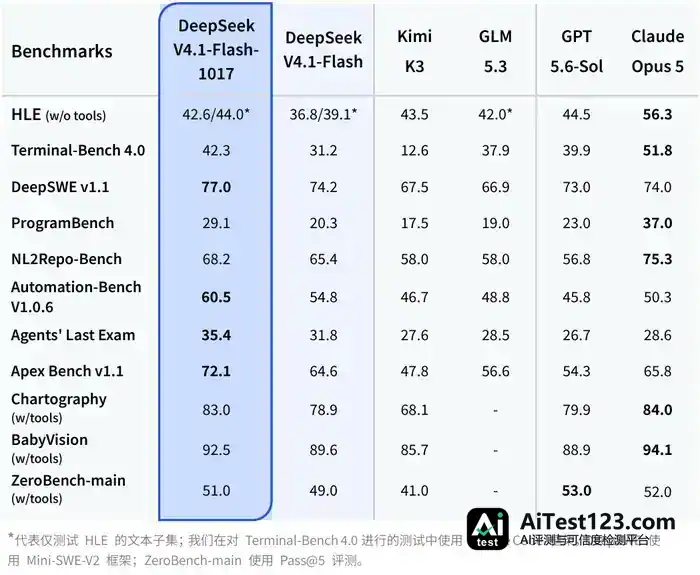
本以为连版本号都懒得换新,升级幅度肯定有限,结果我错了。官方公布的测试结果显示,跟上个版本比,这次是全面提升。
核心亮点在于:从0到1构建完整编程任务、以及复杂自动化任务的能力。说白了就是编程和自动化这两块,要是还没概念也不要紧,下面我按模块做案例实操,看起来更直观。
几乎所有能力都压过了GPT-5.6 Sol,部分项目上甚至超过了Opus5。
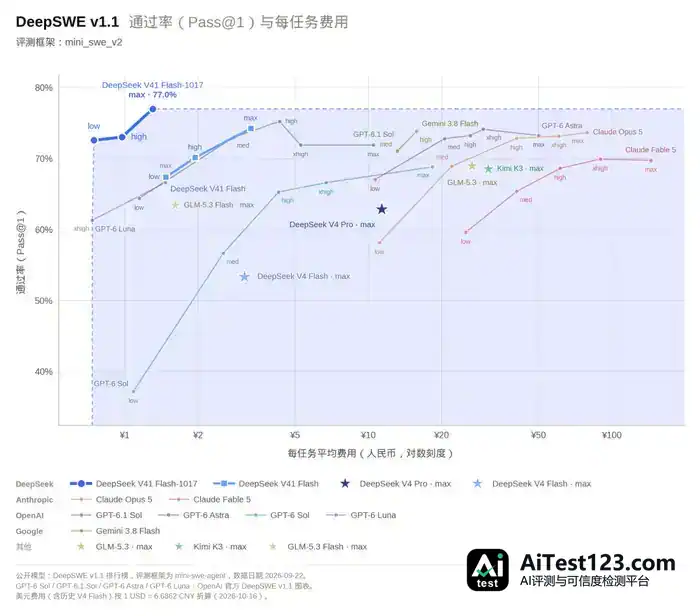
成本这块只能说低得夸张。官方测试结果是,多个Harness的同任务对比实测中,代号1017的通过率比上个版本更高,花的钱反而更少。看图左上角那块,1017的max费用跟V4.1 Flash的low成本差不多,实在离谱。
能力往上走,费用往下掉。
官方说得漂亮,社区声音也有分歧,究竟如何还得自己上手测。
我挑了几项提升最明显的能力集中测:编程任务、自动化任务,还有视觉效果。测试中主要拿DeepSeek V4.1 Flash 1017跟GPT-6 Sol对比,后者是我常用的模型。
01
做特斯拉飞车的原理解读。1017和GPT-6 Sol都能靠编码生成视频,用编码生成视频是个综合性挺强的工程,能考察模型的多项能力。
主要看这几项:编码能力、端到端智能体能力,以及基础视觉和视觉推理能力。
先看DeepSeek V4.1 Flash 1017做的(用时48分钟,成本是2.9元)。
再看GPT-6 Sol的效果(用时7分钟,成本是7.8元)。
两个都做完,我的整体感受是GPT-6 Sol的效果更简单易懂,画面也更简洁;1017做的相对复杂,小白看起来会有点晦涩难懂。
接着让DeepSeek和GPT-6 Sol分别跑一个关于V4.1 Flash 1017的介绍。这个任务我觉得DeepSeek自己做得更好一些,GPT-6 Sol有不少细节没遵循指令。可能还是DeepSeek更了解自己一些(🐶)。
下面这份是DeepSeek跑出来的,花了28分钟,成本1.9元。
这份则是GPT-6 Sol的成果,3分钟搞定,成本5.6元。
02
接下来是复刻特斯拉飞车,还有建模环节。
1017这一版有个关键升级,就是终端里的端到端智能体能力。有了它,模型能按需调用电脑上的各种工具,用得还比较顺。
于是让两边都去调Blunder做3D效果,输入的是同一段特斯拉飞车原视频。
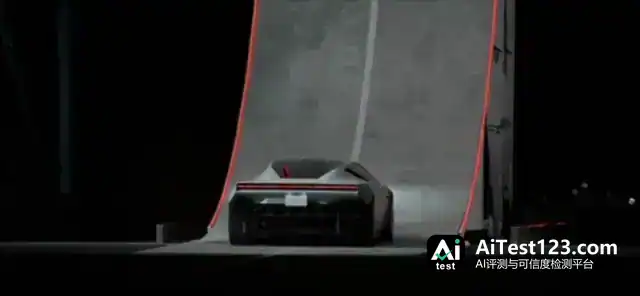
先看DeepSeek V4.1 Flash 1017的版本,1小时跑完,成本1.97元。
GPT-6 Sol这边用了27分钟,成本21元。
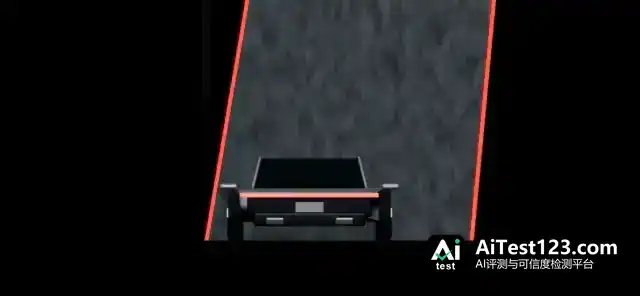
复现效果上,GPT整体还过得去。DeepSeek就有点拉垮,车最后直接在空中飞来飞去,看得人有点懵。
速度与成本摆在一起对比:GPT 27分钟、21元;DeepSeek 1小时、1.97元。价格差得确实有点大。
可任务没执行好,成本再低也白搭。这个问题以后能不能解决,只能再看。
接着换成用three.js做北京天坛的3D网页。
DeepSeek的北京天坛,1小时,2.54元。
GPT-6 Sol的北京天坛,9分钟,6.9元。
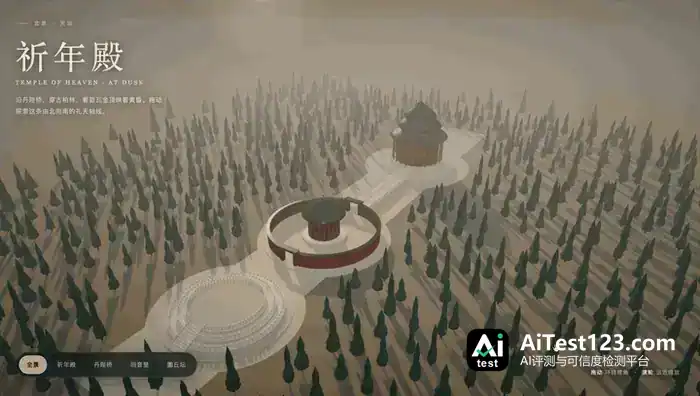
指令遵循这块两边都OK。要说个人喜好,我更偏向DeepSeek那版,建模精细度明显更高。
做到这里(另外还跑了些案例,部分没放出来),我的感受是DeepSeek理解视频和图片的能力偏弱。所以一旦喂视频让它复刻,结果就不太理想。
03
再往下是复刻我的世界和植物大战僵尸。
游戏这类任务对能力要求比较综合,编码、视觉都得过硬,所以对比模型能力时基本都会拿游戏来跑。
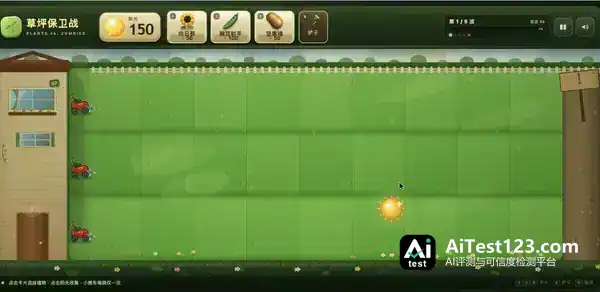
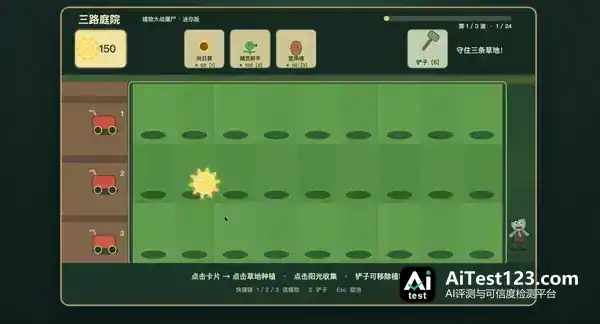
植物大战僵尸之前已经用不少模型试过,这回轮到1017和GPT-6 Sol上场。
两边的指令要求基本都落地了。视觉效果上我觉得DeepSeek比GPT-6 Sol顺眼一些,离谱的是这波DeepSeek反倒比GPT贵。
先看DeepSeek V4.1 Flash 1017的,19分钟,成本1元。
GPT-6 Sol这边5分钟,0.5元。
我的世界也看一下。两者实现程度都没问题,但纹理和细节上我认为DeepSeek做得更好。
DeepSeek的成绩是38分钟、2.2元。
GPT那边跑完花了12分钟,成本4.2元。
整体对比下来,效果跟GPT-6 Sol放在一起看,还是挺让人意外的。有些任务上毛病很明显,可大多数时候执行得不错。
钱是省下来了。简单任务上,成本差距不算突出;任务一复杂,差别就拉开了。这或许跟缓存命中率有关,我们跑的这几个任务里,DeepSeek的缓存命中率明显高于GPT。
麻烦的地方只有一个:等得久。
所以,不赶时间的活,交给1017去跑没什么问题。视觉理解这一类,眼下先别给DeepSeek;其他场景只要算成本,用DeepSeek是很划算的。
这次更新版本时,DeepSeek还特意提了个“许愿式编程一键成真”,意思是用简单的提示词就能拿到不错的结果。
实际比下来,确实如此。
社区里现在还有不少人在争,说1017是蒸馏了Astra。整个测试过程中,我没太感觉到这一点。
用过的人不妨来说说。