无界方舟Edge0-145B实测:端侧模型编程能力比肩云端
千亿模型装进电脑,端侧不再做平替。
端侧 AI 在很长一段时间里,都像是云端智能打了折扣的版本。
要装进耳机、手机、电脑,模型就得在能力和资源间权衡:参数压小,占用降下来,聪明程度也跟着降,能做的事自然变少。功耗、内存、时延,谈端侧 AI 总绕不开这几项。于是形成了一种常见分工:简单的日常交互放本地,复杂任务交给云端。
可那个最让人心动的设想——数据全留在本地、模型随便调用、每轮推理不用付费——一直没能兑现。
无界方舟眼下正试图改写这一局面,拿出了新的破题思路,并自称「高智力端侧AI的开创者」。
其最新推出的 Edge0-145B,定位已不是给云端「打配合」,而是冲着替代云端大模型去的。
11 月 13 日,无界方舟发布新一代模型 Edge0-145B、Edge0-120B,同时开放模型权重与配套推理框架。145B 的模型激活参数约 10B,目标是在一台高配个人电脑上,干完过去要靠云端模型才能完成的复杂工作。
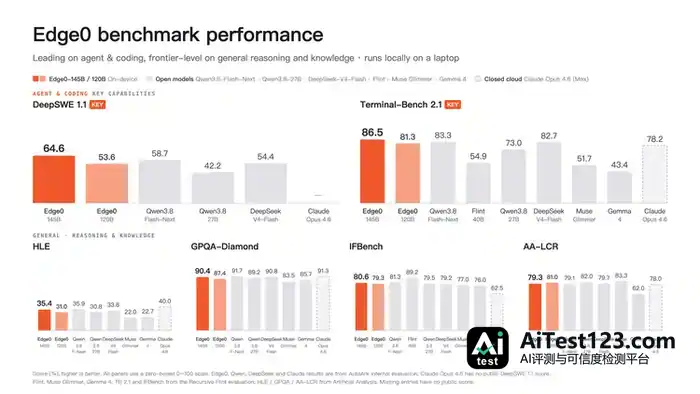
从无界方舟公布的评测数据看,起码在智能体编程这一项上,Edge0-145B 已经和云端模型平起平坐。
在 DeepSWE 1.1 上,Edge0-145B 拿到 64.6 分,Terminal-Bench 2.1 上拿到 86.5 分,两项都高于  DeepSeek-V4-Flash-0731 的 54.4 和 82.7。
官方放出的测试案例也印证了这一点。三维建模、游戏开发、PCB 设计、无人机程序、视频制作……这些都是以往云端大模型评测中的常见任务。
拿一个 3D 建模任务来说,无界方舟把同一份需求同时交给三个 AI:GPT-6 Astra、Claude Opus 4.8,以及自家的 Edge0-145B。提示词一样、参考图一样、镜头路线也一样,各自搭一座中世纪湖畔城堡,再交出一段飞越镜头。
看结果,三者完成度相差不大,肉眼很难分出高下。这个任务上,端侧模型并没有落后。
另一个 PCB 设计任务,则把话题推进到专业工作层面。模型得同时弄懂两类软件:先在 KiCad 里做完元件布局和双层走线,再把设计导入虚幻引擎 5,调好镜头和灯光,产出制造与组装过程的动画。
放在过去,这要硬件工程师和三维设计师接力干上好几天;如今一台电脑就能独立交付。原理图、版图这些硬件企业最核心的资产,全程不用上传云端,商业机密和数据合规都有了保障。
端侧模型比了这么多年「能不能跑」,现在开始比「聪不聪明」了。
今年 9 月,无界方舟已开源 Edge0-35B,这是全球首个能在手机上流畅运行的 350 亿参数端侧模型。峰值内存不到 2.5GB,在 iPhone 18 上生成速度超过 37 token/s。海外发布帖当天阅读量突破 120 万,OpenAI、NVIDIA、高通等公司的多位技术专家和研究员参与转发,模型随即登上 Hugging Face 全站 Trending 榜第一。无界方舟当时一并开源了模型权重和统一推理框架,这套做法成了其他端侧企业和研究机构复刻时的标准解法。
35B 百亿参数的端侧模型,意味着高智力端侧 AI 头一回从理论走进产业落地;145B、120B 千亿参数端侧大模型,则意味着端侧智力水平头一回能比肩云端模型。
我们也上手实测了一番。
实测:端侧 Edge0-145B 模型,确实抗打
端侧模型过去做取舍,现实理由很充分。
手机内存要分给系统、相机、浏览器和各类应用;耳机还得顾及电池、体积和散热。模型跑得起来只是第一步,它还得响应快、不发烫、不抢资源。
以往把模型做小、把复杂需求交给云端,就是这些约束下没办法的选择。
可这也堵住了端侧 AI 成为真正生产力的路,没法用到真实工作里。
编程助手要读项目、改代码、跑程序、看报错,再接着改;三维助手要理解需求、操作软件、检查渲染;办公助手要按主题做出一份能直接用的 PPT。这些活值钱的地方不在某一步推理,而在从头到尾做完、交出可用的结果。
端侧如果只能接住最轻的一小段,主要工作还是得送回云端。
成本是头一个受影响的环节。靠云端API的产品,推理费得一直掏;任务一复杂,工具调用、错误修复、反复修改把链路拉长,账单也跟着往上走。把更多计算留在用户设备上,云端支出就能压下来。拿一名做Vibe Coding的开发者来说,每天8小时大约消耗1,000万token,按每月22个工作日算,一年能省5-10万元。B端企业那边,云端token成本每年从数百万到几十亿不等,端侧AI可以把成本砍掉90%以上。
数据隐私排在第二。模型一旦开始读内部代码、工程图纸、合同和财报,资料在哪儿处理、哪些服务能碰,直接决定产品进不进得了工作流程。端侧AI的办法是让更多处理发生在设备里,隐私合规的要求也就满足了。
不过,要把这两项优势带进更复杂的工作,本地模型就得在有限的硬件资源下拿出更高的智能。
Edge0-145B的亮点正在这里。
设备门槛上,Edge0-145B最低能在配12GB显存、20GB系统内存的PC上跑,配备48GB统一内存的Mac也支持。
功耗方面,在搭载RTX Spark的笔记本电脑上运行Edge0-145B,整机功耗为80W。对于要连续调用工具、反复修改的任务,这意味着设备能一直维持工作状态,不会出现模型开头跑得顺、后面因发热明显降速的情况。
速度上,Edge0-145B的预填充速度为1,100+ token/s,解码速度为80+ token/s。前者是处理输入材料的速度,后者是生成新内容的速度,两段都够快,多轮任务才不至于把大量时间花在等待上。
另外,Edge0-145B支持128K–256K上下文,长文本下速度基本不衰减,跑长时间的复杂任务也不会越跑越慢。
它的智能表现,我们通过三个案例做了实测,全程没有手动改代码或交付文件,都由模型自己推进。
测试一:3D 建模
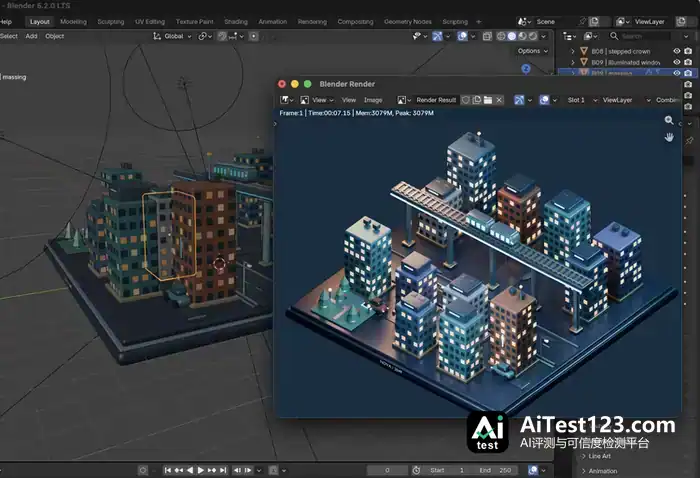
请帮我在 Blender 里做一座微缩的未来城市,场景是雨后黄昏,看起来要像摆在桌面上的精致模型。整座城市放在方形底座上,大约 12 栋建筑高矮错落,还要有一条高架轨道从城中穿过,配一个小公园和几辆车。楼体的窗户透出暖光,局部点缀青蓝色霓虹,地面要带雨后的反光。风格走有设计感的低多边形,建筑的轮廓和街区之间的位置关系得清楚。建模、材质、灯光、相机都由你安排。先渲一版看效果,再照着结果调一轮,重点看建筑有没有互相穿插、画面是不是太暗、主体有没有被挡住。最后给我能继续编辑的 .blend 文件,外加两张渲染图:一张城市全景,一张街区近景。
模型按提示词把流程跑完了,初次建模与渲染之后,又接着做了检查和调整,最终交回一份可编辑的.blend文件。用户打开后能改布局、改材质、换镜头,接着往下创作。
测试二:游戏制作
提示词:Make a 3D game with Three.js in a single index.html I can open in my browser.Use the arrow keys to roll a ball across a floating obstacle course. Collect gems for points, cross narrow bridges and ramps, and avoid moving blocks. Press Space to jump. Falling off returns the ball to the last checkpoint without losing points.Use colorful scenery, soft lighting, responsive controls, and a smooth follow camera. Each round lasts 60 seconds. Show the score and timer, and include a start screen, final score screen, and restart button.Build all objects procedurally. Run and test the game, fixing any issues before delivering the file.
第二个任务是用Three.js做一个3D游戏:方向键控制小球滚过悬浮赛道,一路收集宝石,跨过窄桥和坡道,躲开移动的方块,跳跃、检查点、计时、重新开始这些也都要有。
它交回了一个index.html,浏览器打开就能流畅地玩。地形、宝石、桥和移动方块全由程序生成,没有用现成的场景素材。
测试三:PPT 制作
请做一套 6 页的中文 PPT,主题是“一家开到深夜的社区书店咖啡馆”,用途是向潜在合伙人介绍这个项目。页面上要覆盖项目概念、目标顾客、空间与体验、产品与活动、收入来源、开业计划这几块内容。项目名字你自己定,资料我已经发你了。视觉上要有独立杂志那种质感,主色用奶油白和深绿色,再点缀一点暖橙色,配合大标题、空间示意图和适量的图片。每页得有明确的视觉重点,文字别堆太多,版式也不要连着几页一个样。PPT 直接做完交给我,给可编辑的 .pptx 文件和整套页面的预览图。做完之后查一遍文字有没有溢出、元素有没有重叠、图片显示是否正常。
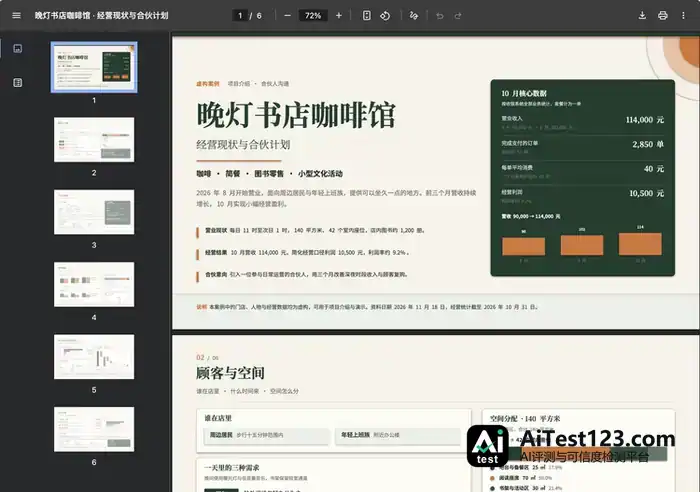
第三个任务离日常办公更近。这个过程里,模型还做了大量细节检查,照着我们给的资料逐项修正,最后输出的结果基本没有错漏。
为了让硬件带得动,他们重构了模型
无界方舟选的是提高端侧智能这条路,但硬件约束不会消失。目前的效果,来自他们把硬件约束提前纳进了模型结构与训练设计。
整体上,模型架构的调整可以从四步设计来理解。
头一步是动专家层,把需要存下来、搬来搬去的权重压下去。
混合专家模型每处理一个 token,只挑少数专家参与运算。可算得少,不代表存得少。没被选中的专家,参数照样得留在设备上,要用了还得及时读出来。
Edge0-145B 再往前走一步,用了分组共享的做法。64 个专家共用两段大矩阵,各自只留一点有差异的专家参数。专家个数没减,需要分开存的权重却少了。
稀疏调用让每一步参与计算的专家变少,共享结构让专家各自要存、要搬的数据变少。两边各管一段,合起来把设备的运行负担降了下来。
第二步,是让模型适应新结构和低精度条件。
再往下,权重还能以更低的精度存放,每个参数占的地儿更小。可结构一动、精度一降,模型本事就容易掉。
公开模型卡显示,无界方舟改完专家层后做了较长时间的后训练,训练时就把 4 比特运行条件考虑进去,让模型适应部署时的结构和精度,接着学编程、推理、调工具。
这一步要守住的,是省了资源之后的任务能力。模型占得再少,要是老出错、用户得不停接手,复杂活儿还是交不出去。
第三步,让显存、系统内存和 SSD 各管一摊。
结构和精度调完,整个模型还是不小。接下来要定的是:哪些数据放在最快的地方,哪些可以要用再读。
显存快,可容量有限。公开方案里,调用频繁的“热专家”尽量常驻显存,剩下的专家交给系统内存;体积大的 PLE 嵌入表放在 SSD 上,按需读取。嵌入表可以粗略理解成模型用的一类大型查表数据。
这些数据照样占地方,但不用全挤进显存。显存、系统内存、SSD 各扛一部分,设备才有可能装下完整模型。
第四步,把读取和计算排得更紧凑。
分开存放解决了容量怎么分,也带出新麻烦:等。每一步都先把数据搬过来再算,生成速度还是被传输拖着。
在 NVIDIA 显卡的部署方案里,配套引擎让 GPU 算已经驻留显存的专家,CPU 分担一部分没驻留的专家计算,同时协调数据传输,让各部分尽量并行,少互相干等。
另一边,投机解码先抛出多个候选 token,再交主模型验证。一轮验证要是能接下多个候选,部分读取和计算开销就摊到了更多输出上。
这样一来,前面在结构、精度、存储上做的调整,才能一步步变成用户能感觉到的生成速度。
端侧原生的意思就在这里:模型怎么组织参数、以什么精度跑、参数怎么读,都得围着硬件设备的条件来定。
让每种硬件都拥有自己的最佳智能
Edge0-145B 亮出了无界方舟一路抬高端侧智能上限的方向。不过要看明白这家公司的路线,眼光还得从个人电脑挪到更多设备上。
手机、电脑、眼镜、耳机,硬件配置条件各不相同,需求也不一样。电脑内存更大、散热空间更足,能扛编程、三维创作这类 Vibe Coding 工作;耳机、眼镜更在意低功耗和及时响应;手机则要兼顾复杂智能体任务和其他应用。
要把端侧智能提上去,就得给这些差异分别配上合适的模型和运行方式。
过去一年,无界方舟已经搭起四个模型家族:Audio8 管听说交互,Decision0 管快速决策,Edge0 扛复杂推理和智能体任务,Embedding0 支撑记忆与检索,参数规模从千万级一路铺到千亿级。
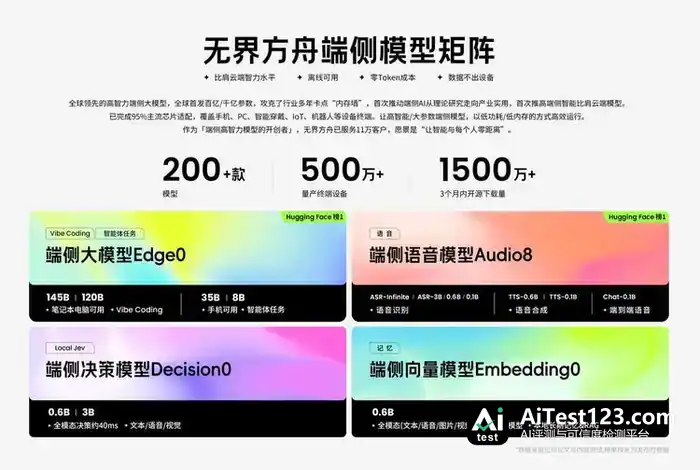
装进不同设备,组合也不一样。耳机讲的是“听得清、回得快”,可以配上管听说交互的 Audio8 和管快速决策的 Decision0;手机和个人电脑要更复杂的任务能力,就由不同规模的 Edge0 来接——35B 面向手机等设备,120B、145B 则进一步承担电脑上的项目理解、软件调用和连续排错。
说白了,这条路线的想法很直接:设备能扛住多少资源,就把智能做到多高,让它在自己的地盘上把更复杂的活干完。所以除了模型本身,推理框架和芯片适配同样是硬骨头。
同一套模型换到不同硬件上,算力、带宽、精度支持、散热都要重新捋一遍,还得跟系统里别的软件抢资源。Edge0 家族眼下已经适配了 95% 的主流芯片平台,高通、恒玄、瑞芯微、全志、地瓜、英伟达都在名单里;产业合作则铺到了耳机、眼镜、手机、PC、机器人等终端。
每适配一颗新芯片、每部署一个模型、每落地一款产品,都会攒下能复用的经验。下次再进新硬件,判断就能快一些——这款产品扛得住什么任务,模型和引擎还要往哪儿调。整个过程一直在迭代。
如今,这个迭代过程已经转成了飞轮。
数据能说明问题:无界方舟的开源模型三个月下载量超过 1500 万次,多次登上 Hugging Face 趋势总榜第一;到 2026 年 10 月,企业客户已突破 11 万家。
开发者能把模型搬进自己的环境,看它跟现有软件怎么配合,不同配置下的表现也有机会被外部检验。
商业落地要回答的问题更具体:端侧到底接住了多少需求?无界方舟披露的一项耳机端云协同案例里,约 92% 的 AI 使用由端侧承担,剩下的交给云端。
新发布的 Edge0-145B 把目光进一步投向个人电脑。端侧 AI 的下半场,大概率会出现在那些用户过去必须为云端智能掏钱的工作里。
无界方舟已经拉开了高智力端侧 AI 的序幕。
想体验无界方舟端侧模型,可点击链接
https://www.autoarkai.com/model-detail/llm-145b