SGLang与Miles跑上Vera Rubin:Kimi K3推理提速与RL训练实测
本文报道SGLang与Miles团队提前获得两台NVIDIA Vera Rubin节点(共8张GPU)的早期访问权限,并在该平台上完成推理与强化学习训练的适配。SGLang针对Kimi K3 NVFP4模型在注意力、MoE通信及KDA核函数上进行了深度调优,MLA流水线加深、融合all-reduce等优化带来最高20%
引言
两台NVIDIA Vera Rubin节点(共8张GPU)的访问权限被我们提前拿到,SGLang与Miles框架随后被迁移到这一平台:推理交给SGLang,强化学习训练交给Miles。面向Kimi K3 NVFP4模型,注意力、MoE通信以及KDA核函数都做了针对性优化。
推理优化:服务Kimi K3 NVFP4
Kimi K3是2.8T参数的混合模型,注意力为93层(69层KDA线性注意力加24层MLA),LatentMoE结构则包含896个专家。服务时我们采用的是RadixArk的DSpark块投机解码。
注意力优化
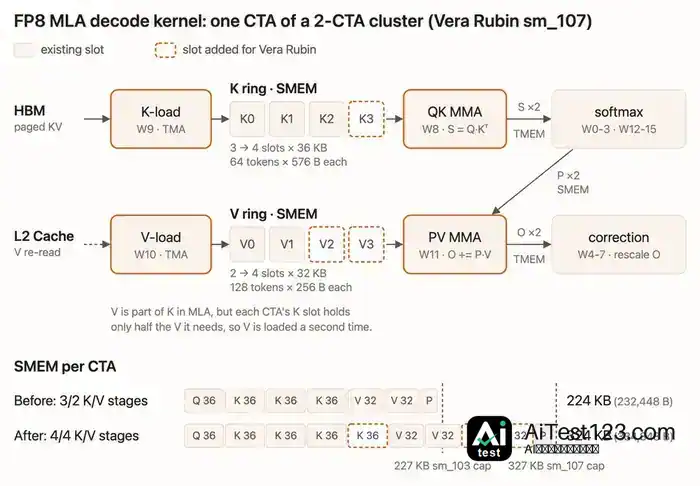
Vera Rubin每CTA有327 KiB共享内存可用,借此MLA流水线从3K+2V阶段被扩展到4K+4V阶段,batch 16、128k上下文的条件下拿到了16%的加速。
split-KV归约、64-way分裂以及原生FP8转换也被一并优化,低并发场景下FP8 MLA性能提高了20%。
MoE与通信核函数
MoE尾部操作做了融合,finalize、all-reduce与RMSNorm被合并成一个集体核函数,276次启动开销就此消除,端到端提升5.9%。push all-reduce阈值同时被调到256行,潜在all-gather GEMM也迁到了tensor core上。
KDA优化
KDA verify核函数经过重构,conv权重留在寄存器里,CTA屏障被去掉,生产核函数加速20%。
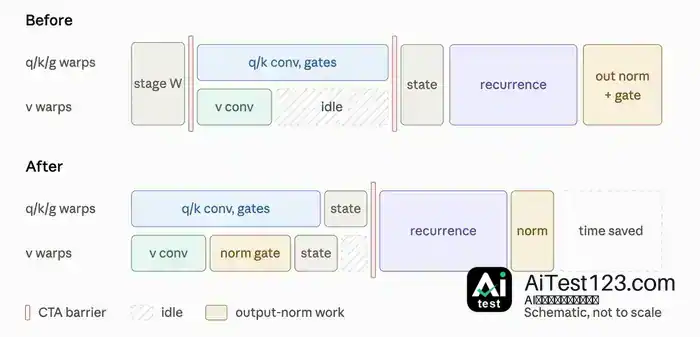
strided gate读取得到支持后,PyTorch的隐式拷贝不再发生,单步解码时间又少了1.8%。
强化学习训练:Miles在Vera Rubin上运行
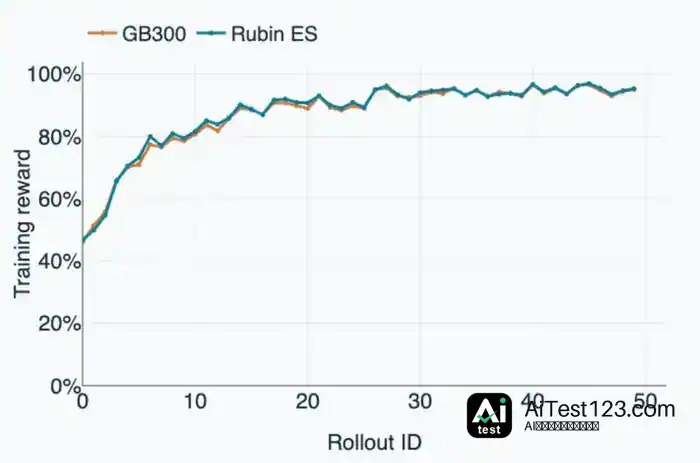
Miles框架的rollout用SGLang,训练用Megatron,单个容器镜像就能在Vera Rubin上跑通端到端RL任务。 Qwen3-30B-A3B在GSM8K上的奖励由45%升到95%,曲线与GB300完全重合。
DeepSeek-V4-Flash FP8路径同样已经打通。
基于Vera CPU的Agentic RL
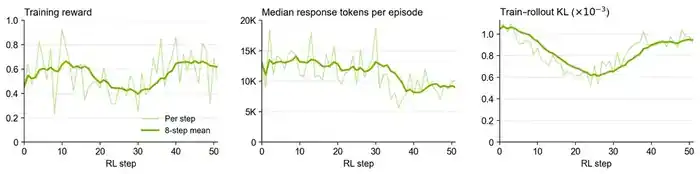
NeMo Gym被用来在Vera CPU上跑mini-SWE-agent环境,64个sandbox并发,SWE-bench Verified任务奖励稳定在0.6附近,响应长度缩了30%。
后续展望
接下来团队会继续扩大推理优化范围,并加强大规模Agentic RL并发环境的支持。