Orange、Docomo接连断网:5G核心网26天4起故障
近一月两家运营商4起全国故障均出在5G核心网
10月21日,法国Orange的全国移动网络出现大面积中断。
11月5日,日本NTT Docomo的5G SA服务全国中断。
11月11日,Docomo的5G SA服务又一次全国中断。
11月16日,Docomo的5G SA服务第三次全国中断。
26天里,两家大型运营商接连出了4起全国性移动网络重大故障,问题都指向同一个关键位置——5G核心网。
Docomo:11天连断三次
Docomo正在加速从5G NSA向SA迁移,想借此改善网络质量、重建用户信任。对这时的它来说,这11天几乎是一场极限压力测试。
11月5日上午11时18分左右,Docomo的5G SA服务发生全国性故障,语音、数据、短信都无法正常使用,最多约158.7万名5G SA用户受影响。故障持续约14小时,直到次日凌晨1时20分左右才恢复。
Docomo最初在公告中给出的原因是:
承载5G SA签约用户的交换设备发生拥塞。
11月6日,Docomo又进一步说明了故障经过:
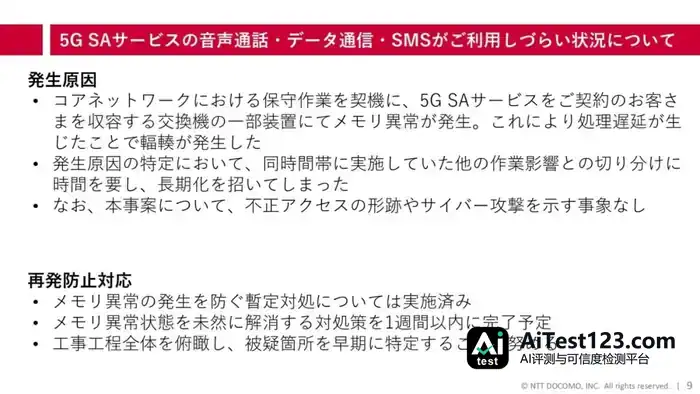
承载5G SA用户的部分交换设备出现内存异常,处理能力下降,响应时延不断增加。
终端长时间收不到网络响应,就开始反复重传。大量重传又进一步推高了核心网的信令负荷,形成近似“信令风暴”的现象。局部设备的异常,就这样被放大成了全国性的5G SA业务中断。
故障为什么持续了14个小时?
Docomo 的说法是,故障出现的时点正好撞上公司在全国推进用户数据库文件更新,两件事时间上叠在了一起。最初排查时,工作人员把怀疑目光投向数据库更新作业,于是多花了些工夫去核查这部分操作。
还有一点,这次出问题的是核心通信系统里的主用系统。也就是说,Docomo 既没法图省事直接重启设备,也不能随便切换到备用系统。等到要恢复业务,还得小心压住大批终端同时重新接入带来的信令洪峰,免得恢复动作本身又招来一轮拥塞。
图源NTT Docomo
故障恢复后,Docomo表示已完成临时措施,并计划在一周内完成防止内存异常再次发生的永久措施。
可第一次故障刚刚落幕,永久措施还挂在“一周内完成”的时间表上,六天后,同一张网络再次中断。
11月11日上午10时34分,Docomo的5G SA服务再次发生全国性故障,直到晚上7时17分才完全恢复,持续约8小时43分钟。受影响的仍是5G SA签约用户,普通5G和4G依然正常。
这一次,Docomo给出的原因与第一次最初的表述基本相同:
承载5G SA签约用户的交换设备发生拥塞。
但Docomo没有进一步说明具体原因,也没有说明是否与第一次的内存异常有关。
这些问题还没有答案,五天后,第三次故障又来了。
11月16日上午10时02分,Docomo的5G SA服务第三次在全国范围内出现故障,直到下午3时58分才完全恢复,前后持续约5小时56分钟。受影响的人群没有变化:5G SA签约用户的语音、数据和短信都受到波及,普通5G和4G用户不受影响。
Docomo这次给出的原因说法是:通信集中到了承载5G SA签约用户的交换设备上。
官方的措辞从“交换设备发生拥塞”改成了“通信集中到交换设备”。可通信为什么会突然集中?三次故障之间有没有关联?Docomo依然没有透露。
稍微积极一点的信息是,三次故障的持续时间一次比一次短:从约14小时,到8小时43分钟,再到5小时56分钟。这或许说明,Docomo在故障定位和恢复上的速度有所提升。
Orange:软件漏洞击穿主备系统
Docomo接连三次出事,也让人想到不到一个月前法国Orange的那次全国性断网。
当地时间10月21日上午11时37分,Orange的网络突然在全国范围内中断,数百万用户没法正常打电话、发短信,也用不了移动数据。服务到下午6时30分至晚上8时30分才陆续恢复。
据法国媒体报道,问题出在Orange的新移动核心网设备上。过去18个月里,Orange一直分批把用户迁入这张新核心网,每批大约10万用户。这次受影响的是已经迁入新核心网的部分4G和5G用户,还留在旧核心网上的用户则没有受到影响。
事故正好发生在用户迁移期间,外界一度猜测是核心网割接失败。Orange随后否认了这一说法,称真正原因是:诺基亚新移动核心网设备中的一个软件漏洞引发了连锁故障,还把备用系统一起拖垮了。
Orange负责人表示,这次事故极为罕见,十四年来从未碰到过类似事件,复杂度也是前所未有的,因此花了很长时间才把漏洞找出来。
他解释说,这个软件漏洞会让设备在收到某种特定的错误信息后崩溃,而且每次尝试恢复上线,都会再次崩溃。
更麻烦的是,备用设备跑的是同一套软件,于是也跟着瘫痪了。
5G核心网怎么了?
从Docomo到Orange,故障都发生在5G核心网这个环节。这不由得让人想起,当初业界讨论5G核心网向云原生和服务化架构演进时,就曾提过的一些技术挑战。
一是自动恢复不等于业务恢复。
首起事故过后,Docomo 证实了一件事:虚拟化底座和自动恢复机制在故障期间运转正常,可业务还是中断了 14 小时。
云原生的自愈机制可以重启或迁移异常实例。可如果故障出在应用层业务逻辑、信令上下文状态或网络拓扑层,而编排系统又缺乏对复杂电信业务逻辑的精细化修复能力,就可能出现这样的情况:基础设施和网络功能自动恢复了,端到端业务却迟迟没有恢复。
二是服务化架构带来的依赖复杂度和故障放大风险。
5G核心网把传统网元拆成了模块化的微服务,网络功能之间通过服务化接口互相调用。部署、扩容和演进因此更灵活,但服务发现、授权、超时、重试和状态同步这些依赖关系也随之增多。某个关键网络功能一旦出现延迟或逻辑异常,就可能引发不断重试,让局部异常级联放大。
三是软件同构与冗余失效。
在云原生环境下,主备系统如果运行着完全相同的代码与镜像,就会共享同一个软件故障域。也就是说,同一个软件漏洞会让主用和备用系统一起倒下,冗余机制彻底落空。Orange这次就是如此。
针对这些挑战,业界也提出了相应的架构优化方案和解法。比如让云基础设施与电信业务逻辑深度协同,建立跨网元的全局编排与资源调配机制,并进一步补齐电信级高性能硬件和专有网络协议方面的短板。
Orange 已确认,主备系统是被同一个软件漏洞打穿的。Docomo 公布的第一起事故则牵扯内存异常、信令重传和设备拥塞,后面几起的根本原因至今没有对外说明。这些情况还不足以彻底证实业界当年担忧的那些难题已在现网出现,但至少是个提醒:
虚拟化、自动恢复、主备冗余,这些手段原本都是为了提升核心网的可靠性。可事故真的发生时,它们为什么没能拦住断网?
行业也因此需要正视一个问题:6G核心网若走的是5G核心网的轻量化演进路线,故障隔离、冗余设计和恢复能力就更该在设计之初被摆到更突出的位置。