字节Seed团队:DeepSeek长上下文为何性能漂移

资讯 IT之家 全文 466 字 · 约 2 分钟读完 配图 4 张 分类DeepSeekDeepSeek-V4深度求索字节跳动Deepseek

该研究评估了基础版和后训练版的 DeepSeek-V4-Flash 和 DeepSeek-V4-Pro,以及后训练后的 DeepSeek-V4.1-Flash。

所属频道 大厂动态开源生态

10 月 9 日消息,字节 Seed 团队 9 月底在 arXiv 上挂出一篇论文,讨论分块 KV 缓存压缩引发的相位敏感性,并把矛头指向 DeepSeek“抽风”的根源。

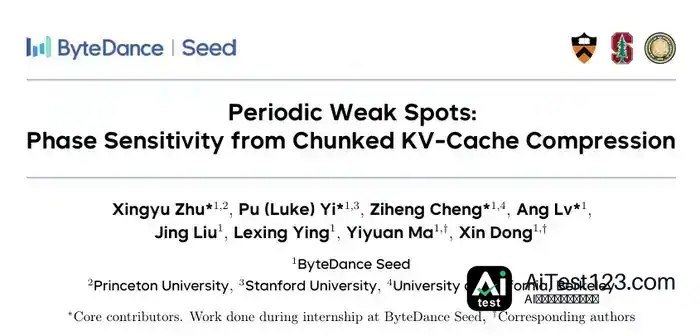
字节Seed团队:DeepSeek长上下文为何性能漂移(配图 1)

这次评估覆盖了 DeepSeek-V4-Flash 和 DeepSeek-V4-Pro 的基础版与后训练版,另外还有后训练后的 DeepSeek-V4.1-Flash。

分块 KV 缓存压缩的做法,是按固定步幅把连续标记的窗口压成更少的缓存条目,借此降低长上下文推理的内存开销和注意力成本。

但压缩同时带来了一个新的位置坐标——Token 的相位,也就是它相对压缩窗口边界所处的位置。
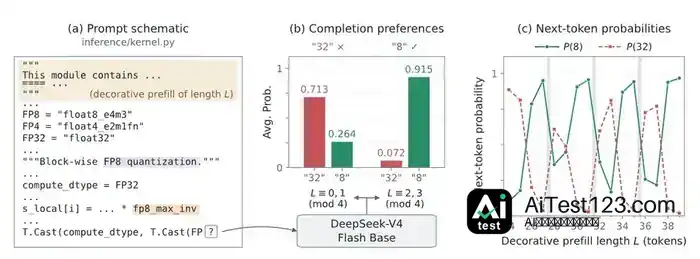
字节Seed团队:DeepSeek长上下文为何性能漂移(配图 2)

团队在用了这种压缩的模型里看到一种系统性的不对称:同一份信息,落在某个阶段就很容易被检索到,落到另一个阶段却很难找出来。他们把这种检索表现的周期性起伏叫作相位敏感性(phase sensitivity)。在采用同类压缩的大型开放权重模型中,长上下文检索准确率在不同阶段之间最多能差 40 个百分点,这也说明平均基准分数背后,可能藏着被掩盖的周期性短板。
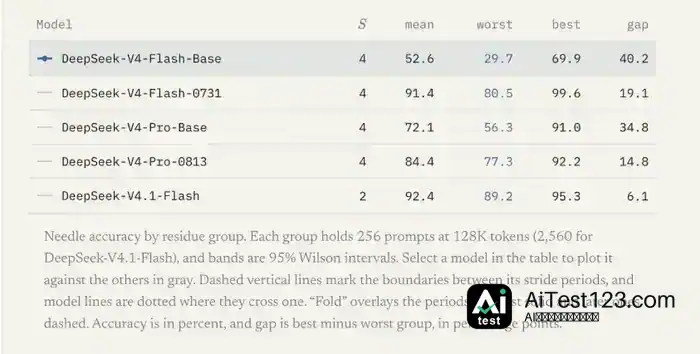
字节Seed团队:DeepSeek长上下文为何性能漂移(配图 3)

论文链接见 IT之家附文。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 字节Seed团队论文:DeepSeek长文本为何时好时坏

    IT之家 10 月 9 日消息,字节 Seed 团队今年 9 月底在预印本平台 arXiv 提交了一篇论文,谈到分块 KV 缓存压缩带来的相位敏感性,直指 DeepSeek“抽风”原因。该研究评估了基础版和后训练版的 DeepSeek-V4-Flash 和 DeepSeek-V4-Pro,以及后训练后的 DeepSee

    来源 腾讯网
  2. 字节Seed团队论文:DeepSeek长文本“抽风”源于相位敏感性

    界面新闻记者 | 江怡曼近日,字节跳动旗下Seed团队发布的最新研究论文,揭示了大语言模型在处理超长文本时出现性能波动的技术原因,直接点明了DeepSeek“抽风”的核心成因。该研究评估了基础版和后训练版的DeepSeek-V4-Flash和DeepSeek-V4-Pro,以及训练后的DeepSeek-V4.1-Fla

    来源 腾讯网
  3. DeepSeek产品部,交给了一个量化交易员

    (本文作者为 超聚焦,钛媒体经授权发布)文 | 超聚焦DeepSeek补票Agent时,曾经的候选人郭达雅已换乘字节。10月16日,DeepSeek成立产品部,将Harness、Web、App、Platform四个团队整合到一起,由拿下过六枚ACM亚洲区域赛金牌但出身量化崔添翼负责,统筹产品、设计和研发。这家曾经以模型

    来源 腾讯网
  4. DeepSeek V4.1 Flash发布:552B MoE模型,API成本再降

    DeepSeek 正式发布 V4.1 Flash 模型,采用全新的非对称 Causal-Encoder-Decoder 架构,总参数量为 552B,输入激活 8B、输出激活 16B。新模型原生支持视觉理解,并通过压缩 KV Cache、优化推理效率和下调 API 价格,进一步降低 AI Agent、编程及长上下文任务的

    来源 AI 实验室动态
  5. DeepSeek V4 Pro为何缺席:新版本仍是Flash?

    你看,这不就对上了,上面的实验里,规律也正好是 4 个 Token 一轮次。 但有意思的是,顺着大伙儿的策略往回看,你会发现,这片江山,其实有不少是 DeepSeek 这条鲸鱼一点点打下来的。 DeepSe…

    来源 搜狐科技
  6. 字节论文点名DeepSeek:多打几个空格,模型答错率飙至71.3%

    DeepSeek 的省钱杀手锏,为何成了致命盲区? 作者丨高允毅 编辑丨岑 峰 同一个问题问 DeepSeek 两次,只是多敲了几个空格,给出的答案居然一个像“天才”,一个像“智障”。 9月底,字节团队的最新论文《Periodic Weak Spots: Phase Sensitivity from Chunked K

    来源 AI 行业观察
  7. DeepSeek长文本为何抽风?字节Seed团队解析AI性能波动

    字节跳动旗下 Seed 团队在最新的研究论文中,揭示了大语言模型在处理超长文本时出现性能波动的技术原因。研究团队指出,这一现象主要源于分块 KV 缓存压缩技术所带来的“相位敏感性”。 关键机制引发检索偏差 该技术为了降低长上下文推理时的内存消耗,会通过固定步幅将连续标记窗口压缩为更少的条目。然而,这种压缩机制引入了一个

    来源 AI 开发者社区
  8. 豆包手机助手遭151款应用拒绝,微信、DeepSeek、淘宝均在列

    151款主流应用集体封堵豆包手机助手的GUI自动化操作权限,腾讯系65款(含微信、王者荣耀)、阿里系23款(含支付宝、高德)、快手系14款、美团系11款,DeepSeek、小红书、各大银行App亦在列,几乎覆盖用户数字生活全部核心场景。所谓“拒绝”并非禁止安装使用,而是禁止AI进行“读屏与模拟点击”的自动化代操作。

    来源 华尔街见闻
  9. 寒武纪回应与DeepSeek合作传闻:芯片主打通用性

    36氪获悉,有投资者向寒武纪提问,今天DeepSeek-V4预览版本正式上线,为什么只提到了昇腾950超节点,而没有提到公司的产品?公司和deepseek是否有实际业务的合作?公司回答表示,公司设计、研发的通用型智能芯片是针对人工智能领域内多样化的应用设计的处理器芯片,对视觉、语音、自然语言处理、传统机器学习技术等各类

    来源 AI 行业观察
  10. DeepSeek开源DeepInfer推理框架:单集群日吞吐155万亿Tokens

    刚刚,DeepSeek宣布,正式开源大规模云服务推理框架 DeepInfer。DeepSeek表示,自身长期致力于将推理性能推向极致。基于 DeepInfer,DeepSeek已实现 DeepSeek V4.1 Flash 高吞吐、低延迟的大规模推理服务。未来,DeepSeek 新模型的推理代码及后续优化也将在此持续更

    来源 TechWeb
  11. DeepSeek登顶全球第一,一场“账单碾压”的胜利

    (本文作者为 影子备忘录,钛媒体经授权发布)文 | 影子备忘录OpenRouter最新一周的数据显示。10月19日到25日,DeepSeek V4.1-Flash-1017以33.6万亿Token的周调用量登顶全球第一,环比增长801%。中国模型包揽前五,周总调用量93.54万亿Token,连续26周压过美国的22.4

    来源 腾讯网
  12. Deedy Das:租GPU卖DeepSeek Token,月入超100万美元?

    在AI大模型的造富神话里,如果你以为只有像OpenAI那样烧掉上百亿美元训练一个超级模型才能赚钱,那你可能错过了当下最隐秘、也最疯狂的财富密码。 近期,硅谷知名风投 Menlo Ventures 的投资人 Deedy Das 揭开了这个隐秘的角落:一批硅谷AI初创公司,正通过一种极为简单粗暴的模式,在短短几个月内实现了

    来源 AI 行业观察
  13. DeepSeek V4.1-Flash-1017登顶周调用量:中国AI包揽全球前五

    最新行业数据显示,上周全球AI大模型总调用量达到188万亿Token,环比增长14.63%。其中,中国AI大模型周调用量为93.54万亿Token,环比增长18.14%,连续二十六周超越美国,稳居全球首位;同期美国AI大模型周调用量则为22.47万亿Token,环比增长29.44%。 从具体的模型表现来看,上周全球调用

    来源 AI 开发者社区
  14. 宁德时代投DeepSeek约1000亿融资,梁文锋帮曾毓群稳住市场

    梁文锋出手,替宁德时代给资本市场递下一颗定心丸。 10月22日,据外媒报道,DeepSeek新一轮融资约1000亿元,宁德时代是主要投资方之一。此前,据媒体报道,宁德体系已在DeepSeek首轮融资中投入约50亿元,成为仅次于腾讯的主要外部投资方。 表面上看,宁德时代给DeepSeek投了钱,利好的是DeepSeek,

    来源 AI 行业观察
  15. DeepSeek开源不到一周:vLLM、SGLang性能反超DeepInfer?

    还得是「源神」D老师,善呐! 自家推理引擎DeepInfer掏出来还不到一周,开源社区就纷纷交上了作业。 真乃一鲸“落”万物生,第一波开源效果已经新鲜出炉: 立志学习DeepSeek、成为DeepSeek、超越DeepSeek。(bushi) vLLM、SGLang这些成熟的推理框架率先迎来T0升级包—— 在各自披露的

    来源 AI 行业观察
向下滚动自动加载更多