

理想马赫M100登台积电OIP:自研芯片如何让智驾更像人
最好的智驾芯片,是让你彻底忘掉它。
买一台车,判断它好不好,很多时候靠的就是直觉。
踩下油门,推背感会告诉你马力够不够;摸一摸中控,指尖会告诉你用料好不好。还有一条更老的招数:开关车门听做工。声音够厚实?那就算好车,简单又直接。
可时代变了,高科技来了,AI 来了,信息大爆炸来了,世界变得复杂又难懂,买车这件事也一样。
就说智驾,挺玄乎的。门店销售往往会热情地报出一串数字:500 TOPS、1000 TOPS……
力大砖飞的道理谁都懂,但说实话,没几个人真在乎算力的具体数值。作为普通消费者,我们想问的其实特别简单:
花好几年、砸几十个亿自研出来的芯片,到底能不能让车开起来更像个人?
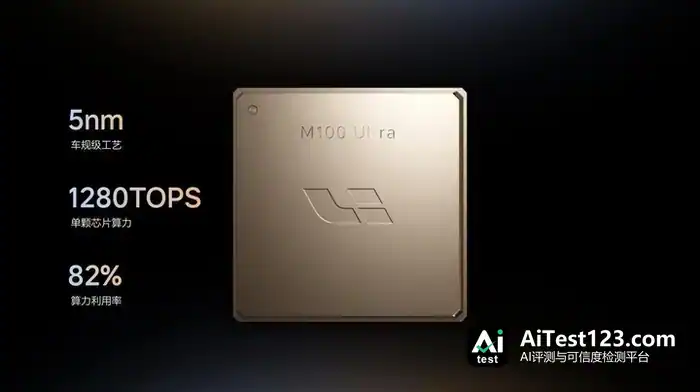
理想认为,这件事能靠自研的「马赫 M100」芯片做成。11 月 17 日,凭着这颗已经量产上车的芯片,理想走进了半导体的「内行局」——台积电 OIP 开放创新平台生态系统论坛。
台积电 OIP 论坛是全球芯片设计、EDA 与先进制程领域规格最高的年度盛会,历来只请全球最顶尖的计算巨头登台。往年坐上特邀演讲席的,是 Google、Meta 的基础设施负责人,或者被称为「硅仙人」的芯片界传奇人物 Jim Keller。
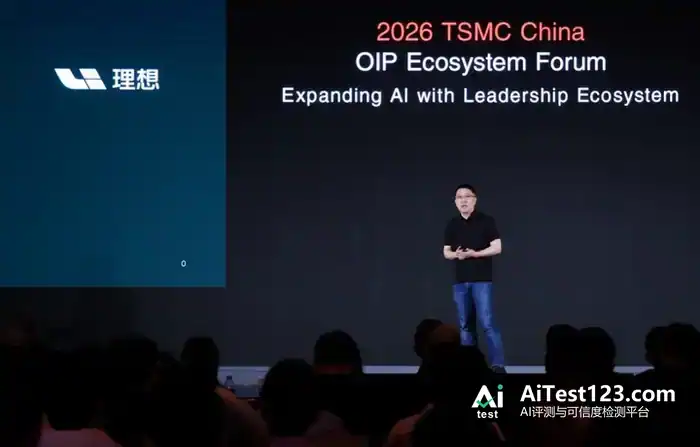
今年和理想汽车同台分享的,同样都是博通、瑞萨电子、SK 海力士这类全球头部芯片企业。理想汽车也由此成为台积电 OIP 生态论坛举办以来,唯一一家进行特邀演讲的中国大陆企业。
不过,比起登台这件事本身,我们今天更想讲清楚的是:理想究竟怎样通过这套底层的芯片架构设计,治好智驾的「犹豫」,让智驾开起来真正更像人?
理想的「厨房变革」
用过智驾的人大概都碰到过这种时刻:账面算力堆得再高,车子一到复杂路口还是可能像个新手,要么对时机把握得不够果决,要么没把路况判断妥当就莽撞操作。
对路况拿捏不准,除了算法模型设计上的局限,很大一部分原因还来自更底层的计算效率。
过去几十年,科技行业一直吃着摩尔定律的红利:芯片制程一升级,软件不用大改就能获得一轮提升。但摩尔定律放缓之后,面对海量并行的 AI 大模型计算,统治计算机界整整 70 年的「冯·诺依曼架构」碰上了棘手的内存效率瓶颈。
在计算机体系结构领域,解释这个被称为「内存墙」的瓶颈,有个很经典的「大厨做菜」比喻:
传统的 CPU 或 GPU 就像后厨里手艺高超的「大厨」,内存则是走廊尽头的「大仓库」。按冯·诺依曼架构的规矩,大厨每切一次菜,都得放下菜刀跑回远处的仓库拿一次配料,切完再跑回去放好。
结果就是,大厨 70% 的时间和体力都耗在了来回跑仓库的路上,真正挥刀做菜的时间,也就是芯片的实际算力利用率,还不到 30%。
在传统软件时代,每次处理的数据量不大,大厨在手边放个「小料台」,也就是高速缓存,就能应付日常小炒。可到了 AI 大模型时代,动辄几十亿的参数和实时涌入的视频流直接把小料台撑爆,大厨不得不频繁往返远处的仓库。
那怎么办?行业里传统的方案是多请几个跑腿的厨师,也就是在传统架构的基础上叠加专用加速单元。
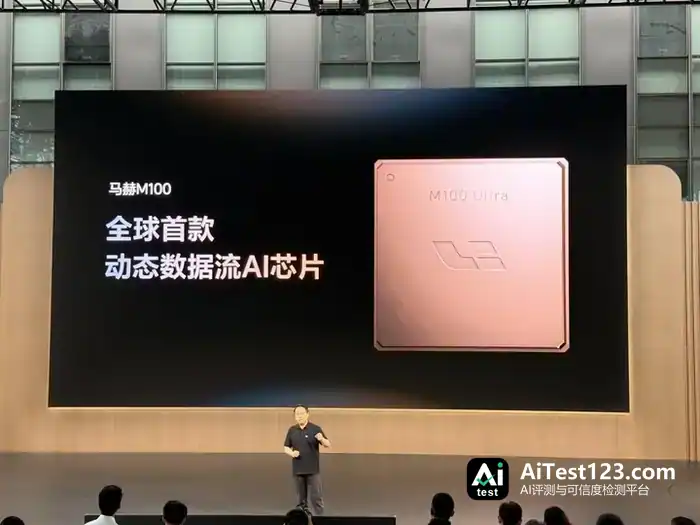
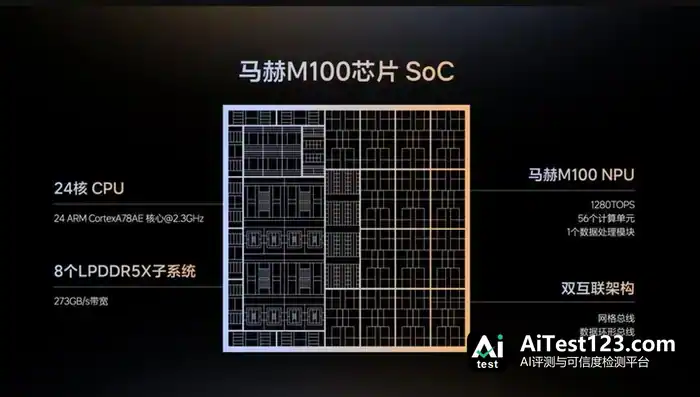
理想选的是对厨房做饭流程进行革新。2022 年立项马赫 M100 时,理想直接拆掉旧厨房,做出了全球首款量产的动态数据流架构 AI 芯片。
理想取消了那个来回跑腿的「总厨」,把整个后厨改造成「中央厨房流水线」。
数据这东西就好比食材,进了工位立刻开做,做好也不往远处仓库送,直接走片内高速通道交给下一道工序;要么就经环形与网格双互联总线,一次分发给下游所有工位一起处理。
与此同时,动态设计又保留了高度的软件可编程性。
固定流水线通常一道菜做到底,马赫 M100 不一样,流水线能按算法随时换新菜谱,软件重新编译一下,工序就灵活调了,效率照样保住,AI 大模型更新换代也有地方施展。
计算机先驱 Alan Kay 有句名言,后来被乔布斯在初代 iPhone 发布会上引用,奉为经典:真正在乎软件的人,应该自己制造硬件。
过去车企面对芯片,处境就像照着菜单点菜的食客——供应商给什么芯片,算法就得迁就什么架构,这是行业里长期存在的普遍状况。理想的做法是打破部门墙,搞「软硬一体联合设计」,把自己变成了掌勺的主厨。在理想内部,算法团队和芯片团队从第一天起就在一起协同工作。
这套量身定制的「后厨」,把端侧 AI 计算的效率上限往上推了一截。马赫 M100 采用 5nm 车规级工艺,单颗算力达 1280 TOPS,在这颗芯片上,算力利用率被拉升到了 82% 以上。
拿它来跑 35B 规模的 Qwen3.5-35B-A3B 模型,预填充速度达到英伟达 DGX Spark 的 2.7 倍,解码速度也达到 1.5 倍。
今年初,马赫 M100 的架构论文与 Google、Meta 的成果一起,入选了全球计算机体系结构最高顶会 ISCA 2026 的工业分区。理想汽车是该分区设立以来全球首家入选的车企,而上一家入选 ISCA 的中国公司,还是 2025 年的 DeepSeek。
算力不再浪费在「跑路」上,靠马赫 M100,理想进一步释放了大模型的执行效率。芯片上省出来的效率,最终落到了路面上的流畅反应。
让车像正常人脑一样「快思考」
诺奖得主卡尼曼在《思考,快与慢》里把思维分成两种:「系统 1」是直觉快思考,瞬间本能反应;「系统 2」是逻辑慢思考,负责深度逻辑推理与复杂博弈。
但人开车的时候,「系统 1」和「系统 2」其实是手眼脑一体、协同工作的。人脑处理信息够快,一边靠直觉对实时路况做出快速决断,一边还能调用经验,也就是「系统 2」,对即将发生的路面状况提前预判。
今天智驾行业拼命卷 VLA(视觉-语言-动作)大模型,图的就是给汽车补上更多「系统 2」的高级推理能力。比如在没有红绿灯的路口提前预判盲区风险,或者在施工路段看懂临时改道的意图。
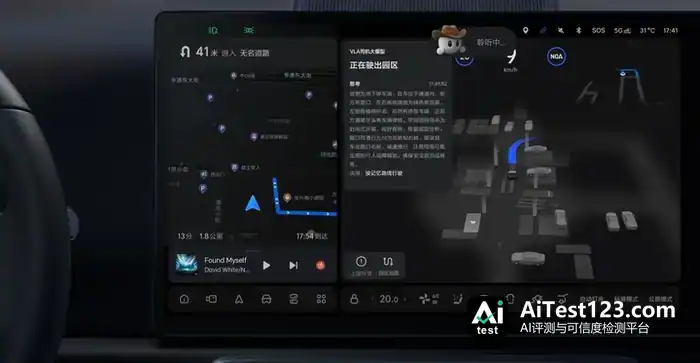
以往智驾对「系统 2」用得不够多,核心原因是算不起、也算不快。传统架构上,模型一旦同时调动复杂的三维空间理解与多步逻辑推演,海量数据搬运就会撞上「内存墙」。车最后是想明白了,可等它算完,路口的通行时机早就错过了。
落到驾驶体感上,就是顿挫、犹豫,以及「无法像人一样思考」。
今年 5 月,马赫 M100 随全新理想 L9 等车型量产上车,横在硬件与算法之间的这堵墙被拆掉了。11 月 6 日推送的 OTA 9.2 版本中,理想正式上线马赫 VLA 2.5,并把自研的原生三维视觉编码器——3D ViT 搬上了车端。
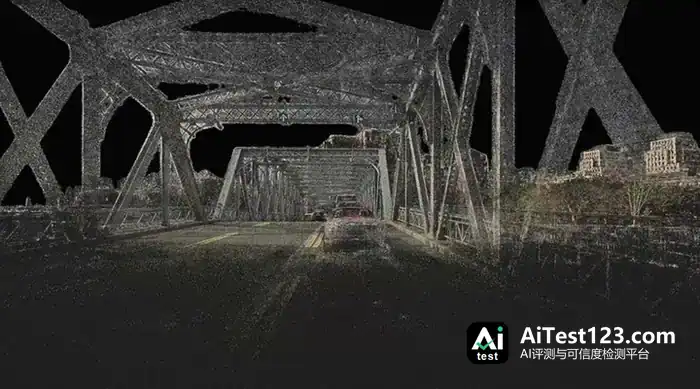
以前的智驾视觉像是「隔着 2D 屏幕看世界」:先在平面画面里认出方框,再去和点云信息做多模块拼接,中间免不了信息损耗与对齐误差。3D ViT 则给了智能汽车一双真正能「看懂」真实三维物理世界的眼睛。
3D ViT 的特点,是在视觉编码阶段就把三维空间几何与语义信息融为一体,空间结构、位置关系和物体类别「一口气从头算到尾,不拆包、不拼接」。这种连续、海量的数据处理方式,恰好是马赫 M100 动态数据流架构「流水线直达」最擅长的活。
你看,自家的厨房果然还是最懂自家人的口味。
依托马赫 M100 的算力底座,3D ViT 引入了前馈式 3DGS 三维高斯泼溅,把道路、建筑等静态环境与车辆、行人等动态物体分开建模,再通过「下一帧预测」的自监督学习持续进化。
感知能力上的变化很直接:车辆前向感知距离拉长到 300 米,拥有等效 1080 线分辨率的像素级感知,动态视力提升 50%。放到每天上下班的路上,这些指标也能让理想辅助驾驶的细节反应更干脆利落。
某种意义上看,理想这套从底层芯片到顶层模型的逻辑,更接近正常人开车时大脑的运作方式:真正厉害的老司机,靠的是手、眼、脑一体配合,要的是「系统 1」与「系统 2」协同——用底层极高的传输效率,把「系统 2」的深度思考跑出「系统 1」般的本能直觉。
在理想的技术体系里,全线控底盘好比手脚,VLA 好比大脑,3D ViT 好比眼睛,马赫 M100 则是那颗持续泵出算力的心脏。
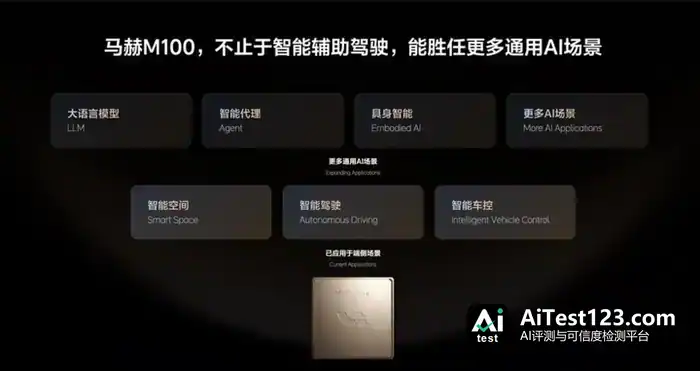
盯上这颗「心脏」和这双「眼睛」的,已经不只是四个轮子上的汽车,具身智能产品同样对上了整套体系。亚马逊当年为了让自家电商大促不再堵在算力上,硬是磨出一套高效的内部云架构,后来对外开放,成了云计算的底座 AWS。马赫 M100 打从一开始就不甘心只做「智驾专用芯片」,它要当的是一颗端侧通用 AI 芯片,大语言模型、Agent、复杂视觉推理都得跑得通。
眼下人形机器人和具身智能这一行,也卡在同一个死结上:电池背不动几百瓦高功耗的传统 GPU,可大模型又必须在端侧实时跑起来。今年 10 月,理想旗下芯片子公司「马赫心」刚做完 16.25 亿元纯股权融资,投后最大估值达到 171 亿元。马赫 M100 芯片、碳化硅模块这些自研核心部件陆续推进对外供应,理想攒了多年的自研家底,也开始在物理 AI 的淘金热里做起了给行业「卖铲子」的生意。
最好的芯片,是被你忘记的那一个
话到这儿,终于可以回头看看开头那个问题了:一辆车浑身上下那么多显性卖点,智驾和芯片为什么偏偏是最难被普通人直接感知的能力之一?
答案就在「不被感知」四个字上——这恰恰是智驾和芯片要奔的终点。「普适计算之父」Mark Weiser 有过一个著名的论断:最深刻的技术,是那些消失的技术,它们将自己编织进日常生活的肌理之中,直到你再也察觉不到它们的存在。
智能汽车也一样。芯片不够聪明、智驾系统算不过来,你才会时不时注意到它的存在;真正顶级的底层技术,生来就是要「隐身」的。
理想费这么大劲自研芯片、站上台积电的讲台,并不只是为了念叨「动态数据流」或者「1280 TOPS」这些参数和名词。说到底,核心目标只有一个:让你握住方向盘的那一刻,彻底忘掉芯片的存在。













