语音转文字
上传音频或录音后自动转写成文本,适合会议记录、采访录音、课程听写这类场景,省去逐句回放打字的时间。
 AiTest123.comAI 评测与可信度检测平台
拖动滑块完成拼图,通过后发送验证码
独立第三方 AI 评测平台 · 只用实测数据
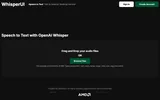
WhisperUI 是一个把 OpenAI Whisper 语音识别能力搬到网页上的轻量工具,主打语音转文字,同时提供文字转语音,定位是低成本、免安装的听写与配音入口。它的好处是不用自己申请 API、不用写代码,打开浏览器上传音频或输入文本即可得到结果;短板也很明显——能力上限取决于上游模型,遇到多人对话、强口音或专业术语时转写质量会打折,且定价、额度与商用授权都没有公开说明,批量使用前只能自己试探。
WhisperUI 是一个基于 OpenAI Whisper API 的在线语音处理工具,做两件事:把音频转成文字,以及把文字合成语音。它面向不想折腾本地环境的人——记者整理录音、学生转写课堂内容、内容创作者给视频配音,都可以直接在浏览器里完成,不需要装软件或自己接 API。
它的核心卖点是把 Whisper 的识别能力包装成「上传即可用」的界面。Whisper 本身对常见口音的英语及多语种识别表现稳定,WhisperUI 相当于省去了申请密钥、写调用脚本这两步,降低了使用门槛。
对不同角色用法不同:普通用户拿它做单次转写或短句配音;需要反复处理素材的人则更关心批量上传和导出格式是否顺手;开发者如果只是临时验证效果,用它比自建服务快得多,但真正要嵌入产品时,还是要走官方 API。
上传音频或录音后自动转写成文本,适合会议记录、采访录音、课程听写这类场景,省去逐句回放打字的时间。
把输入的文本合成为可播放的语音,用于旁白草稿、视频配音试听,先确认语气和节奏再决定是否正式录制。
全程在网页内完成,不需要下载客户端或配置本地环境,换一台电脑也能接着用,适合临时性的处理需求。
底层调用 OpenAI Whisper,但用户不必自己注册开发者账号、申请密钥和写调用代码,对非技术用户友好。
依托 Whisper 的模型能力,可处理中文、英文等常见语言的音频,混说或口音较重时识别质量会明显下降。
当你要处理零散的录音、需要一个打开就能用的转写或配音入口时,WhisperUI 省掉了自己接 API 的麻烦,适合先验证效果再决定要不要深入。但如果你要做的是成批量的音频处理、需要稳定的商用授权,或者对转写准确率有硬指标,就不该把希望寄托在一个封装层上——它本质是调用上游模型,能力上限和计费规则都由别人决定。
采访录音转文字能省下大量回放打字时间,但人名、地名和专业术语容易出错,发稿前必须逐句核对。
把课堂录音或讲座音频转成文字方便复盘,长音频建议切开处理,避免一次转写卡住或质量不稳。
可用于旁白试听和字幕底稿,但音色和情感表现有限,正式成片仍建议真人配音或专业配音服务。
缺少公开的批量接口与吞吐说明,任务量大时排队、限流和稳定性都无法预估,不适合直接接入生产流程。
音频需经第三方接口处理,数据留存与合规说明未公布,医疗、法律、金融等场景使用前需自行评估风险。
差别主要在省事。自己调用要注册开发者账号、申请密钥、写调用脚本并处理音频格式,WhisperUI 把这些步骤收进网页界面,上传或输入即可出结果。代价是你拿不到参数调优和批量控制的空间,处理流程和可用性都由服务方决定。
常见普通话、环境安静的录音识别结果基本可用,但人名、地名、专业术语和数字容易出现偏差,方言、口音较重或多人抢话时错误率会明显上升。实际使用时建议转完通读一遍,重点核对这几类词再对外使用。
商用授权范围没有公开说明,这一点关系到能不能直接用于客户交付或商业发布。如果转写内容会对外使用,使用前应先确认授权与数据留存政策,否则可能留下合规隐患。
适合做草稿和试听。用来确认旁白的节奏、断句和大致长度效率很高,改稿成本低;但情感起伏、重音和呼吸感都比不上真人,正式成片、广告或品牌内容仍建议用真人或专业配音服务。
以网页形式提供,不需要安装客户端,电脑浏览器打开即可使用。这也意味着它对网络有依赖,录音和文件都需要在联网状态下上传处理,离线环境无法使用。